背景介绍
随着短视频、播客等音视频内容的爆发式增长,快速将音视频内容转换为文字的需求也越来越大。无论是内容创作者需要的字幕,还是企业需要的会议记录,都需要一个可靠的语音转文字解决方案。
技术架构
本项目采用双引擎架构,结合了两个优秀的开源语音识别模型:
- Vosk:专注于离线场景,适合本地快速处理
- Whisper:OpenAI 开源的强大模型,支持多语言识别
核心特性
-
多语言支持
- 中文识别:适配中文语音特点
- 英文识别:准确度高
- 其他语言:支持通过 Whisper 识别
-
多格式支持
- 视频格式:MP4、MOV
- 音频格式:WAV(自动转换)
-
智能输出
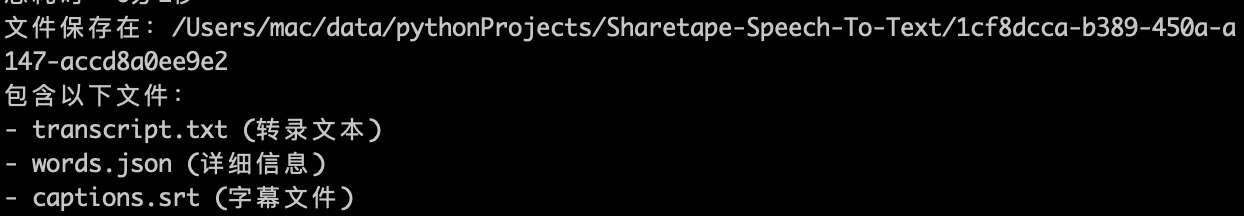
- 纯文本:适合阅读和编辑
- JSON:包含时间戳和置信度
- SRT:标准字幕格式
技术优势
-
双引擎协同
- Vosk:本地处理,无需网络
- Whisper:高准确率,多语言支持
-
智能分段
- 自动切分长音频
- 智能合并结果
- 内存优化处理
-
灵活配置
- 多种模型可选
- 性能与准确度平衡
- 适应不同硬件配置
项目下载地址及使用说明
实践应用
场景示例
-
内容创作
- 视频字幕生成
- 播客内容转录
- 直播回放整理
-
商业应用
- 会议记录自动化
- 培训视频转文字
- 客服对话记录
-
个人使用
- 学习笔记转录
- 语音备忘录
- 采访内容整理
本地性能测试
-
中英混合音频(34秒)
- Medium模型 + 中文模式:5分13秒
- Medium模型 + 自动检测:2分12秒
-
纯中文音频(3分钟)
- Base模型:28秒
- Medium模型:2分8秒
优化建议
-
模型选择
- 短音频:tiny/base
- 一般用途:base/small
- 高要求:medium/large
-
硬件推荐
- 8GB内存:tiny/base
- 16GB内存:small/medium
- 32GB内存:large
项目展望
未来规划
-
功能增强
- 实时转录支持
- 多声道分离
- 说话人识别
-
性能优化
- GPU加速支持
- 并行处理优化
- 压缩算法改进
-
生态建设
- API接口完善
- 插件系统支持
- 社区版本维护
总结
本项目通过整合 Vosk 和 Whisper 两大开源语音识别引擎,为用户提供了一个功能强大、使用灵活的音视频转文字解决方案。无论是个人用户还是企业用户,都能找到适合自己需求的使用方式。