写在前面:文章写得比较早,如果面试官问起deepseek的知识,请看笔者另一篇。本篇主要是讲一些泛化的AI概念,也是笔者自己学习+整理的。如有不足还望海涵。
1. 人工智能AI学科 ➡ 分支:机器学习ML
其中,深度学习DL是ML中的一种算法,功能是模拟大脑。它分为输入层,隐藏层,输出层。隐藏层在训练时不断修正(修正依赖反向传播)模型权重(参数数量)和模型偏置
(图源见右上角水印)
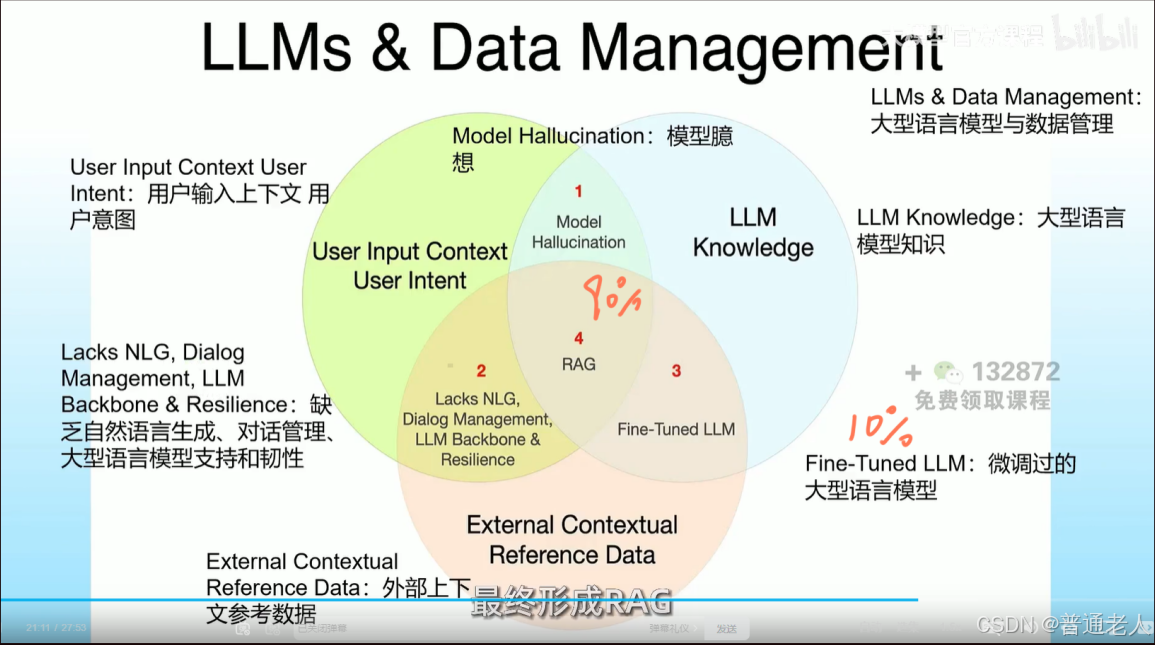
2. 机器学习ML:
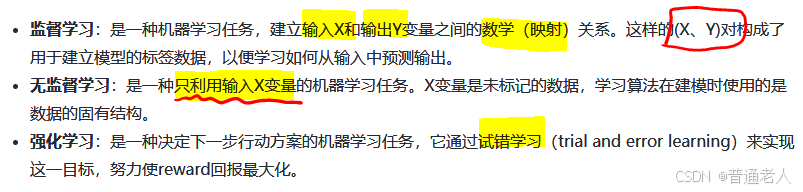
- 监督:需要大量参数。在监督学习中常见的机器学习任务包括分类和回归
- 无监督:鼓励式
- 强化:奖励机制反馈
3. 深度学习DL:
相比起ML,DL优化了数据分析,建模过程的流程也缩短了。神经网络:
- 分类:CNN卷积神经网络(常用于自动驾驶), RNN循环神经网络
- 传播方式:前向传播,反向传播
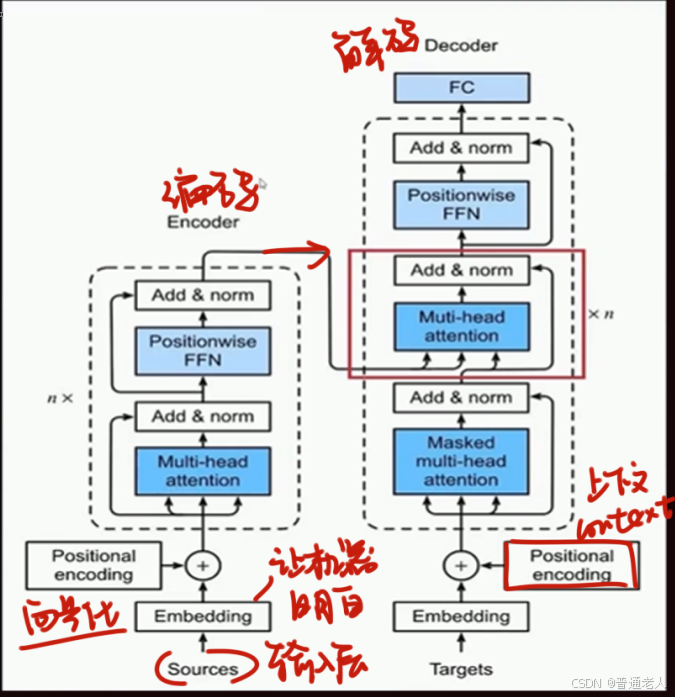
- 架构:transformer框架(GPT在用)
4. transformer框架
5. 提示词工程:改进交互方式高效与AI沟通
- AI Agent与AI模型通信如何实现:
方法一:System prompt:定义AI的角色、性格、背景信息、语气
方法二:Function Calling:json统一输入输出格式
6. 大模型的分类:大模型本质上是概率模型
- 大语言模型Large Language Model:专注于NLP,比如GPT,常用transformer框架
- 多模态模型:未来趋势,计算机视觉,音频处理,视频处理
7. 训练大语言模型
步骤一:预训练 pre-training(transformer框架)
通过自监督学习捕捉数据分布
步骤二:SPT:监督与微调 fine-tuning
微调实现对预训练的模型进一步训练以便更适应特定环境,提高模型在特定任务的表现
到这一步只能满足价值观,无道德
步骤三:RLHF:可干预、基于人类反馈的强化学习
满足人类价值观,有道德
8. 工作流程
步骤一:分词化Tokenization与词表映射
步骤二:文本生成过程:预测下个token,这个token也加入序列预测,直到结束(自回归), 涉及预测推理何时结束/到达阈值结束
9. 自然语言处理NLP
人工智能一个重要分支,用于解决与语言相关的各种问题,包括机器翻译、语音识别、情感分析、聊天机器人
10. 知识库
与LLM结合用的数据库
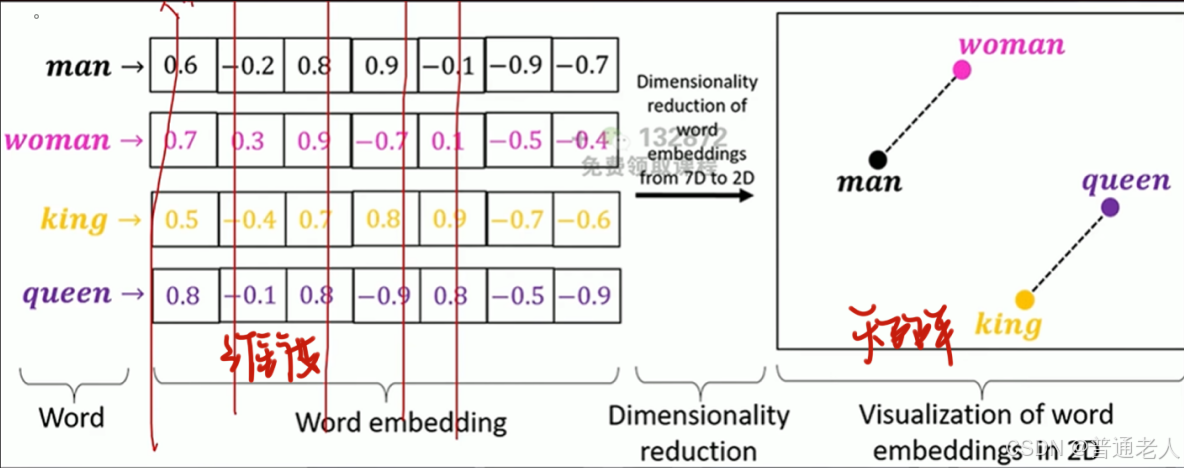
11. 嵌入 Embedding 即向量化,矢量化
将数据转换为数值向量的过程,将每文本项表示为一个较低维度的稠密向量,但仍保持关键信息,使语义上相似的词在向量空间中彼此接近
存起来的地方叫向量数据库
12. AI Agent智能体:基于LLM的、能完成具体工作、不止是能查数据的、智能体
比如AGI:通用人工智能
-
工作流程:LLM输入、思考➡记忆➡规划➡行动➡工具(外接计算器等API)➡Agent
- 记忆:通过深度学习、梯度下降技术,进而形成记忆
- Tools:预制工具,自定义工具
- Toolkits:做好的工具集
- 规划:分解为子任务+反思与改进
- 分解为子任务:通过LLM+提示词工程赋予这种思维,需要思考如何生成和审视已有工具
- 分为思维链(prompt技术)和思维树(启发式,BFS,DFS,前瞻回溯)
- 反思与改进:三思而后行
- ReAct模型:结合Reason与Act,LLM首先基于已有知识,审视工具,当发现已有知识不足以回答问 题,则调用工具,基于新的信息重复推理与行动,直到完成
- 记忆:通过深度学习、梯度下降技术,进而形成记忆
-
决策流程:观察➡感知➡规划➡行动(然后又回头到观察),这样一个循环代表一个任务
13. AI行业未来挑战:
- 数据隐私保护
- 技术依赖性
- 人机互动
14. 检索增强生成Retrieval-Augmented Generation
结合信息检索与生成式语言模型,提高生成式模型的准确和相关性
- 检索:从外部知识库查找相关信息
- 生成:利用生成式语言模型GPT将检索到的信息整合到生成的回答中
15. 生成式语言模型
能生成自然语言文本的AI Model,是连贯有意义的句子或段落
16. MCP
把公共Tool集中到一个MCP Server上,将AI Agent作为MCP Client,多个客户用一个服务
17. 实例介绍:Langchain架构
由通用大模型+特定知识库+数据分析构建而成
原理:
- 数据输入:去除无用符号,清洗句子
- 数据分析:使用分析引擎,引擎的工作如下
- 算法:文本分类模型,情感分析模型,主题建模
- 过程:准备,选算法,微调
- 数据输出:形式有图表、文字、互动界面等
18. 实例介绍:ChatGLM对话语言模型
基于通用语言模型,和chatgpt类似
19. 自注意力机制self-attention mechanism
- Transformer架构核心组件,广泛用于NLP、CV和多模态,核心是让模型动态计算输入序列中不同位置的关联性,从而捕捉长距离依赖关系
- 计算输入序列中每个元素与其它所有元素的相关性(即注意力权重)生成一个加权表示
- 使用多头注意力捕捉不同子空间的语义信息
- 优点:长距离依赖、并行计算、可解释性
20. 生成式预训练模型
- 通过大规模无监督预训练学习通用表征,再通过微调或提示适应下游任务的模型
- 特点是预训练+微调范式,先在通用数据上训练,再针对具体任务调整
21. 推理reasoning
模型基于已有知识进行逻辑推理、因果分析的能力。体现为隐式推理和显式推理
- 隐式推理:预训练内化的知识,比如常识,直接有答案
- 显式推理:思维链、思维树等,需要推理或工具辅助的
22. PyTorch和TensorFlow是目前最主流的两个深度学习框架
PyTorch:在学术界占主导地位,适合学术研究,小规模项目,NLP/CV前沿模型
python
import torch
import torch.nn as nn 神经网络模块

# 定义模型
class Net(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc = nn.Linear(10, 1)  # 10维输入 -> 1维输出

    def forward(self, x):
        return torch.sigmoid(self.fc(x))

# 训练循环
model = Net()
optimizer = torch.optim.Adam(model.parameters()) 优化器
loss_fn = nn.BCELoss()

x = torch.randn(32, 10)  # 输入数据
y = torch.randint(0, 2, (32, 1)).float()  # 标签
output = model(x)

loss = loss_fn(output, y)
loss.backward()  # 反向传播
optimizer.step()
TensorFlow:工业级部署,大规模生产环境,企业级应用
python
import tensorflow as tf

# 定义模型
model = tf.keras.Sequential([
    tf.keras.layers.Dense(1, input_shape=(10,), activation='sigmoid')
])

# 编译与训练
model.compile(optimizer='adam', loss='binary_crossentropy')
x = tf.random.normal((32, 10))
y = tf.random.uniform((32, 1), 0, 2, dtype=tf.float32)
model.fit(x, y, epochs=10)