来了来了,新的需求又双叒叕来了,在设计的逗号分割的集合中对值进行查重
通过前两篇文章,我们已经可以简单的实现查询、批量查询、 剔除值等功能
前置
假设表"scrm_customer"
| id | mobile | other |
|---|---|---|
| 1 | 155xxx8,171xxx2,187xxx6 | null |
| 2 | 155xxx8 | null |
| 3 | 155xxx9 | null |
| 4 | 187xxx6 | null |
我们对该表进行查重 获取到重复的手机号
分析
假如我们的mobile不是,号分割的列,如何进行获取重复
我们可以通过 group by 对mobile进行分组,然后HAVING COUNT(mobile) > 1的
cpp
select mobile from scrm_customer c GROUP BY c.owner_id HAVING COUNT(mobile) > 1我们获取到单表的重复项如此简单,那么,能否将mobile的值展开,然后进行HAVING COUNT(mobile) > 1
实现
第一步,获取到整表中单条数据的手机号最大数量
cpp
SELECT MAX((LENGTH(i.mobile) - LENGTH(REPLACE(i.mobile, ',', '')))) + 1 maxNub FROM scrm_customer i第二步, 构建WITH RECURSIVE 数字方案
cpp
WITH RECURSIVE numbers AS (SELECT 1 AS n UNION ALL SELECT n + 1 FROM numbers WHERE n < 6)
-- 得出传入的每一个值
SELECT n FROM numbers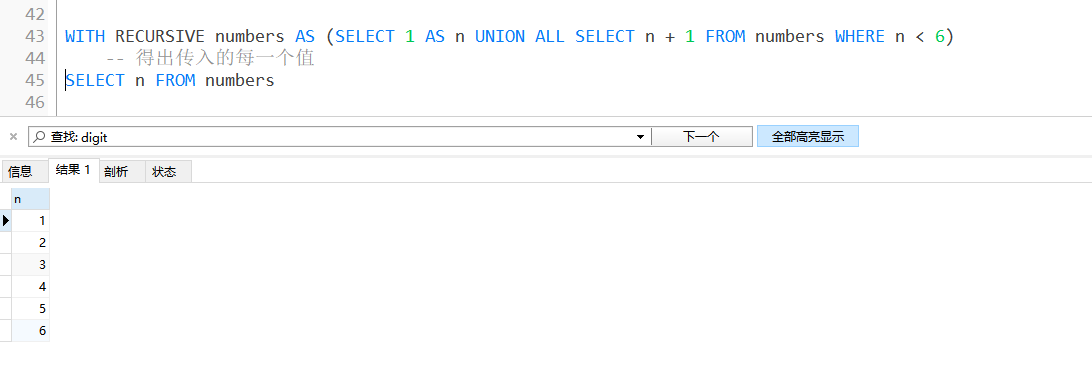
我们将6替换成我们查询出来最大的手机号数量
第三步,使用CROSS JOIN 将原表将手机号的155xxx8,171xxx2,187xxx6拆分成三条数据,同时也会将单手机号的拆成三条
sql
SELECT
	-- 通过 CROSS 对mobile进行截取,如果超过则取最后一个数值
    SUBSTRING_INDEX(SUBSTRING_INDEX(i.mobile, ',', n.n), ',', -1) AS new_mobile
FROM
    scrm_customer i
CROSS JOIN
	-- 第一步获取到的最大数量并拆成n条数据
    (WITH RECURSIVE numbers AS (SELECT 1 AS n UNION ALL SELECT n + 1 FROM numbers WHERE n < (SELECT MAX((LENGTH(i.mobile) - LENGTH(REPLACE(i.mobile, ',', '')))) + 1 maxNub FROM scrm_customer i))
		SELECT  * FROM numbers) n
CROSS JOIN 是两个表关联的笛卡尔积,在其他地方慎用喔
SUBSTRING_INDEX:
cpp
SUBSTRING_INDEX(str, delim, count)参数说明
str: 要处理的字符串。
delim: 分隔符,用于分割字符串。
count: 指定要提取的子字符串的索引。可以是正数或负数。
如果 count 是正数,SUBSTRING_INDEX 返回字符串中第 count 次出现分隔符之前的所有内容。
如果 count 是负数,SUBSTRING_INDEX 返回字符串中倒数第 count 次出现分隔符之后的所有内容。
我们可以写个例子试试
cpp
select SUBSTRING_INDEX("1,22,333,4444,55555,666666", ',', 3) nu1,
SUBSTRING_INDEX(SUBSTRING_INDEX("1,22,333,4444,55555,666666", ',', 3),',',2) nu2,
SUBSTRING_INDEX(SUBSTRING_INDEX("1,22,333,4444,55555,666666", ',', 3),',',-1) nu3
from dual;
将我们查出来的笛卡尔积进行处理,将id和mobile都是相同的数据排除出去,最终就是我们想要的mobile的展开数据
最简单的办法GROUP BY new_mobile,i.id
sql
SELECT
	-- 通过 CROSS 对mobile进行截取,如果超过则取最后一个数值
    SUBSTRING_INDEX(SUBSTRING_INDEX(i.mobile, ',', n.n), ',', -1) AS new_mobile
FROM
    scrm_customer i
CROSS JOIN
	-- 第一步获取到的最大数量并拆成n条数据
    (WITH RECURSIVE numbers AS (SELECT 1 AS n UNION ALL SELECT n + 1 FROM numbers WHERE n < (SELECT MAX((LENGTH(i.mobile) - LENGTH(REPLACE(i.mobile, ',', '')))) + 1 maxNub FROM scrm_customer i))
		SELECT  * FROM numbers) n
GROUP BY new_mobile,i.id
到这一步,我们已经获取到展开后的数据了,就可以用HAVING COUNT(mobile) > 1进行查重了
sql
SELECT new_mobile FROM (
		SELECT
			-- 通过 CROSS 对mobile进行截取,如果超过则取最后一个数值
		    SUBSTRING_INDEX(SUBSTRING_INDEX(i.mobile, ',', n.n), ',', -1) AS new_mobile
		FROM
		    scrm_customer i
		CROSS JOIN
			-- 第一步获取到的最大数量并拆成n条数据
		    (WITH RECURSIVE numbers AS (SELECT 1 AS n UNION ALL SELECT n + 1 FROM numbers WHERE n < (SELECT MAX((LENGTH(i.mobile) - LENGTH(REPLACE(i.mobile, ',', '')))) + 1 maxNub FROM scrm_customer i))
				SELECT  * FROM numbers) n
		GROUP BY new_mobile,i.id
		) t
		GROUP BY t.new_mobile
HAVING COUNT(t.new_mobile) > 1
到此,我们就得到的我们想要的重复手机号啦
最后
唉!真是被这种逗号分割的集合害惨了,真是接了个烂摊子,去改造表吧,又催,里边的东西又多,梳理代码的时间比想办法解决的时间要长的多,就只能凑合用了,干死n多脑细胞,AI给的方法,基本不怎么能用
有更佳方案或者新奇想法的同学可以分享一下。
该文章为原创,未经允许禁止转载,谢谢