本章内容
- 使用运行在 Kubernetes 集群中的云原生应用
- 在本地与远程 Kubernetes 集群之间进行选择
- 了解主要组件和 Kubernetes 资源
- 理解使用云原生应用时所面临的挑战
当我想尝试一些新东西,比如一个框架、一种新工具,或者只是一个新应用时,我往往比较急躁;我希望它能立即运行起来。然后,当它运行起来后,我想深入了解它的工作原理。我会破坏一些东西来实验,从而验证自己是否理解这些工具、框架或应用的内部工作机制。这正是我们本章要采取的方法!
要让一个云原生应用正常运行,你需要一个 Kubernetes 集群。在本章中,你将使用一个叫做 KinD(Kubernetes in Docker, kind.sigs.k8s.io/)的项目,在本地搭建 Kubernetes 集群。这个本地集群将允许你在本地部署应用,用于开发和实验。为了安装一套微服务,你将使用 Helm,这个项目可以帮助打包、部署和分发 Kubernetes 应用。你将安装第一章中介绍的 walking skeleton 服务,它实现了一个会议应用(Conference application)。
一旦会议应用的服务运行起来,你将使用 kubectl 检查其 Kubernetes 资源,从而理解应用的架构和内部工作机制。在了解了应用内部主要组件后,你将尝试"破坏"应用,找出云原生应用可能面临的常见挑战和陷阱。本章涵盖了在基于 Kubernetes 的现代技术栈中运行云原生应用的基础知识,并重点说明了开发、部署和维护分布式应用所带来的利与弊。后续章节将通过研究旨在加速和提高项目交付效率的项目,来解决这些相关挑战。
2.1 运行我们的云原生应用
为了理解云原生应用固有的挑战,我们需要能够用一个可控、可配置、可破坏的简单示例来进行实验。在云原生应用的上下文中,"简单"不能只指单一服务,因此即使是简单应用,我们也需要处理分布式应用的复杂性,例如网络延迟、部分服务的故障恢复能力以及最终一致性。
要运行云原生应用(此处指第一章介绍的 walking skeleton),你需要一个 Kubernetes 集群。开发者首先会关心这个集群将安装在哪里,谁负责搭建它。开发者通常希望在本地运行,也就是在笔记本或工作站上,而 Kubernetes 支持这种方式------但它是最优选择吗?下面我们分析本地集群与其他选项的优缺点。
2.1.1 为你选择最佳的 Kubernetes 环境
本节不涵盖所有 Kubernetes 发行版,而是聚焦于 Kubernetes 集群如何被配置和管理的常见模式。有三种可选方案,每种都有优缺点:
1. 在笔记本/台式机上运行本地 Kubernetes
我倾向于不建议在笔记本上运行 Kubernetes。正如本书后续内容将展示的那样,建议在与生产环境类似的环境中运行软件,以避免"在我的笔记本上可以运行"的问题。这类问题主要源于本地运行 Kubernetes 并非在真实的多机集群之上运行,因此没有真实的网络往返,也没有真正的负载均衡。
- 优点:轻量、启动快,适合测试、实验和本地开发;适合运行小型应用
- 缺点:不是真实集群,行为不同,硬件资源有限,无法运行大型应用
2. 数据中心内部署的 on-premise Kubernetes
这是拥有私有云的公司常用的方案。该方式要求公司拥有专门团队和硬件来创建、维护和操作集群。如果公司足够成熟,可能会有自助平台,允许用户按需申请新的 Kubernetes 集群。
- 优点:真实集群运行在真实硬件上,更接近生产环境的行为;可以清楚地了解应用环境中可用的功能
- 缺点:需要成熟的运维团队来搭建集群并提供凭证;需要专用硬件供开发者进行实验
3. 云提供商的托管 Kubernetes 服务
我更倾向于这种方式,因为使用云提供商服务可以按需付费。像 Google Kubernetes Engine(GKE)、Azure AKS 和 AWS EKS 都采用自助服务模式,使开发者可以快速创建新的 Kubernetes 集群。主要考虑因素有两点:
- 你需要选择一个云提供商,并拥有可支付团队消耗费用的大额信用卡。这可能涉及预算上限和访问权限的设定。如果不小心,可能会产生供应商锁定问题
- 所有操作都是远程的,对于习惯本地工作的开发者和团队,这是一种较大的改变。开发者需要时间适应,因为工具和大部分工作负载都在远程运行。这也是一个优势,因为开发者的环境和部署的应用会表现得像在生产环境中运行一样
- 优点:使用真实(完整)集群;可按任务定义所需资源,用完后释放;无需预先投资硬件
- 缺点:可能需要大额信用卡;开发者需在远程集群和服务上工作
最后建议查看以下仓库,其中列出了主要云提供商提供的免费 Kubernetes 额度:github.com/learnk8s/fr...。我创建此仓库是为了保持这些免费试用的最新列表,方便你在真实基础设施上运行书中的所有示例。
图 2.1 总结了以上各点的信息。
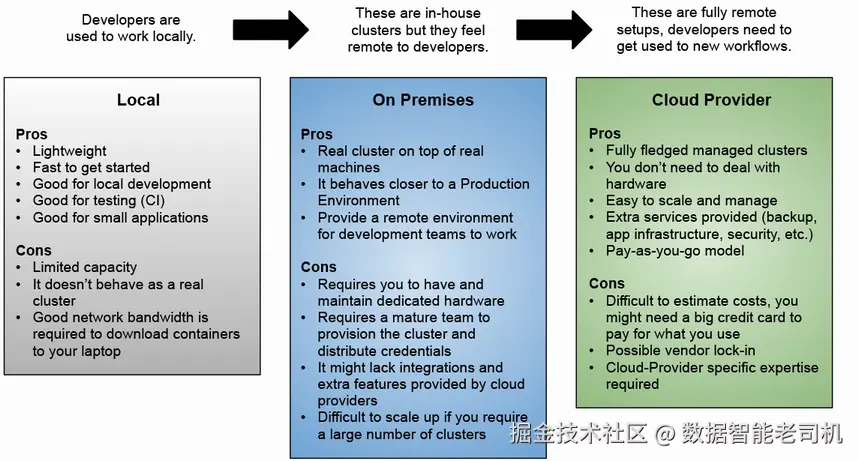
虽然这三种选项都是可行的,但各有利弊,在接下来的章节中,你将使用 Kubernetes KinD(Kubernetes in Docker,kind.sigs.k8s.io/)在本地 Kubernetes 环境中部署第一章介绍的 walking skeleton(运行在你的笔记本/PC 上)。请参考逐步教程:github.com/salaboy/pla...,按照教程创建本地 KinD 集群,我们将使用该集群来部署我们的 walking skeleton,即会议应用(Conference application)。
请注意,教程创建的本地 KinD 集群模拟了拥有三个节点的环境,并配置了特殊端口映射,以便我们的 Ingress 控制器能够将我们发送到 http://localhost 的流量路由到集群中。
2.1.2 安装 walking skeleton
要在 Kubernetes 上运行容器化应用,你需要将每个服务打包为容器镜像,并定义这些容器在 Kubernetes 集群中如何运行和配置。为此,Kubernetes 允许你使用 YAML 文件定义不同类型的资源,来配置容器的运行方式及它们之间的通信。最常见的资源类型包括:
- Deployments(部署) :声明式定义你的应用需要运行多少个容器副本才能正常工作。部署还允许我们选择要运行哪些容器,以及这些容器如何配置(通过环境变量)。
- Services(服务) :声明式定义一种高层抽象,用于将流量路由到部署创建的容器中,同时作为副本之间的负载均衡器。服务使集群内的其他服务和应用能够通过服务名称而非容器的物理 IP 地址进行通信,这就是所谓的服务发现。
- Ingress(入口) :声明式定义从集群外部路由流量到集群内部服务的路径。通过 Ingress 定义,我们可以将集群外运行的客户端应用所需的服务暴露出来。
- ConfigMap / Secrets(配置与密钥) :声明式定义并存储配置对象,用于设置服务实例。Secrets 被视为敏感信息,需要受保护访问。
对于拥有数十或数百个服务的大型应用,这些 YAML 文件会非常复杂且难以管理。通过 kubectl 应用这些文件来跟踪变更和部署应用会是一项复杂的工作。本书不涵盖这些资源的详细视图,如需了解更多,可参考 Kubernetes 官方文档:kubernetes.io/docs/concep...。在本书中,我们将重点介绍如何处理大型应用的这些资源,以及可以帮助我们管理这些任务的工具。
打包与安装 Kubernetes 应用
管理 Kubernetes 应用有多种工具。通常,这些工具可以分为两类:模板引擎(templating engines)和包管理器(package managers)。在实际场景中,你很可能需要两类工具来完成任务。下面我们来讨论这两类工具:为什么需要模板引擎?你想管理哪种类型的包?
模板引擎允许你在不同环境中重用相同的资源定义,而应用可能在不同环境中需要稍微不同的参数。最典型的例子是数据库 URL。如果你的服务在不同环境中需要连接不同的数据库实例,例如测试环境的测试数据库和生产环境的生产数据库,你不希望维护两个几乎相同但 URL 不同的 YAML 文件。
图 2.2 展示了如何向 YAML 文件中添加变量,模板引擎会根据你最终使用的环境,将这些变量替换为不同的值,从而生成最终的资源定义(rendered resource)。
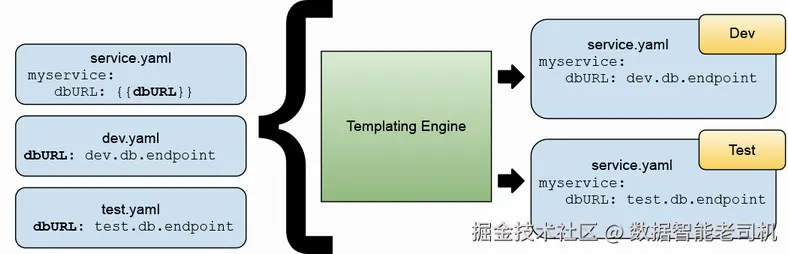
使用模板引擎可以帮你节省大量维护多个相同文件副本的时间,因为当文件堆积起来时,维护它们几乎会变成一份全职工作。社区中有许多工具可以处理 Kubernetes 文件的模板化问题。有些工具只是处理 YAML 文件,而有些工具则更专注于 Kubernetes 资源本身。你可以关注的一些项目包括:
- Kustomize : kustomize.io/
- Carvel YTT : carvel.dev/ytt/
- Helm Templates : helm.sh/docs/chart_...
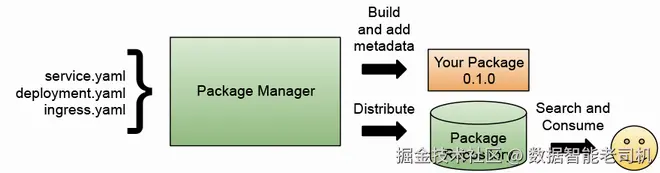
那么,这些文件该如何管理呢?一种很自然的做法是将这些文件按逻辑打包。如果你构建的应用由多个服务组成,把与某个服务相关的所有资源放在同一目录下,甚至与该服务的源代码在同一个仓库中,是很合理的。你还希望能够将这些文件分发给在不同环境部署这些服务的团队,同时你会很快意识到,需要对这些文件进行版本管理。这种版本管理可能与服务本身的版本相关,也可能与应用层面的一种高层逻辑聚合相关。当我们谈论对这些资源进行分组、版本控制和分发时,我们实际上是在描述包管理器(package manager)的职责。
开发人员和运维团队已经习惯使用包管理器,无论技术栈如何。例如 Java 的 Maven/Gradle、NodeJS 的 NPM、Linux/Debian/Ubuntu 的 APT-GET,以及近年来云原生应用的容器和容器仓库。那么,YAML 文件的包管理器是什么样的呢?它的主要职责是什么?
从用户的角度来看,包管理器允许你浏览可用的包及其元数据,以决定要安装哪个包。一旦决定使用某个包,你应该能够下载并安装它。安装完成后,作为用户,你希望在新版本发布时能够升级包。升级包需要手动干预,也就是说,你必须明确告诉包管理器将某个包升级到更新(或最新)版本。
从包提供者的角度来看,包管理器应该提供创建包的规范和结构,以及一个打包工具,用于打包你想分发的文件。包管理器需要处理版本和依赖关系,也就是说,如果你创建了一个包,必须给它指定版本号。一些包管理器采用语义化版本(semver)方式,用三个数字描述包的成熟度(如 1.0.1,分别表示主版本、次版本和修订号)。包管理器不一定需要提供集中式的包仓库,但通常都会提供。
集中式包仓库负责托管供用户使用的包。这类仓库很有用,因为它能为开发者提供成千上万的可用包。常见的集中式仓库包括 Maven Central、NPM、Docker Hub、GitHub Container Registry 等。仓库负责索引包的元数据(包括版本、标签、依赖关系和简要描述),以便用户搜索。同时,这些仓库还管理访问控制,以支持公开包和私有包。但归根结底,包仓库的主要职责是让包的生产者能够上传包,包的使用者能够下载包(见图 2.3)。
当我们谈到 Kubernetes 时,Helm 是一个非常流行的工具,它既提供包管理功能,也提供模板引擎功能。不过,还有一些值得关注的工具,例如:
- Imgpkg (carvel.dev/imgpkg/):使用容器注册表来存储包。
- Kapp (carvel.dev/kapp/):提供更高级的抽象,将资源按应用进行分组。
- Terraform 和 Pulumi:允许你以代码的形式管理基础设施。
在接下来的章节中,我们将使用 Helm (helm.sh) 将 Conference 应用安装到我们的 Kubernetes 集群中。
2.2 使用单条命令安装 Conference 应用
让我们使用 Helm 将第 1 章 1.4 节介绍的 Conference 应用安装到 Kubernetes 集群中。这个应用允许会议组织者接收潜在演讲者的提案、评估这些提案,并保持活动议程中已批准提交的更新。我们将在整本书中使用这个应用,来展示在构建真实应用时可能遇到的挑战。
注意 :完整的步骤请参考这个逐步教程:github.com/salaboy/pla...。教程中包括运行本节命令所需的所有前置条件,例如创建集群和安装示例所需的命令行工具。
该应用被构建为 walking skeleton,意味着它不是完整的应用,但包含了"Call for Proposals"流程所需的所有组件。这些服务可以进一步迭代,以支持其他流程和真实场景。在接下来的章节中,你将把应用安装到集群中,并与之交互,以观察它在 Kubernetes 上运行时的行为。我们可以通过以下命令安装应用:
lua
helm install conference oci://docker.io/salaboy/conference-app --version v1.0.0你应该会看到类似于清单 2.1 的输出:
清单 2.1 Helm 安装 conference-app v1.0.0
yaml
> helm install conference oci://docker.io/salaboy/conference-app --version v1.0.0
Pulled: registry-1.docker.io/salaboy/conference-app:v1.0.0
Digest: sha256:e5dd1a87a867fd7d6c6caecef3914234a12f23581c5137edf63bfd9add7d5459
NAME: conference
LAST DEPLOYED: Mon Jun 26 08:19:15 2023
NAMESPACE: default
STATUS: deployed
REVISION: 1
TEST SUITE: None
NOTES:
Cloud-Native Conference Application v1.0.0
Chart Deployed: conference-app - v1.0.0
Release Name: conference
For more information visit: https://github.com/salaboy/platforms-on-k8s
Access the Conference Application Frontend by running
➥ 'kubectl port-forward svc/frontend -n default 8080:80'
注意 :自 Helm 3.7+ 起,你可以将 Helm Chart 打包并分发为 OCI 容器镜像。Chart 的 URL 中包含 oci://,因为该 Chart 托管在 Docker Hub 上,应用容器也存储在那里。在 Helm 支持 OCI 镜像之前,你需要手动从 Helm Chart 仓库添加并获取包,这些仓库使用 tar 文件来分发 Chart。
helm install 会创建一个 Helm release ,意味着你已经创建了一个应用实例,这里实例名为 conference。使用 Helm,你可以部署同一应用的多个实例。你可以通过运行以下命令列出 Helm releases:
helm list输出应该类似图 2.4。
注意 :如果你使用 helm template oci://docker.io/salaboy/conference-app --version v1.0.0,Helm 会输出 YAML 文件,这些文件将应用于集群。在某些情况下,你可能想使用这种方式而非 helm install,例如当你想覆盖 Helm Charts 中无法参数化的值,或者在发送请求到 Kubernetes 之前进行其他转换。
2.2.1 验证应用是否运行
应用部署完成后,容器会下载到你的电脑上运行,这可能需要一些时间。根据网络状况,这个过程可能需要 10 分钟左右,因为 Kafka、PostgreSQL 和 Redis 会与应用容器一起下载。RESTARTS 列显示容器因错误重启的次数。在分布式应用中,这是正常现象,因为组件可能相互依赖,同时启动时连接可能失败。应用设计应能从问题中恢复,Kubernetes 会自动重启失败的容器。
你可以通过列出集群中运行的所有 pod 来监控进度,再次使用 -o wide 标志获取更多信息:
arduino
kubectl get pods -o wide输出应该类似图 2.5。
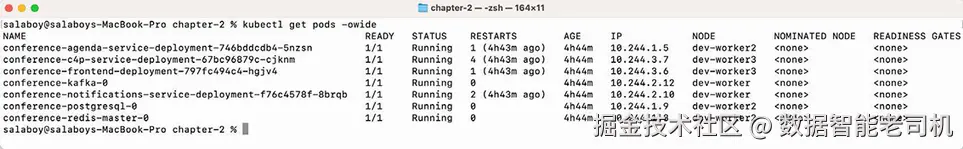
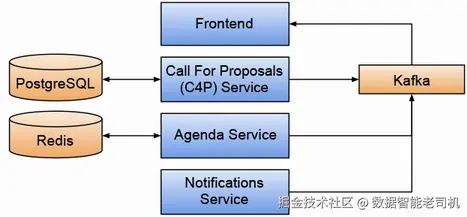
你可能会注意到,在 pod 列表中,我们不仅运行了应用的各个服务,还运行了 Redis、PostgreSQL 和 Kafka ,因为 C4P(Call for Proposals) 和 Agenda 服务需要持久化存储。应用会使用 Kafka 在服务之间交换异步消息。除了这些服务,我们的 Kubernetes 集群中还运行着两个数据库和一个消息代理(Kafka)。
在图 2.5 的输出中,需要关注 READY 和 STATUS 列。READY 列显示 1/1 表示容器有一个副本正在运行,并且预期有一个副本运行。你会看到 RESTART 列显示 7 ,对应 Call for Proposals 服务(conference-c4p-service)。这是因为该服务依赖 Redis 必须先启动并运行,服务才能连接上它。在 Redis 启动的过程中,应用会尝试连接,如果失败,它会持续重试。一旦 Redis 启动完成,服务就能成功连接。Kafka 和 PostgreSQL 也同理。
简要回顾一下,我们正在运行的应用服务、数据库和消息代理在图 2.6 中展示。
注意,Pods 可以被调度到不同的节点上。你可以在 NODE 列中查看,这是 Kubernetes 高效利用集群资源的表现。如果所有 Pods 都已启动并运行,那就成功了!此时应用已经可以使用,你可以通过浏览器访问 http://localhost 来使用它。
如果你对 Helm 感兴趣,并想构建自己的 Conference 应用 Helm Chart,建议查看随教程提供的源码:
github.com/salaboy/pla...
2.2.2 与应用交互
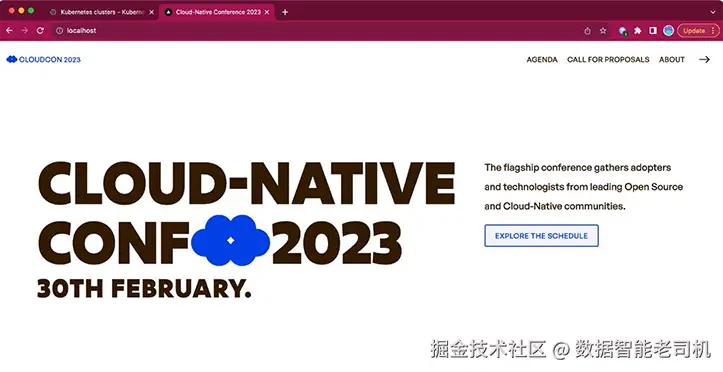
在上一节中,我们已经将应用安装到本地 Kubernetes 集群中。在本节中,我们将快速与应用进行交互,以了解各个服务如何协作完成一个简单的使用场景:接收并审批提案。记住,你可以通过浏览器访问 http://localhost 来使用应用。Conference 应用的界面应如图 2.7 所示。
如果你现在切换到 Agenda(议程) 部分,你应该会看到类似图 2.8 的界面。
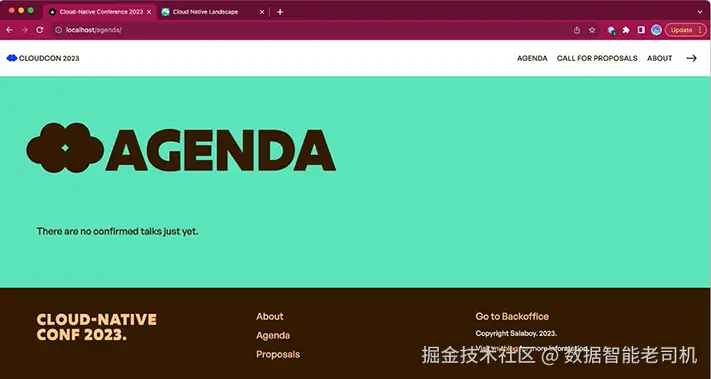
应用的 Agenda(议程) 页面会列出会议安排的所有演讲。潜在的演讲者可以提交提案,由会议组织者进行审核。当你第一次启动应用时,议程上还不会有任何演讲安排,但你现在可以前往 Call for Proposals(征稿) 部分提交一个提案。见图 2.9。
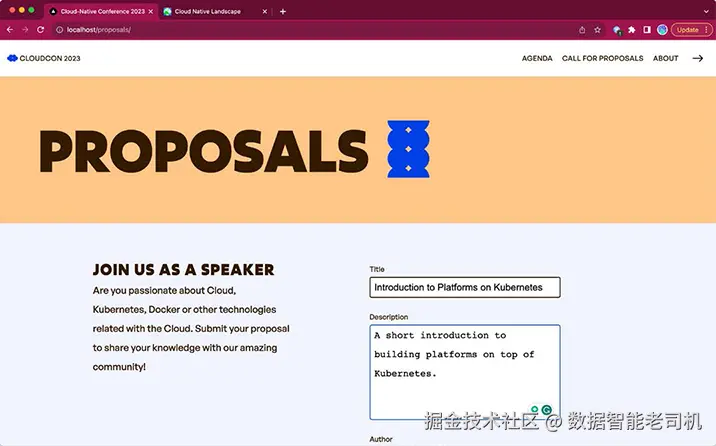
请注意,提交提案的表单中有四个字段:Title(标题)、Description(描述)、Author(作者) 和 Email(电子邮件) 。请填写所有字段,然后点击表单底部的 Submit Proposal(提交提案) 按钮提交。组织者将使用这些信息来评估你的提案,并在提案被批准或拒绝后,通过电子邮件与你联系。提交提案后,你可以进入 Back Office(后台管理) (点击顶部菜单中指向右的箭头),查看 Review Proposals(审核提案) 标签页,在这里你可以 Approve(批准) 或 Reject(拒绝) 提交的提案。在这个界面上,你将扮演会议组织者的角色;见图 2.10。
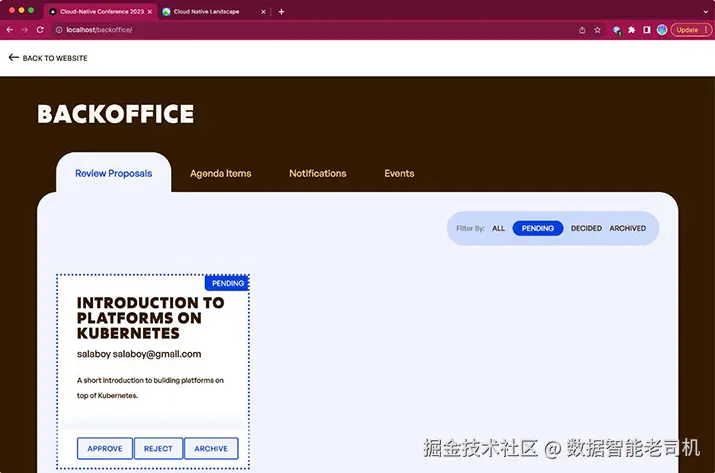
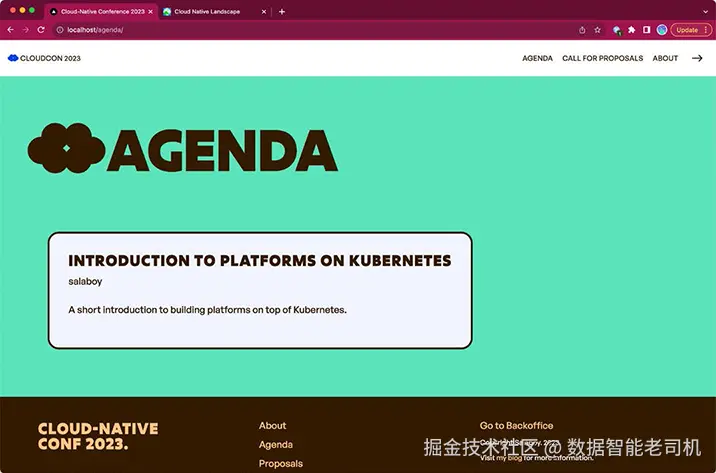
被批准的提案将显示在 Main Agenda(主议程) 页面上。此时访问页面的与会者可以浏览会议的主要演讲者。图 2.11 显示了我们刚刚批准的提案在主会议页面的议程部分的展示情况。
在此阶段,潜在的演讲者应该已经收到了关于其提案被批准或拒绝的电子邮件。你可以通过在终端使用 kubectl 查看通知服务的日志来验证这一点;命令输出示例如图 2.12 所示:
xml
kubectl logs -f conference-notifications-service -deployment-<POD_ID>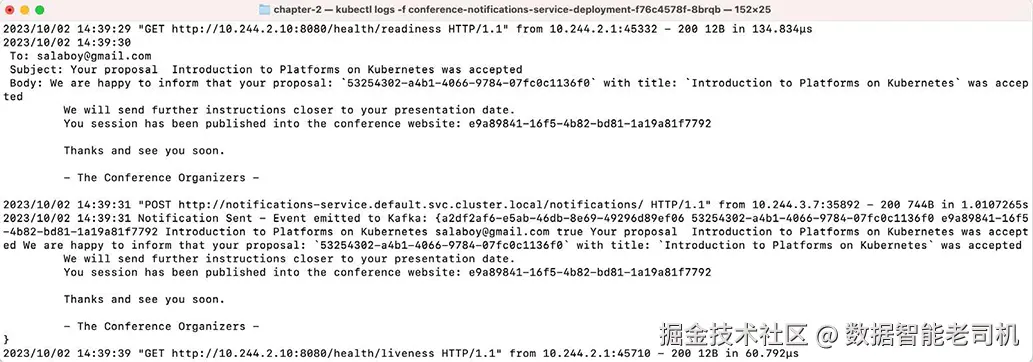
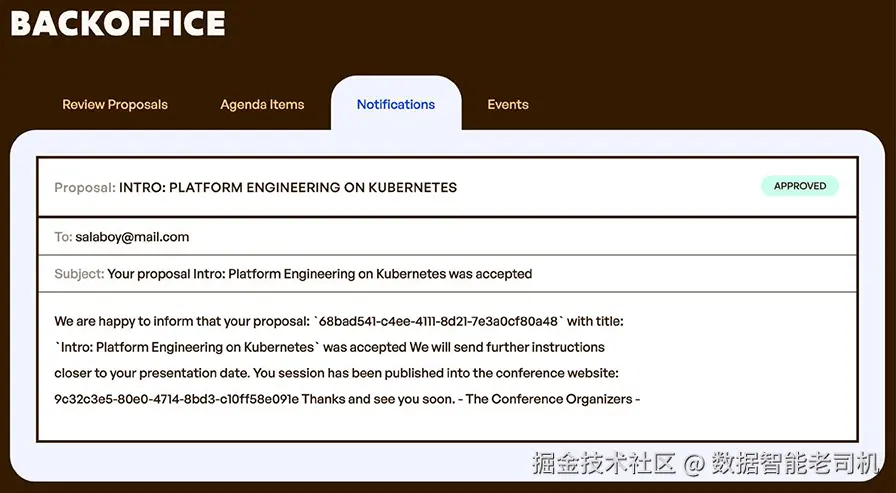
这些日志展示了应用的两个重要方面。首先,通知会通过电子邮件发送给潜在演讲者。组织者需要跟踪这些沟通。在会议的后台管理页面中,你可以找到"Notifications"(通知)标签页,在这里可以向组织者显示通知的内容(见图 2.13)。
这里展示的第二个方面是"事件(Events)"。当应用中的各项服务执行相关操作时,都会触发事件。以通知服务为例,每发送一条通知,它就会向 Kafka 触发一个事件。这使得其他服务和应用能够异步地与这些应用服务进行集成。图 2.14 显示了后台管理页面中的"Events"(事件)部分。
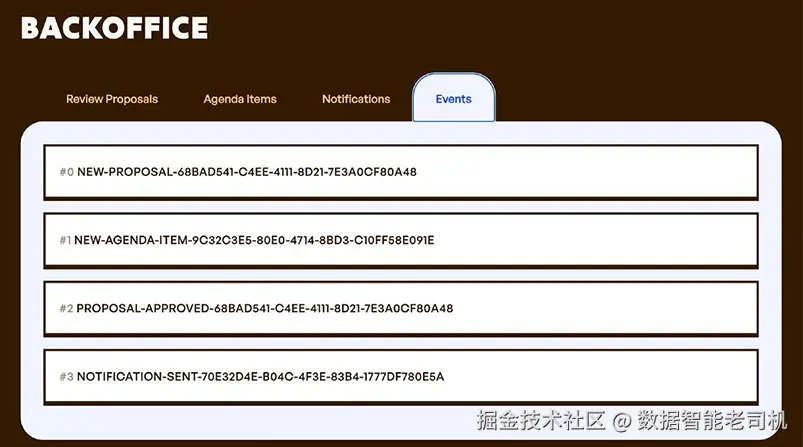
图 2.14 显示了应用服务发出的所有事件;注意,你可以看到服务为完成"Call for Proposals"流程所执行的所有重要操作(新提案 > 新议程项 > 提案批准 > 通知发送)。
如果你顺利做到这一步,恭喜你,Conference 应用已经按预期工作。我鼓励你再提交一个提案并拒绝它,以验证正确的通知和事件是否发送给潜在演讲者。
在本节中,你使用 Helm 安装了 Conference 应用。然后我们验证了应用已启动运行,并且潜在演讲者可以提交提案,而会议组织者可以批准或拒绝这些提案。决策将通过邮件向潜在演讲者发送通知。
这个简单的应用让我们能够演示一个基础用例,我们现在可以在此基础上扩展和改进,以支持真实用户。我们已经看到,安装一个新的应用实例非常简单。我们使用 Helm 安装了一组相互连接的服务,以及一些基础设施组件,如 Redis、PostgreSQL。下一节中,我们将更深入地了解已安装的内容以及应用是如何运行的。
2.3 检查 walking skeleton
如果你已经使用 Kubernetes 一段时间,你大概对 kubectl 很熟悉。因为该应用版本使用了原生 Kubernetes 的部署(Deployment)和服务(Service),你可以使用 kubectl 来检查和排查这些 Kubernetes 资源。
通常,为了理解和操作应用,我们不仅仅查看运行中的 Pods(使用 kubectl get pods),还会查看服务和部署。下面先来看部署资源。
2.3.1 Kubernetes 部署基础
从部署开始。Kubernetes 中的部署负责存放运行容器的"配方"。部署还负责定义容器如何运行,以及在需要时如何升级到新版本。通过查看部署详情,你可以获得非常有用的信息,例如:
- 容器信息 :部署使用的容器是什么。注意,这只是一个普通的 Docker 容器,这意味着你甚至可以用
docker run在本地运行它。这对于排查问题非常重要。 - 副本数量:部署所需的副本数。本例中设置为 1,但你将在下一节中更改。增加副本可以提高应用的弹性,因为副本可能会宕机,Kubernetes 会生成新的实例以保持期望副本数。
- 资源分配:容器的资源配置。根据服务的负载和技术栈,需要调整 Kubernetes 允许容器使用的资源。
- 就绪探针(Readiness)和存活探针(Liveness)状态:Kubernetes 默认会监控容器的健康状态,通过两个探针实现:1)就绪探针检查容器是否准备好接收请求;2)存活探针检查容器的主进程是否在运行。
- 滚动更新策略(Rolling Update Strategy) :定义 Pod 如何更新,以避免用户停机。通过滚动更新策略,你可以定义在升级到新版本时允许多少副本存在。
列出所有部署:
arduino
kubectl get deployments输出类似于清单 2.2:
vbnet
NAME                                          READY   UP-TO-DATE   AVAILABLE
conference-agenda-service-deployment          1/1     1            1
conference-c4p-service-deployment             1/1     1            1
conference-frontend-deployment                1/1     1            1
conference-notifications-service-deployment   1/1     1            1
2.3.2 探索部署
接下来描述 Frontend 部署的详细信息:
sql
kubectl describe deploy conference-frontend-deployment输出类似清单 2.3。主要内容包括:
- 副本状态:显示部署可用副本数量,快速了解部署状态。
- 容器镜像:包括服务使用的镜像名称和标签。
- 环境变量:配置容器的变量,例如服务之间的 URL、Kafka 地址、Pod 名称、IP、命名空间等。
- 事件(Events) :显示与资源相关的重要事件,例如副本创建时间。
描述部署非常有用,例如当副本数未达标时,可以通过事件找到问题所在。部署还负责协调版本或配置升级及回滚。默认滚动更新策略(Rolling)会依次升级 Pod,以最小化停机。另一种策略 Recreate 会先关闭所有 Pod,再创建新 Pod。
与 Pods 不同,部署是长期存在的资源;即使底层容器失败,部署依然可以查询。Kubernetes 会创建中间资源来管理和监控部署请求的副本数量。
2.3.3 ReplicaSets
多个容器副本有助于应用扩展。如果应用流量很大,可以增加服务副本数来处理请求;如果请求量小,可以减少副本以节省资源。Kubernetes 创建的对象叫 ReplicaSet,查询命令:
arduino
kubectl get replicaset输出类似清单 2.4:
sql
NAME                                              DESIRED   CURRENT   READY
conference-agenda-service-deployment-7cc9f58875        1       1         1
conference-c4p-service-deployment-76dfc94444           1       1         1
conference-frontend-deployment-59d988899               1       1         1
conference-notifications-service-deployment-7cbcb8677b 1       1         1
ReplicaSet 完全由部署管理,通常不需要手动操作。ReplicaSet 在滚动更新中也非常重要。
调整副本数量
改变部署副本数:
ini
kubectl scale --replicas=2 deployments/<DEPLOYMENT_ID>例如前端部署:
ini
kubectl scale --replicas=2 deployments/conference-frontend-deployment再次列出 Pods,会看到前端服务有两个副本。增加用户访问服务的副本数很常见,因为前端是所有用户访问入口。
如果立即访问应用,用户不会感受到差异,但刷新页面可能会被不同副本处理。
可以开启前端服务内置的调试功能:
bash
kubectl set env deployment/conference-frontend-deployment FEATURE_DEBUG_ENABLED=true注意,当修改部署对象配置(spec.template.spec 内)时,滚动更新机制会启动,现有 Pod 会升级到新配置,确保新 Pod 就绪后再终止旧 Pod。
刷新浏览器(可能需要无痕模式),在后台管理页面新增 Debug 标签,可查看所有服务 Pod 的名称、IP、命名空间和运行节点(图 2.15)。
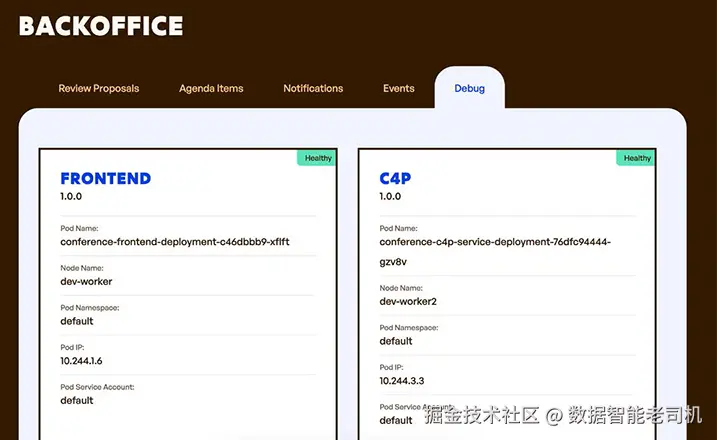
如果你等待 3 秒,页面会自动刷新,这次你应该会看到第二个副本在响应;如果没有,等待下一次刷新周期(见图 2.16)。
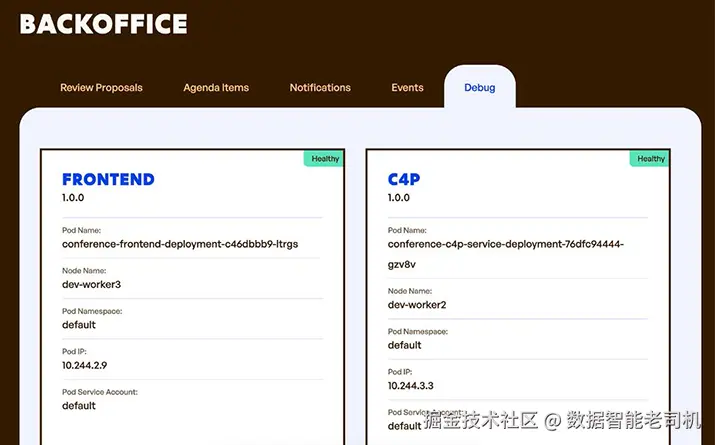
默认情况下,Kubernetes 会在副本之间进行请求的负载均衡。通过仅改变副本数量就能实现扩缩容,无需部署新的资源。Kubernetes 会自动创建新的 Pod(里面包含新的容器)来应对更多的流量,同时确保始终保持期望的副本数量。你可以通过删除一个 Pod 来测试这一机制,并观察 Kubernetes 如何自动重新创建它。在这种场景下需要小心,因为 Web 应用前端在执行多个请求来获取 HTML、CSS 和 JavaScript 库,每个请求可能会落在不同的副本上。
2.3.4 连接服务
我们已经了解了 Deployment,它负责启动并维持容器运行。但目前这些容器只能在 Kubernetes 集群内部访问。如果希望其他服务与这些容器交互,就需要使用另一种 Kubernetes 资源------Service。Kubernetes 提供了高级的服务发现机制,使服务只需知道对方的名字即可通信。这对于连接大量服务非常关键,因为 Pod 的 IP 地址可能随时变化(升级、重新调度到其他节点,或者重启后分配新 IP)。
2.3.5 探索 Services
要让容器对其他服务可访问,需要使用 Kubernetes 的 Service 资源。每个应用服务都会定义一个 Service,这样其他服务和客户端就可以连接它们。Service 负责将流量路由到应用容器,提供逻辑上的名称抽象,隐藏容器实际运行的位置。如果容器有多个副本,Service 会负责在副本之间负载均衡流量。可以通过以下命令列出所有服务:
arduino
kubectl get services示例输出如下(类似 Listing 2.5):
yaml
NAME                        TYPE        CLUSTER-IP      PORT(S)
agenda-service              ClusterIP   10.96.90.100    80/TCP
c4p-service                 ClusterIP   10.96.179.86    80/TCP
conference-kafka            ClusterIP   10.96.67.2      9092/TCP
conference-kafka-headless   ClusterIP   None            9092/TCP,9094/TCP,9093/TCP
conference-postgresql       ClusterIP   10.96.121.167   5432/TCP
conference-postgresql-hl    ClusterIP   None            5432/TCP
conference-redis-headless   ClusterIP   None            6379/TCP
conference-redis-master     ClusterIP   10.96.225.138   6379/TCP
frontend                    ClusterIP   10.96.60.237    80/TCP
kubernetes                  ClusterIP   10.96.0.1       443/TCP
notifications-service       ClusterIP   10.96.65.248    80/TCP
你还可以使用 kubectl describe service <服务名> 查看服务的详细信息,例如:
sql
kubectl describe service frontend输出类似 Listing 2.6。Service 与 Deployment 通过 Selector 属性关联,即 Service 会将流量路由到匹配标签的 Pod(如 app=frontend)。
2.3.6 Kubernetes 的服务发现
使用 Service 后,如果应用服务需要向其他服务发送请求,可以直接使用 Service 的名称和端口,大多数情况下 HTTP 请求可以直接使用 80 端口,无需知道 Pod 的 IP 地址。在服务的源代码中,你会看到 HTTP 请求都是针对 Service 名称发起的。
如果需要将服务暴露到集群外,需要使用 Ingress 资源,它负责将集群外部流量路由到内部服务。通常只暴露少量入口点。可通过以下命令列出所有 Ingress 资源:
arduino
kubectl get ingress示例输出类似 Listing 2.7:
css
NAME                          CLASS   HOSTS   ADDRESS     PORTS   AGE
conference-frontend-ingress   nginx   *       localhost   80      84m
可以用 kubectl describe ingress <资源名> 查看详细信息。例如 Listing 2.8 显示:
markdown
*
  /   frontend:80 (10.244.1.6:8080,10.244.2.9:8080)
Ingress 同样使用 Service 名称路由流量。要生效,需要安装 Ingress Controller(在 KinD 集群中已安装,云环境可能需要手动安装)。
Ingress 允许配置单一入口点,并用路径路由将流量分发到不同服务。Listing 2.8 中的 Ingress 将所有 / 流量路由到 frontend 服务。注意,不应在此层添加业务逻辑路由。
2.3.7 调试内部服务
有时需要访问内部服务进行调试或排查问题,可以使用 kubectl port-forward 暂时访问未暴露的服务。例如访问 Agenda 服务:
bash
kubectl port-forward svc/agenda-service 8080:80输出示例(Listing 2.9):
csharp
Forwarding from 127.0.0.1:8080 -> 8080
Forwarding from [::1]:8080 -> 8080
然后通过浏览器或 curl 访问:
bash
curl -s localhost:8080/service/info | jq --color-output返回示例(Listing 2.10):
json
{
  "Name": "AGENDA",
  "Version": "1.0.0",
  "Source": "https://github.com/salaboy/platforms-on-k8s/tree/main/conference-application/agenda-service",
  "PodName": "conference-agenda-service-deployment-7cc9f58875-28wrt",
  "PodNamespace": "default",
  "PodNodeName": "dev-worker3",
  "PodIp": "10.244.2.2",
  "PodServiceAccount": "default"
}
本节中,你已经检查了运行应用容器所创建的主要 Kubernetes 资源。通过了解这些资源及其关系,可以在出现问题时进行排查。日常操作中,命令行工具 kubectl 可能不是最优选择,可以使用各种 Dashboard 来管理 Kubernetes 工作负载,如 k9s 、Kubernetes Dashboard 或 Skooner。
2.4 云原生应用的挑战
与单体应用不同,单体应用一旦出现故障,整个系统可能完全宕机,而云原生应用设计上不应因某个服务出错而崩溃。云原生应用是为"容错"而设计的,即使发生错误,也应继续提供有价值的功能。在修复问题期间,服务降级总比无法访问应用要好。本节中,你将修改 Kubernetes 中的一些服务配置,以观察应用在不同情况下的表现。
在某些情况下,应用或服务开发者需要确保服务具备韧性,而 Kubernetes 或底层基础设施只能解决部分问题。
本节将介绍云原生应用常见的一些挑战。我认为,提前了解可能出错的地方比在构建和交付应用时才发现问题更有价值。这并不是一个详尽的清单,只是一个起点,帮助你避免卡在已知问题上。接下来的内容将结合 Conference 应用,对这些挑战进行说明和示例:
- 不允许停机:如果你在 Kubernetes 上构建和运行云原生应用,但仍然遇到应用停机问题,那么你就没有充分利用所使用技术栈的优势。
- 服务的内置韧性:下游服务可能会宕机,你需要确保自己的服务能够应对。Kubernetes 提供动态服务发现,但这还不足以让应用具备完全韧性。
- 应用状态管理并不简单:必须理解每个服务的基础设施需求,以便 Kubernetes 能高效地对服务进行扩缩容。
- 数据不一致:分布式应用常见问题是数据分散存储,不集中。应用需要能够处理不同服务对"世界状态"的不同视图。
- 理解应用运行状况(监控、追踪与遥测) :清楚了解应用的性能以及其是否按预期工作,对于快速发现问题至关重要。
- 应用安全与身份管理:用户管理和安全通常被忽视。对于分布式应用,尽早清晰地设计和实现这些方面,有助于明确"谁能在什么时候做什么",从而完善应用需求。
接下来,我们从第一个挑战开始:不允许停机。
2.4.1 不允许停机
在 Kubernetes 中,我们可以轻松地对服务副本进行扩缩容。当服务设计基于平台会通过创建新容器副本来扩展时,这是一项非常有用的功能。那么,如果服务无法处理副本或某个服务没有可用副本,会发生什么呢?
我们以 Frontend 服务为例,将其扩展到两份副本运行。可以执行以下命令:
ini
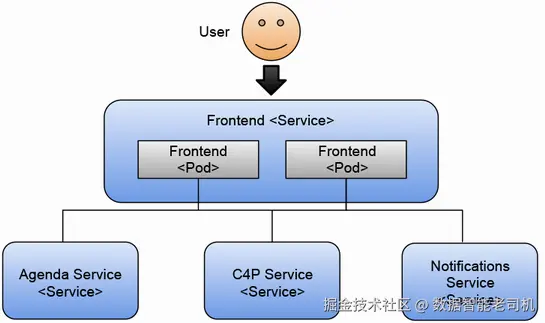
kubectl scale --replicas=2 deployments/conference-frontend-deployment如果其中一个副本因任何原因停止运行或出现故障,Kubernetes 会尝试启动另一个副本,以确保始终有两份副本在运行。图 2.17 显示了两个 Frontend 副本为用户提供服务的情况。
你可以快速体验 Kubernetes 的自愈特性:通过终止 Frontend 应用的两个 Pod 中的一个,就能看到效果。可以按以下命令操作,如清单 2.11 和 2.12 所示。
清单 2.11 检查两个副本是否正常运行
sql
> kubectl get pods
NAME                                             READY   STATUS    RESTARTS      AGE
conference-agenda-service-deployment-<ID>        1/1     Running   7 (92m ago)   100m
conference-c4p-service-deployment-<ID>           1/1     Running   7 (92m ago)   100m
conference-frontend-deployment-<ID>              1/1     Running   0             25m
conference-frontend-deployment-<ID>              1/1     Running   0             25m
conference-kafka-0                               1/1     Running   0             100m
conference-notifications-service-deployment-<ID> 1/1     Running   7 (91m ago)   100m
conference-postgresql-0                          1/1     Running   0             100m
conference-redis-master-0                        1/1     Running   0             100m
现在,复制两个 Frontend Pod 中的一个 ID 并删除它:
arduino
> kubectl delete pod conference-frontend-deployment-c46dbbb9-ltrgs然后再次列出 Pod(清单 2.12)。
清单 2.12 当一个 Pod 宕掉时,会自动创建新的副本
sql
> kubectl get pods
NAME                                             READY   STATUS    RESTARTS      AGE
conference-agenda-service-deployment-<ID>        1/1     Running   7 (92m ago)   100m
conference-c4p-service-deployment-<ID>           1/1     Running   7 (92m ago)   100m
conference-frontend-deployment-<NEW ID>          0/1     ContainerCreating 0     1s
conference-frontend-deployment-<ID>              1/1     Running   0             25m
conference-kafka-0                               1/1     Running   0             100m
conference-notifications-service-deployment-<ID> 1/1     Running   7 (91m ago)   100m
conference-postgresql-0                          1/1     Running   0             100m
conference-redis-master-0                        1/1     Running   0             100m
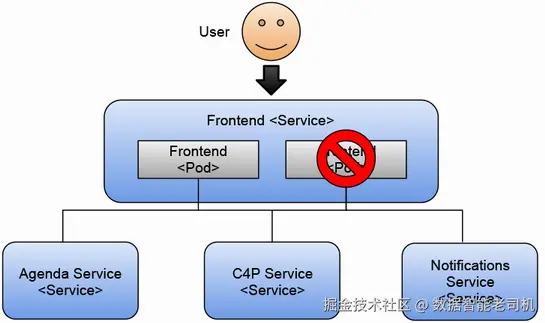
你可以看到,当 Kubernetes(更具体来说是 ReplicaSet)检测到只剩下一个 Pod 在运行时,会立即创建一个新的 Pod。在新 Pod 创建和启动期间,你只有一个副本在响应请求;直到第二个副本启动完成,这个机制保证了至少有两个副本可以响应用户请求。图 2.18 显示了应用仍在正常工作,因为仍有一个 Pod 正在处理请求。
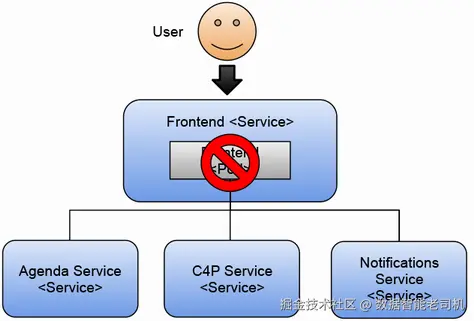
如果你只有一个副本并且终止了正在运行的 Pod,那么在新的容器创建完成并准备好处理请求之前,你的应用将会出现停机。你可以通过以下命令将副本数恢复为单副本:
ini
> kubectl scale --replicas=1 deployments/conference-frontend-deployment可以尝试一下:删除 Frontend Pod 中唯一可用的副本:
arduino
> kubectl delete pod <POD_ID>图 2.19 显示此时应用已经无法工作,因为没有 Frontend Pod 来处理用户的请求。
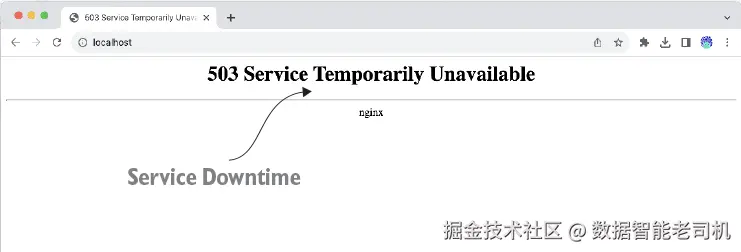
终止 Pod 后,尝试通过刷新浏览器(http://localhost)访问应用。你会在浏览器中看到"503 Service Temporarily Unavailable",因为 Ingress 控制器(为了简洁,前图未显示)无法找到 Frontend 服务背后的任何运行副本。如果等待一会儿,你会看到应用重新恢复。图 2.20 显示了负责将流量路由到 Frontend 服务的 NGINX Ingress 控制器组件返回的 503 "Service Temporarily Unavailable" 页面。
这个错误信息有点"捉弄人",因为应用大约需要一秒钟才能重启并完全可用,所以如果你没有及时看到它,可以尝试将 Frontend 服务缩减到零副本来模拟停机:
ini
kubectl scale --replicas=0 deployments/conference-frontend-deployment这种行为是预期的,因为 Frontend 服务是面向用户的服务。如果它挂掉,用户将无法访问任何功能,因此建议保持多个副本。从这个角度来看,Frontend 服务是整个应用中最重要的服务,因为我们应用的主要目标就是避免停机。
总而言之,特别关注暴露在集群外的面向用户的服务。无论是用户界面还是 API,都要确保有足够的副本来处理请求。除了开发环境,大多数情况下应避免只部署单副本。
2.4.2 服务内建的弹性
那么,如果其他服务挂掉会怎样呢?例如,Agenda 服务负责列出会议参与者可查看的所有被接受提案。这个服务也很关键,因为 Agenda 列表直接显示在应用的主页面上。我们可以尝试将该服务缩减:
ini
kubectl scale --replicas=0 deployments/conference-agenda-service-deployment图 2.21 显示了即使某个服务出现故障,应用仍然可以继续运行的情况。
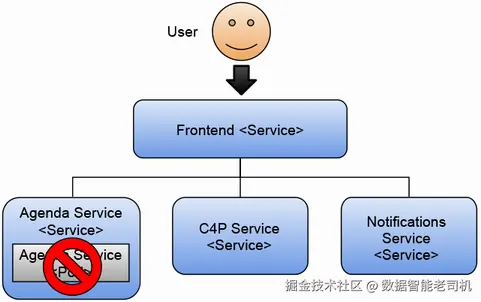
在运行该命令后,容器会被终止,服务将没有任何容器来响应请求。尝试在浏览器中刷新应用,你应该会看到一个缓存的响应,如图 2.22 所示。
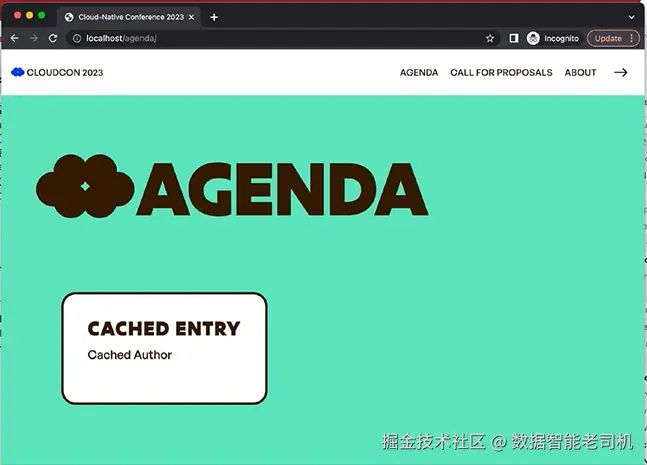
如你所见,应用仍在运行,但此时 Agenda 服务不可用。查看后台管理(Back Office)中的 Debug 标签页,你应该会看到 Agenda 服务处于不健康状态(图 2.23)。
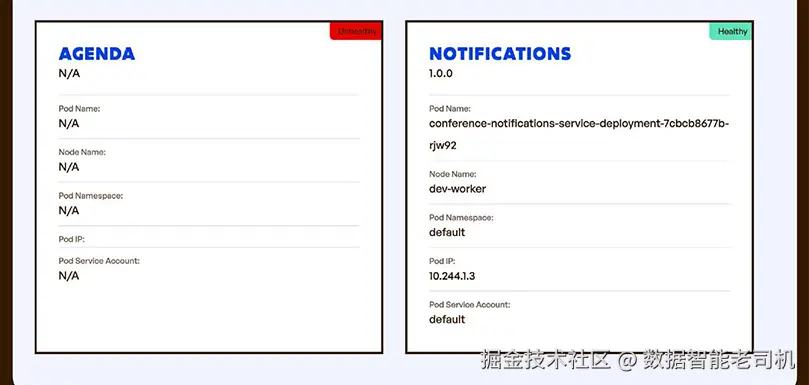
你可以为应用准备应对这种情况的策略;在本例中,Frontend 有缓存的响应,至少可以向用户显示一些内容。如果 Agenda 服务因某种原因宕机,用户至少还能访问应用的其他服务和模块。从应用的角度来看,重要的是不要将错误直接传递给用户。用户应该能够继续使用应用的其他服务,例如"Call for Proposals"表单,直到 Agenda 服务恢复。
在开发将在 Kubernetes 中运行的服务时,你需要格外注意,因为现在你的服务需要处理下游服务产生的错误。这对于确保错误或服务宕机不会导致整个应用崩溃至关重要。简单的机制,例如缓存响应,会让你的应用更具韧性,并允许你逐步升级这些服务,而不用担心整体宕机。在我们的会议场景中,设置一个定期缓存议程条目的 CronJob 就可能足够。记住,宕机是不可接受的。
现在,我们来讨论如何处理应用状态,以及理解应用服务如何从可扩展性角度处理状态的重要性。既然要谈可扩展性,接下来我们要解决的挑战就是数据一致性问题。
2.4.3 处理应用状态并非易事
让我们再次将 Agenda 服务扩容为单副本:
ini
> kubectl scale --replicas=1 deployments/conference-agenda-service-deployment如果你之前创建过提案,你会注意到,一旦 Agenda 服务恢复,你就能在 Agenda 页面上再次看到已接受的提案。这之所以可行,是因为 Agenda 服务和 C4P 服务都将所有提案和议程条目存储在外部数据库中(PostgreSQL 和 Redis)。这里的"外部"意味着数据存储在 Pod 内存之外。
如果我们将 Agenda 服务扩容到两个副本,会发生什么呢?请看清单 2.13。
清单 2.13 运行两个副本的 Agenda 服务
sql
> kubectl scale --replicas=2 deployments/conference-agenda-service-deployment
NAME                                                    READY   STATUS          AGE
conference-agenda-service-deployment-<ID>               1/1     Running         2m30s
conference-agenda-service-deployment-<ID>               1/1     Running         22s
conference-c4p-service-deployment-<ID>                  1/1     Running         150m
conference-frontend-deployment-<ID>                     1/1     Running         8m55s
conference-kafka-0                                      1/1     Running         150m
conference-notifications-service-deployment-<ID>        1/1     Running         150m
conference-postgresql-0                                 1/1     Running         150m
conference-redis-master-0                               1/1     Running         150m
图 2.24 显示了 Agenda 服务同时运行两个副本。
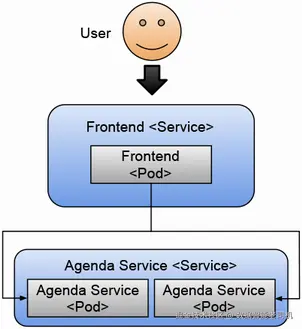
当有两个副本处理用户请求时,Frontend 现在将有两个实例可供查询。Kubernetes 会在这两个副本之间进行负载均衡,但你的应用无法控制请求会命中哪一个副本。由于我们使用数据库在 Pod 之外存储数据备份,因此可以将副本扩展到多个 Pod 来应对应用需求。图 2.25 显示了 Agenda 服务依赖 Redis 存储应用状态,而 Call for Proposals 则使用 PostgreSQL 实现相同功能。
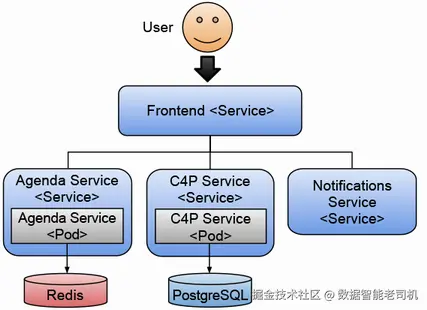
这种方法的一个限制是数据库在默认配置下支持的连接数。如果你不断扩展副本数量,需要始终考虑检查数据库连接池的设置,以确保数据库能够处理所有副本创建的连接。但为了学习的目的,我们假设没有数据库,Agenda 服务将所有议程条目都保存在内存中。如果我们开始扩展 Agenda 服务的 Pod,应用会如何表现呢?图 2.26 展示了应用内部存在内存数据的假想情况。
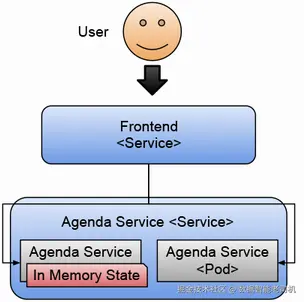
通过扩展这些服务,我们发现了其中一个应用服务设计上的问题。Agenda 服务将状态保存在内存中,这会影响 Kubernetes 的扩展能力。在这种场景下,当 Kubernetes 将请求在不同副本之间进行负载均衡时,Frontend 服务接收到的数据会因处理请求的副本不同而有所差异。
在 Kubernetes 中运行现有应用时,你需要深入了解它们在内存中保存了多少数据,因为这会影响你如何扩展它们。对于那些保持 HTTP 会话并且需要"粘性会话"(后续请求必须发送到同一副本)的 Web 应用,你需要设置 HTTP 会话复制,才能在多副本情况下正常工作。这可能需要在基础设施层配置更多组件,例如缓存。
理解服务需求有助于你规划和自动化基础设施需求,比如数据库、缓存、消息代理等。应用越复杂,对这些基础设施组件的依赖就越多。
正如我们之前看到的,我们在应用的 Helm Chart 中安装了 Redis 和 PostgreSQL。通常这不是一个好主意,因为数据库和消息代理等工具需要运维团队的特殊关注,他们可能选择不在 Kubernetes 内运行这些服务。我们将在第 4 章深入探讨在 Kubernetes 和云提供商环境下如何处理基础设施。
2.4.4 处理数据不一致问题
将数据存储在关系型数据库(如 PostgreSQL)或 NoSQL(如 Redis)中,并不能解决不同存储之间数据不一致的问题。因为这些存储应该被服务 API 隐藏,你仍然需要机制来检查服务处理的数据是否一致。在分布式系统中,"最终一致性"(eventual consistency)是很常见的概念,即系统最终会达到一致状态。拥有最终一致性总比完全没有一致性要好。
在本例中,我们可以建立一个简单的检查机制,比如每天检查一次 Agenda 服务中的已接受议题,确认它们是否在 Call for Proposals 服务中已被批准。如果发现某条议题在 C4P 服务中未被批准,我们可以触发警报或发送邮件给会议组织者(图 2.27)。
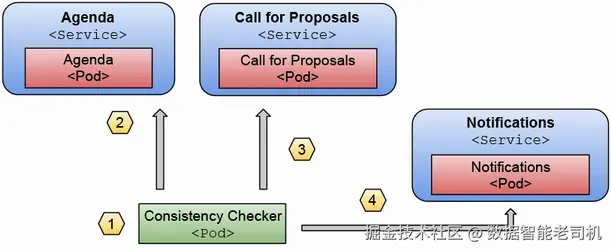
在图 2.27 中,我们可以看到 CronJob(1)会按照设定的周期执行,具体周期取决于我们修复一致性问题的紧迫程度。然后,它会调用 Agenda 服务的公共 API(2),检查哪些已接受的提案被列出,并将其与 Call for Proposals 服务的已批准列表进行比对(3)。最后,如果发现任何不一致,可以通过 Notifications 服务的公共 API(4)发送邮件。
想一想这个应用设计的简单使用场景,还需要进行哪些其他检查?一个显而易见的例子是验证针对被拒绝和被接受的提案,邮件是否正确发送。在这个使用场景中,邮件非常重要,我们需要确保这些邮件能够发送给对应的被接受或被拒绝的演讲者。
2.4.5 了解应用的运行情况
分布式系统是复杂的"生物体",从一开始就完全理解它们的运行机制,可以帮助你在问题发生时节省大量时间。这也推动了监控(monitoring)、追踪(tracing)和遥测(telemetry)社区的发展,提供了解系统运行状态的解决方案。
OpenTelemetry(opentelemetry.io/)社区与 Kubernetes 一同发展,现在可以提供大多数监控服务运行所需的工具。正如其官网所述:"你可以使用它来进行代码插装、生成、收集和导出遥测数据(指标、日志和追踪),以便分析软件性能和行为。"
图 2.28 展示了一个常见的使用场景:各服务将指标、追踪和日志推送到一个集中存储的地方,系统会聚合这些信息,使其可以在仪表盘中展示,或供其他工具使用。
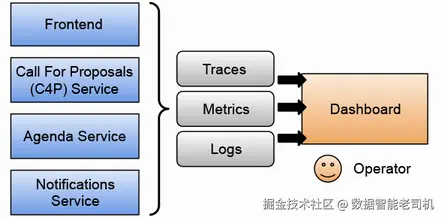
需要注意的是,OpenTelemetry 关注的不仅是软件的性能,也关注软件的行为,因为这两者都会影响用户及其使用体验。从行为角度来看,你需要确保应用程序按预期工作,这意味着你需要了解哪些服务在调用其他服务或基础设施来执行任务。
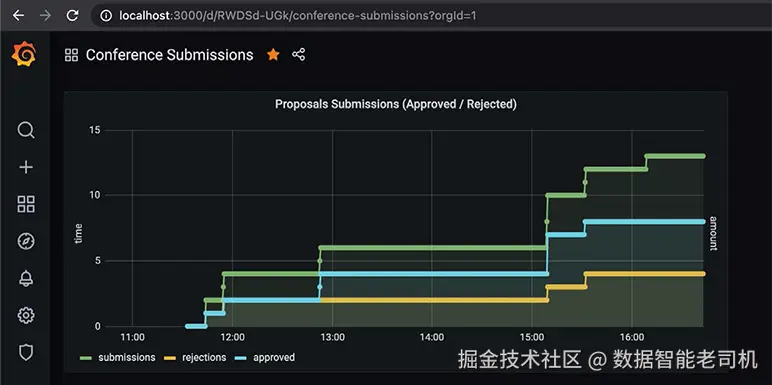
使用 Prometheus 和 Grafana,可以查看服务的遥测数据,并构建面向特定领域的仪表盘,以突出显示某些应用层指标。例如,如图 2.29 所示,可以显示随时间变化的被批准(Approved)与被拒绝(Rejected)提案的数量。
从性能角度来看,你需要确保各个服务遵守其服务级别协议(SLA),也就是说,它们响应请求的时间应保持较短。如果某个服务表现异常,响应时间比平常长,你就需要知道这一点。
对于追踪(tracing),你必须对服务进行修改,以便了解内部操作及其性能。OpenTelemetry 为大多数编程语言提供了开箱即用的检测库,用于将服务的指标和追踪信息外部化。图 2.30 展示了 OpenTelemetry 的架构,你可以看到 OpenTelemetry Collector 从每个应用代理(agent)接收信息,同时也从共享的基础设施组件收集数据。
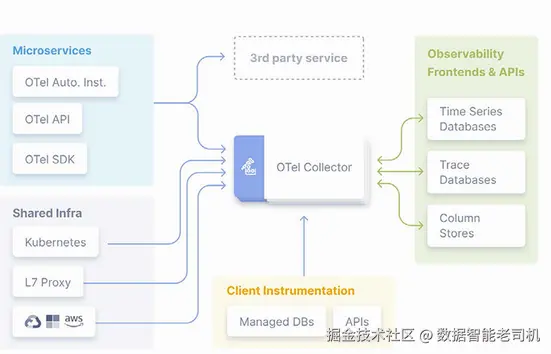
这里的建议是,如果你在创建一个 walking skeleton(即最小可运行骨架应用),确保它内置了 OpenTelemetry。如果把监控留到项目后期再做,那就太晚了------一旦出现问题,追查责任方将耗费大量时间。
2.4.6 应用安全性与身份管理
如果你曾经构建过 Web 应用,就会知道提供身份管理(用户账户与身份)以及认证和授权是相当复杂的工作。破坏任何应用(无论是否云原生)的一种简单方法就是执行不允许的操作,例如删除所有提议的演讲,除非你是会议组织者。
在分布式系统中,这个问题更加具有挑战性,因为授权和用户身份必须在不同服务间传播。在分布式架构中,通常会有一个组件代表用户发起请求,而不是让用户直接操作所有服务。在我们的示例中,Frontend 服务就是这个组件。大多数情况下,你可以将这个面向外部的组件作为外部服务与内部服务之间的屏障。
因此,通常会配置 Frontend 服务与一个身份认证和授权提供者连接,通常使用 OAuth2 协议。图 2.31 展示了 Frontend 服务与身份管理服务的交互,该服务负责连接到身份提供者(如 Google、GitHub 或公司内部 LDAP 服务器),以验证用户凭证,同时提供角色或组成员信息,从而定义用户在不同服务中能做什么、不能做什么。Frontend 服务处理登录流程(认证与授权),完成后只将上下文信息传递给后台服务。
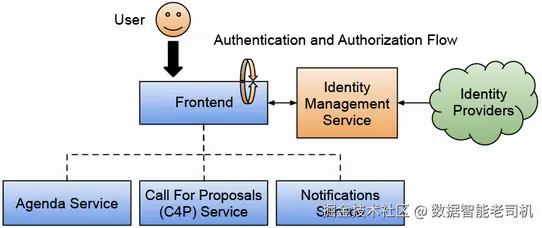
在身份管理方面,你已经看到应用本身不处理用户或其数据,这对于遵守 GDPR 等法规是有利的。我们可能希望允许用户使用社交媒体账户登录应用,而无需创建单独的账户,这通常被称为 社交登录。
一些流行的解决方案将 OAuth2 与身份管理结合在一起,例如 Keycloak (www.keycloak.org/)和 Zitadel (zitadel.com/opensource)。这些开源项目提供了一站式的单点登录(SSO)解决方案和高级身份管理功能。在 Zitadel 的案例中,它还提供了一个托管服务,如果你不想在自己的基础设施中安装和维护 SSO 与身份管理组件,也可以直接使用。
追踪与监控也是同样的道理。如果你计划让用户使用应用(而你迟早会这样做),在 walking skeleton 中集成单点登录和身份管理,会迫使你思考"谁能做什么"的具体细节,从而进一步完善你的使用场景。
2.4.7 其他挑战
前面章节中,我们已经介绍了一些构建云原生应用时会遇到的常见挑战,但这些还不是全部。你能想出其他可能破坏应用首个版本的方法吗?
需要注意的是,解决本章讨论的挑战会有所帮助,但还有其他挑战与如何交付一个不断演进、由越来越多服务组成的应用相关。
2.5 与平台工程的联系
前面章节我们覆盖了很多主题。我们回顾了打包和分发 Kubernetes 应用的选项,然后使用 Helm 将 walking skeleton 安装到 Kubernetes 集群中。通过与应用交互,我们测试了应用功能,最后分析了团队在构建分布式应用时会遇到的常见云原生挑战。
你可能会想,这些主题与本书标题------持续交付与平台工程------有什么关系?在本节中,我们将更明确地将其与第 1 章介绍的主题联系起来。
首先,创建 Kubernetes 集群并在其上运行应用的目的,是确保我们能够利用 Kubernetes 内置机制实现应用服务的弹性与扩展。Kubernetes 提供了运行零停机应用的构建块,即使我们在不断更新应用组件,也能保持服务可用。这让我们能够更频繁地发布新版本,因为更新单个组件不会影响整个应用。第 8 章中,我们将看到如何扩展 Kubernetes 内置机制以实现不同的发布策略。
如果你没有利用 Kubernetes 提供的能力来持续向用户交付软件,就需要引起警觉。这通常可能是因为遗留的旧做法阻碍了自动化,或者服务之间缺乏明确的契约,导致依赖服务无法独立发布。未来章节中我们会多次提到这个话题,因为这是改进持续交付实践的核心原则,也是平台工程团队需要优先考虑的重点。
在本章中,我们还看到如何使用包管理器安装云原生应用,它封装了部署应用所需的配置文件。这些配置文件(以 YAML 表示的 Kubernetes 资源)描述了应用拓扑,并包含每个服务使用的容器链接,同时也包含每个服务的配置,如环境变量。对这些配置文件进行打包和版本管理,使我们可以轻松在不同环境中创建新的应用实例,这将在第 4 章中详细介绍。
如果你想更深入了解持续交付,以及如何通过 配置即代码 (configuration as code)可靠地交付更多软件,我强烈推荐 Christie Wilson 的《Grokking Continuous Delivery》(Manning Publications, 2018)。
为了确保你有一个可以实际操作的应用,并且覆盖 Kubernetes 内置机制,我有意识地选择从一个已经打包好的应用开始,这样可以轻松部署到任意 Kubernetes 集群(无论是本地还是云端)。我们可以区分两个阶段:
- 一个尚未覆盖的阶段是如何生成可以部署到任意 Kubernetes 集群的包;
- 第二个阶段是我们开始实际操作的阶段,即在具体集群中运行应用(可以把这个集群看作一个环境,可能是开发环境),如图 2.32 所示。
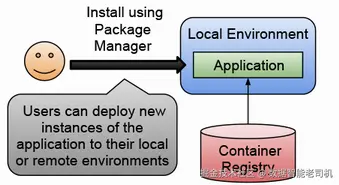
需要理解的是,为我们的本地环境执行的这些步骤,同样适用于任何 Kubernetes 集群,无论集群的规模和位置如何。虽然每个云提供商会有自己的安全和身份管理机制,但当我们将应用 Helm Chart 安装到集群时创建的 Kubernetes API 和资源都是一致的。如果你现在使用 Helm 的模板功能,为目标环境微调应用(例如资源消耗和网络配置),就可以轻松将这些部署自动化到任意 Kubernetes 集群。
在继续之前,需要明确的是,让开发人员去手动配置应用实例可能不是时间的最佳利用方式。让开发人员直接访问用户/客户使用的生产环境,也可能不是最佳选择。我们希望确保开发人员专注于构建新功能和改进应用。图 2.33 展示了我们应如何自动化构建、发布和部署开发人员创建的工件的整个流程,从而确保他们可以专注于为应用增加功能,而不是在新版本准备好时手动处理打包、分发和部署。这正是本章的核心关注点。
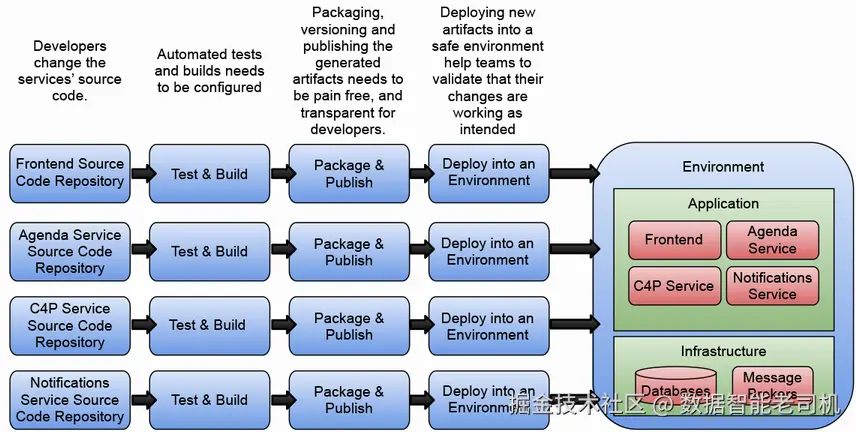
理解我们可以使用的工具,以自动化从源码变更到在 Kubernetes 集群中运行软件的整个路径,对于让开发人员专注于他们最擅长的事情------"编写新功能代码"------是至关重要的。另一个我们将要讨论的重要区别是,云原生应用并非静态的。如前图所示,我们不会安装一个静态的应用定义。我们希望随着服务的新版本可用时,能够发布并部署它们。
手动安装应用容易出错;在 Kubernetes 集群中手动修改配置,可能会导致我们无法在不同环境中复现当前应用状态。因此,在第 3 和第 4 章中,我们将讨论使用通常称为流水线(pipelines)的自动化方法。
在下一章,我们将通过流水线介绍分布式应用的更动态方面,以交付服务的新版本。第 4 章将探讨如何使用基于 Kubernetes 的 GitOps 工具管理我们的环境。
总结
在本地与远程 Kubernetes 集群之间进行选择,需要认真考虑:
-
你可以使用 Kubernetes KinD 来引导本地 Kubernetes 集群以开发应用。主要缺点是你的集群受限于本地资源(CPU 和内存),并不是真正的多机器集群。
-
你可以在云提供商注册账号,并在远程集群上进行开发。该方式的主要缺点是,大多数开发人员不习惯一直远程工作,并且有人需要支付远程资源费用。
-
包管理工具(如 Helm)可以帮助你打包、分发和安装 Kubernetes 应用。本章中,你仅用一条命令就将应用安装到 Kubernetes 集群中。
-
了解你的应用创建了哪些 Kubernetes 资源,有助于你判断当出现问题时应用将如何表现,以及在实际场景中需要考虑哪些额外因素。
-
即使是非常简单的应用,你也会面临必须逐一解决的挑战。提前了解这些挑战,有助于你以正确的思路规划和架构服务。
-
拥有一个 walking skeleton(应用骨架)可以让你在受控环境中尝试不同的场景和技术。本章中,你已经实验了:
- 对服务进行水平扩缩容,亲身观察应用在出错时的行为。
- 状态管理困难,需要专门组件来高效处理。
- 至少为服务配置两个副本可最小化停机时间。确保面向用户的组件始终运行,即使出现问题,用户仍能与应用部分功能交互。
- 设置回退机制和内置问题处理机制,使应用更加健壮。
如果你按照链接的逐步教程操作,现在你已经具备了动手经验:创建本地 Kubernetes 集群、安装应用、对服务进行扩缩容,并且最重要的是,验证应用是否按预期运行。