环境构建
Spring Boot 3.x 版本引入依赖
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-data-mongodb</artifactId>
</dependency>
配置mongodb数据源
server:
  port: 29988

spring:
  application:
    name: mongodb-demo
  data:
    mongodb:
      host: 127.0.0.1
      port: 27017 #端口
      database: test #数据库名
      #如果配置了用户名和密码
#      username:
#      password:
定义MongoDB文档实体
和定义普通实体一样,但是我们可以通过一些注解去标注文档的集合,属性,主键等。
比如:
@Data
@Document(collection = "user")
public class UserEntity {
    @MongoId
    private String id;
    private String name;
    private Integer age;
    private Integer sex;
    private String address;
    private LocalDateTime createTime;
    private LocalDateTime updateTime;
    private Map<String, Object> extension; //扩展信息
}
@Document(collection = "user")表明当前文档所在的集合是"user"
@MongoId表示id字段作为文档的主键,如果不给定id的值,默认文档会自动生成一个主键"_id"
MongoDB默认主键生成机制
- ObjectId类型:
MongoDB默认使用ObjectId类型作为_id字段的值
ObjectId是一个12字节的 BSON 类型数据,包含时间戳、随机数等信息
- 自动生成规则:
时间戳(4字节):Unix时间戳,精确到秒
随机值(5字节):进程唯一标识符和随机数
计数器(3字节):从随机数开始的递增计数器
- 在Spring Data MongoDB中的处理:
当使用 @MongoId 注解时,如果没有手动设置id值,MongoDB会自动生成ObjectId
在你的 UserEntity 类中,id 字段会被映射为MongoDB文档的_id字段
如果不显式设置 id 值,插入文档时MongoDB会自动生成ObjectId作为主键
- 唯一性和索引:
_id字段自动创建唯一索引,确保文档唯一性
每个集合中_id值必须唯一
这种机制确保了分布式环境下主键的全局唯一性,同时包含了时间信息,有利于按时间排序查询。
核心类:MongoTemplate
MongoTemplate 是 Spring Data MongoDB 提供的核心类,主要作用包括:
数据库操作入口:
- 提供了对 MongoDB 数据库进行各种操作的统一入口
- 简化了与 MongoDB 的交互,封装了底层驱动的复杂性
CRUD 操作支持:
- 提供丰富的查询方法,如 find()、findOne()、save()、remove() 等
- 支持复杂的查询条件构建和执行
查询构建:
- 配合 Query 和 Criteria 类构建复杂的查询条件
- 支持正则表达式、范围查询、逻辑运算等高级查询功能
聚合操作:
- 支持 MongoDB 聚合管道操作(Aggregation)
- 可以执行分组、统计、联表等复杂数据分析操作
分页和排序:
- 支持查询结果的分页处理
- 提供灵活的排序功能
类型映射:
- 自动处理 Java 对象与 MongoDB 文档之间的映射转换
- 支持复杂的嵌套对象和集合类型
条件分页
实现步骤:
- 创建Criteria对象进行查询条件的构造(支持方法链式调用,可以连续添加多个查询条件 )
- 创建 Pageable 对象定义分页参数(页码、页面大小)
- 构建好的条件Criteria对象封装到 Query 对象中
- 通过 Query.with(Pageable对象) 方法将分页参数应用到查询中
- 如果需要排序也可以通过Query.with(Sort对象)
- 查询数据和总数:
- 使用 mongoTemplate.find(Query, Class) 查询当前页数据
- 使用 mongoTemplate.count(Query, Class) 查询总记录数
7.计算分页信息
- 根据总记录数和页面大小计算总页数
- 构建包含分页信息的结果对象
示例代码:
 public PageEntity<UserEntity> filter(UserSearch userSearch, int pageNum, int pageSize) {
        log.info("搜索条件:{}",userSearch);
        log.info("分页条件:{}",pageNum + ":" + pageSize);
     //创建Criteria对象进行查询条件的构造(支持方法链式调用,可以连续添加多个查询条件 )
        Criteria criteria = new Criteria();
       if (userSearch != null){
           if (userSearch.getName() != null){
//               在 MongoDB 的正则表达式中,可以使用以下标志位:
//               i - 忽略大小写(Insensitive case):匹配时忽略字母的大小写
//               m - 多行模式(Multiline):改变 ^ 和 $ 的行为,使其匹配每行的开始和结束
//               x - 扩展模式(Extended):忽略空白字符(空格、制表符等)
//               s - 单行模式(Single line):使 . 匹配包括换行符在内的所有字符
               criteria.and("name").regex(".*" + userSearch.getName() + ".*","i");
           }
           if (userSearch.getAge() != null){
               criteria.and("age").is(userSearch.getAge());
           }
           if (userSearch.getAgeStart() != null){
               criteria.and("age").gte(userSearch.getAgeStart());
           }
           if (userSearch.getAgeEnd() != null){
               criteria.and("age").lte(userSearch.getAgeEnd());
           }
           if (userSearch.getSex() != null){
               criteria.and("sex").is(userSearch.getSex());
           }
           if (userSearch.getAddress() != null){
               criteria.and("address").regex(".*" + userSearch.getAddress() + ".*");
           }
           //身高体重
           if (userSearch.getHeightStart() != null){
               criteria.and("extension.height").gte(userSearch.getHeightStart());
           }
           if (userSearch.getHeightEnd() != null){
               criteria.and("extension.height").lte(userSearch.getHeightEnd());
           }
           if (userSearch.getWeightStart() != null){
               criteria.and("extension.weight").gte(userSearch.getWeightStart());
           }
           if (userSearch.getWeightEnd() != null){
               criteria.and("extension.weight").lte(userSearch.getWeightEnd());
           }
       }
     //创建 Pageable 对象定义分页参数(页码、页面大小)
      Pageable pageable = Pageable.ofSize(pageSize).withPage(pageNum - 1);
     //构建好的条件Criteria对象封装到 Query 对象中
       Query query = new Query(criteria);
       log.info("查询条件:{}",query);
     //添加分页参数
       query.with(pageable);
     //添加排序
       query.with(Sort.by(Sort.Direction.ASC,"age"));
     //pageEntity是自定义的一个分页响应实体
       PageEntity<UserEntity> pageEntity = new PageEntity<>();
     //查询结果列表
       List<UserEntity> userEntityList = mongoTemplate.find(query,UserEntity.class);
       log.info("查询结果:{}",userEntityList);
       pageEntity.setContent(userEntityList);
        // 查询总记录数
        long total = mongoTemplate.count(Query.query(criteria), UserEntity.class);
        // 计算总页数
        int totalPages = (int) Math.ceil((double) total / pageSize);
        pageEntity.setTotalPages(totalPages);
        pageEntity.setTotalElements(total);
        pageEntity.setNumber(pageNum);
        pageEntity.setNumberOfElements(userEntityList.size());
        pageEntity.setSize(pageSize);
       return pageEntity;
    }
获取详情
public UserEntity getById(String id) {
        return userRepository.findById(id).orElse(null);
    }
添加文档
mongoTemplate.insert(userEntity);更新文档
 public void update(UserEntity userEntity) {
//构建更新语句 就类似于SQL set name="",age=''....
        Update update = Update.update("name",userEntity.getName())
                .set("age",userEntity.getAge())
                .set("sex",userEntity.getSex())
                .set("address",userEntity.getAddress())
                .set("updateTime",LocalDateTime.now());
//更新操作
       UpdateResult result = mongoTemplate.updateFirst(Query.query(Criteria.where("id").is(userEntity.getId())), update, UserEntity.class);
       //返回更新操作是否被确认执行
        boolean acknowledged =result.wasAcknowledged();
        //返回匹配查询条件的文档数量
        long matchedCount = result.getMatchedCount();
        //返回实际被修改的文档数量
        long modifiedCount = result.getModifiedCount();
}
批量更新是updateMulti
文档删除
public void del(String id){
        mongoTemplate.remove(Query.query(Criteria.where("id").is(id)),UserEntity.class);
    }
数据统计
Aggregation 是 Spring Data MongoDB 中用于执行 MongoDB 聚合操作的类,主要作用如下:
数据聚合操作:
- 执行 MongoDB 的聚合管道操作(Aggregation Pipeline)
- 支持复杂的数据分析和统计操作
管道阶段定义:
- $group:分组和统计操作
- $match:过滤文档
- $project:投影字段
- $sort:排序
- $limit:限制结果数量
- $skip:跳过指定数量的文档
- $unwind:展开数组字段
数据分析功能:
- 支持分组统计、平均值计算、最大最小值等统计操作
- 实现复杂的数据分析需求
示例:
public List<UserStats> groupBySex() {
        Aggregation aggregation = Aggregation.newAggregation(
                Aggregation.group("sex")//分组
                        .count().as("count")//统计
                        .avg("age").as("avgAge"),
                Aggregation.project() //返回结果字段
                        .andExpression("_id").as("sex")
                        .and("count").as("count")
                        .and("avgAge").as("avgAge")
        );
        //Map mappedResults = mongoTemplate.aggregate(aggregation, UserEntity.class, Map.class).getMappedResults().get(0);

        return mongoTemplate.aggregate(aggregation, UserEntity.class, UserStats.class).getMappedResults();
}
注意:group会把分组字段映射成_id,所以我们需要通过andExpression或者and把_id重新命名。
andExpression和and的区别
- andExpression:用于执行表达式操作,可以包含复杂的表达式、函数调用等
- and:用于直接引用字段值,适用于简单的字段引用场景
核心接口:MongoRepository
MongoRepository 是 Spring Data MongoDB 提供的核心接口,主要作用如下:
CRUD 操作接口:
- 提供基本的增删改查操作方法
- 继承了 PagingAndSortingRepository 和 QueryByExampleExecutor 接口
- 包含常用的数据库操作方法
预定义方法:
- save():保存或更新文档
- findById():根据主键查找文档
- findAll():查找所有文档
- deleteById():根据主键删除文档
- delete():删除指定文档
- count():统计文档数量
分页和排序支持:
- 支持分页查询(findAll(Pageable pageable))
- 支持排序查询(findAll(Sort sort))
方法名查询:
- 支持通过方法命名规则自动生成查询语句
例如:findByAge(), findByNameContaining() 等
自定义查询支持:
- 支持使用 @Query 注解定义自定义查询
- 支持使用 @Aggregation 注解定义聚合查询
接口通过继承 MongoRepository<T, ID>, 接口自动获得了对 T 实体类的基本 CRUD 操作能力,其中 ID 指定了主键类型,这大大简化了数据访问层的开发工作。
示例:
public interface UserRepository extends MongoRepository<UserEntity,String> {
}
我们可以在其他类里面不通过mongoTemplate,而直接使用UserRepository就可以实现简单的数据库操作
条件分页
 public Page<UserEntity> listPage(UserEntity entity, int pageNum, int pageSize) {
       // 创建 匹配器 对象
        ExampleMatcher matcher = ExampleMatcher.matching()
                // 全局字符串匹配规则
                .withStringMatcher(ExampleMatcher.StringMatcher.CONTAINING)

                // 全局忽略大小写
                .withIgnoreCase(true)

                // 为特定字段设置专门的匹配规则
                .withMatcher("name", match -> match.ignoreCase().contains())
                .withMatcher("email", match -> match.caseSensitive().startsWith())
                .withMatcher("phone", ExampleMatcher.GenericPropertyMatcher.of(ExampleMatcher.StringMatcher.EXACT))

                // 忽略特定字段
                .withIgnorePaths("id", "createTime", "updateTime", "version")

                // 是否包含 null 值字段(默认 false)
                .withIncludeNullValues();
        Example<UserEntity> example = Example.of(entity, matcher);
        Pageable pageable = Pageable.ofSize(pageSize).withPage(pageNum - 1);
        Page<UserEntity> pages = userRepository.findAll(example, pageable);
        return pages;

    }
通过Example构建的查询器只能进行模糊匹配,如果需要实现范围查询需要配合@Query注解实现,但是太过繁琐。所以如果需要进行复杂的动态查询建议使用mongoTemplate
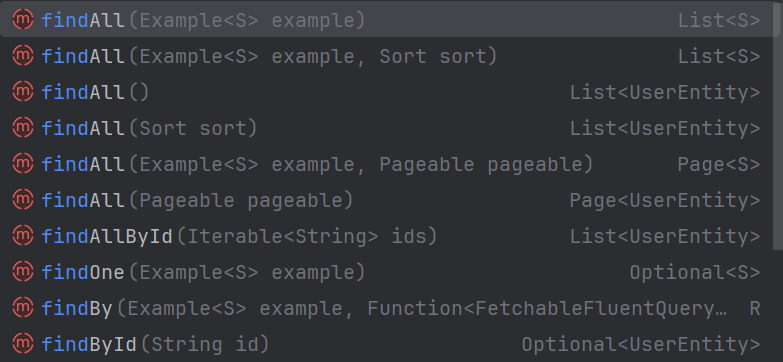
MongoRepository封装了一些查询方法,比如排序,分页,通过主键,主键列表查询等
保存或更新文档

删除文档
@Query
通过@Query注解来构造查询条件
示例:查询年龄范围的用户
public interface UserRepository extends MongoRepository<UserEntity,String> {

    @Query("{'age':{$gte:?0,$lte:?1}}")
    List<UserEntity> findByAge(Integer ageStart, Integer ageEnd);
}
"?0"类似于一个占位符,表示第一个参数," ?1 "表示第二个参数
在其他类里面只需要调用方法就可以了
userRepository.findByAge(18,20)@Query里面编写MongoDB的查询语句命令,需要使用者十分了解MongoDB原生的查询语句命令
示例:查询 where (age >= ? and age <= ?) and (weight >= ? or height >=?)
@Query("{'age':{$gte:?0,$lte:?1}," +
            "$or:[{'weight':{$gte : ?2}}," +
            "   {'height': {$gte: ?3}}]}")
@Aggregation
示例:根据性别分组统计人数和平均年龄
相当于SQL: select sex as sex, count(id) as count,avg(age) as avgAge from user group by sex
 @Aggregation(pipeline = {
            "{ '$group': { '_id': '$sex', 'count': { '$sum': 1 }, 'avgAge': { '$avg': '$age' } } }",
            "{ '$project': { 'sex': '$_id', 'count': 1, 'avgAge': 1, '_id': 0 } }"
    })
    List<UserStats> groupBySex();
@Aggregation里面编写原生的聚合命令,管道操作
注意:通过@Aggregation标注的方法返回结果最好指定实体类不要使用List<Map<String,Object>>
比如错误写法:
 @Aggregation(pipeline = {
            "{ '$group': { '_id': '$sex', 'count': { '$sum': 1 }, 'avgAge': { '$avg': '$age' } } }",
            "{ '$project': { 'sex': '$_id', 'count': 1, 'avgAge': 1, '_id': 0 } }"
    })
    List<Map<String,Object>> groupBySex();
上述写法会报错java.lang.NullPointerException: Cannot invoke "java.lang.Class.isEnum()" because "type" is null
这个错误的根本原因是 Spring Data MongoDB 在处理聚合查询(@Aggregation)时对泛型类型的特殊要求和限制。
泛型类型被用于定义聚合查询的返回结果,但是 Spring Data MongoDB 在处理聚合查询时,会检查泛型类型是否为枚举类型。如果泛型类型是一个枚举类型,Spring Data MongoDB 会将返回结果映射为该枚举类型。但是,如果泛型类型是一个非枚举类型,Spring Data MongoDB 会将返回结果映射为该非枚举类型的对象。
在本例中,UserStats 类是一个我自定义的实体类是一个非枚举类型,因此 Spring Data MongoDB 会将返回结果映射为 UserStats 对象。
1. 类型擦除问题
当使用 List<Map<String, Object>> 时,由于 Java 的泛型类型擦除机制,运行时无法获取完整的泛型信息:
编译时:List<Map<String, Object>>
 运行时:List<Map>(泛型信息丢失)
2. Spring Data MongoDB 的类型检查机制
Spring Data MongoDB 在执行聚合查询时需要:
检查返回类型的元信息
判断是否为简单类型(调用 isEnum() 方法)
决定如何映射查询结果
对于 Map<String, Object> 这样的泛型类型,框架在获取类型信息时得到了 null,导致后续调用 isEnum() 方法时报空指针异常
关于MongoDB的原生的查询或聚合命令的编写规范看前面的文章或者看官方文档:MongoDB中文手册|官方文档中文版 | MongoDB-CN-Manual