提升 LLM 推理效率的秘密武器:LM Cache 架构与实践
一、引言:为何 LM Cache 如此关键?
在大语言模型(LLM)广泛应用的大背景下,性能与成本成为其关键制约因素。每次调用模型都可能耗费数秒甚至更长,使得部署大规模 LLM 系统既昂贵又难满足低延迟需求 。
LM Cache 的出现,正是为了解决此类问题。它通过缓存先前的推理结果,避免了重复计算,从而大幅提高响应速度、节省资源并提升系统扩展性 。
二、LM Cache 的核心机制与架构
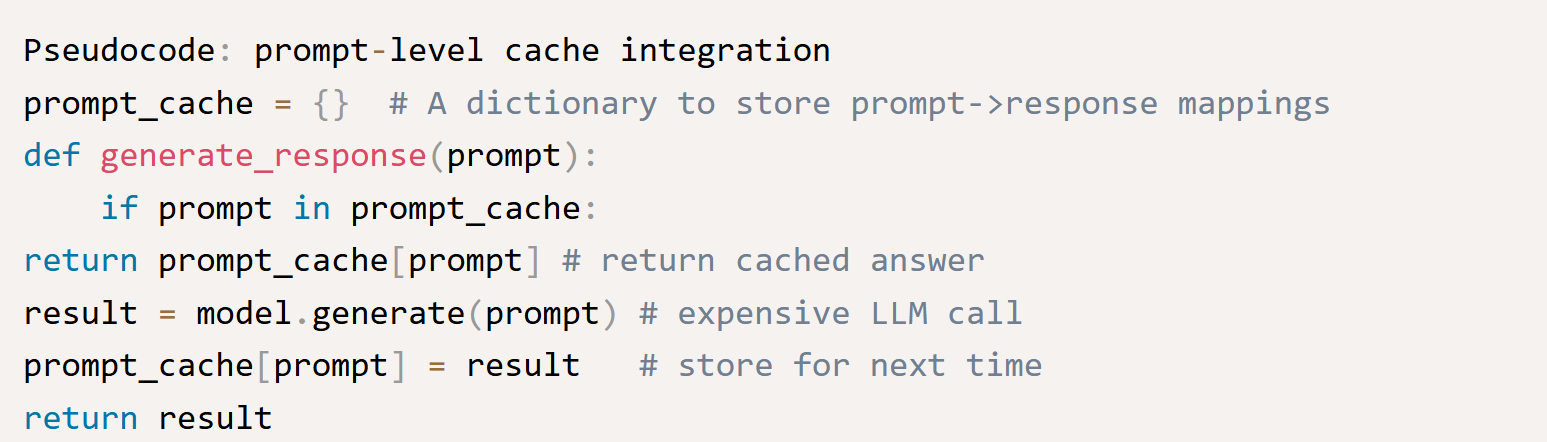
1. Prompt 级缓存(Prompt-level Cache)
将完整的提示与输出结果缓存起来,对于重复的 prompt 直接返回已有答案,适用于常见的问答或固定查询场景 。
2. Token 级缓存(Token-specific Cache)
保存每个 token 的生成状态,避免重复生成之前生成的内容,可节省大量推理时间 。
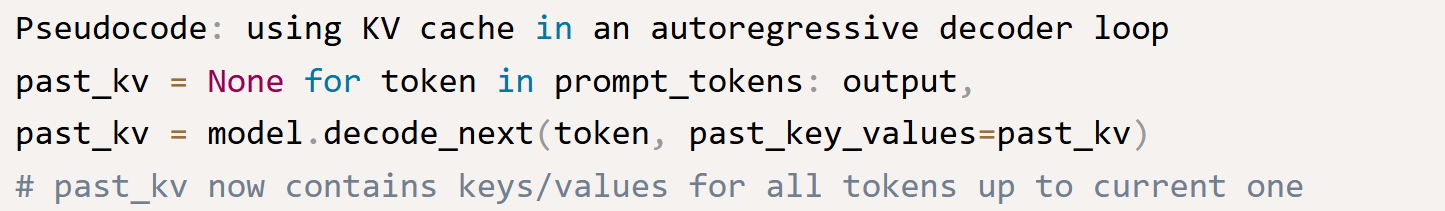
3. KV 缓存(Key-Value Cache)
基于 Transformer 自注意机制,将前一轮计算的 Key、Value 向量缓存,在之后生成新 Token 时直接复用,显著加快逐 token 推理流程 。
三、LM Cache 在系统中的部署策略
-
分布式缓存:例如 NVIDIA 的 Triton Inference Server,支持将缓存分布在网络节点上,缩减重复计算的空间,并确保响应一致性。
-
架构平衡:设计缓存系统时,需要兼顾缓存命中率、内存开销与一致性管理。
-
多级缓存体系:配合 KV Cache,可结合多级缓存结构(本地、共享、持久)灵活应对不同负载场景。
四、实战案例:行业如何应用 LM Cache
1. GPU 加速推理框架(如 vLLM)
LMCache(由 LMCache Lab 开发)作为高性能 KV 缓存层,与 vLLM 推理栈深度集成,支持高吞吐、低延迟的复杂上下文处理,同时节省 GPU 与主存资源 LMCache blog website。
2. 聊天机器人(Chatbot)
在多轮对话场景中,Chatbot 需记忆全程对话上下文,KV Cache 帮助快速查询历史状态,提升响应速度与自然度 IT'S FOSS。
3. 长篇生成、代码补全、文档处理
在这些任务中,上下文庞大,KV Cache 极大降低连续推理开销,提高效率与成本比 IT'S FOSS。
五、LM Cache 与其他优化技术协同增效
| 技术 | 功效说明 |
|---|---|
| 量化(Quantization) | 缩小缓存体积,节省显存 |
| 剪枝(Pruning) | 更紧凑的模型结构,减少缓存压力 |
| 知识蒸馏(Distillation) | 结合缓存使用,提高推理速度与效果 |
| 高性能算子 / Speculative Decoding | 加速缓存加载、跨阶段优化推理过程 |
六、挑战与未来方向
-
内存压力:长上下文推理带来的 KV Cache 持续增长,需要压缩与高效存储方法。
-
缓存一致性:模型更新后缓存需失效或重建。
-
多层缓存策略复杂:需动态调度、明智剔除机制。
-
硬件相关性:缓存性能依赖 GPU 结构与 I/O 设计。
未来可能的发展包括:
-
多层次异构缓存(GPU 本地 → 系统 RAM → 分布式存储)
-
Task-aware 自适应压缩缓存(如 DynamicKV、ZeroMerge 等学术方案) arXiv+2arXiv+2arXiv+2。
七、总结:LM Cache 是大模型规模化部署的关键加速器
LM Cache 是以记忆机制提升 LLM 系统性能的有效路径。通过缓存 prompt、token 或 KV 状态,系统能以更低延迟、更高吞吐显著缩减成本,广泛用于聊天机器人、内容生成、代码辅助、RAG 等核心场景。
如果你正在构建或优化 LLM 推理服务,LM Cache 无疑值得你纳入技术架构考量中。