以下是当前主流的四大知识增强技术方案对比,涵盖核心原理、适用场景及最新发展趋势,为开发者提供清晰的技术选型参考:
🔍 一、RAG(检索增强生成)
核心原理:
动态检索外部知识库(如向量数据库),将相关文档片段与用户查询拼接后输入LLM生成答案。
优势:
- 实时性:支持动态数据更新(如新闻、金融行情)。
- 可扩展性:处理超大规模知识库(百万级文档)。
局限:
- 延迟较高:检索步骤增加50~200ms响应时间。
- 架构复杂:需维护向量数据库与检索管道。
- 典型场景:开放域问答、实时数据分析、多源知识整合。
⚡ 二、CAG(缓存增强生成)
核心原理:
预加载静态知识到LLM上下文窗口,并缓存推理状态(KV Cache),消除实时检索环节。
优势:
- 极低延迟:响应速度比RAG提升40%以上。
- 架构简化:无需向量数据库,降低运维成本。
局限:
- 静态知识依赖:不适合高频更新数据(如社交媒体)。
- 上下文限制:知识规模受模型窗口限制(如GPT-4最大128K tokens)。
- 典型场景:企业文档助手(员工手册/产品文档)、医疗协议查询。
🔄 三、RICHES(生成中检索)
核心原理:
将检索过程融入生成阶段,通过约束解码(Constrained Decoding)动态生成检索键并修正错误。
优势:
- 多跳推理优化:自动迭代检索键解决复杂问题(如"供应链中断对电池成本的影响")。
- 免训练适配:仅需提示工程即可支持新任务。
局限:
- 实现复杂度高:需定制索引策略(如FM-Index)。
- 知识库要求:依赖结构化数据支持高效解码。
- 典型场景:学术研究支持、需高溯源性的法律问答。
🧩 四、KBLAM(知识库增强语言模型)
核心原理:
将知识转化为三元组(实体-属性-值),编码为知识令牌注入LLM注意力层。
优势:
- 动态更新:增删三元组无需重训练模型。
- 资源高效:内存占用随知识量线性增长(传统窗口为二次方)。
局限:
- 语义损失:三元组构建依赖外部工具,可能丢失细节。
- 泛化能力弱:对分布外数据(OOD)处理不佳。
- 典型场景:金融实时报告生成、边缘设备医疗诊断。
🧭 技术选型决策矩阵
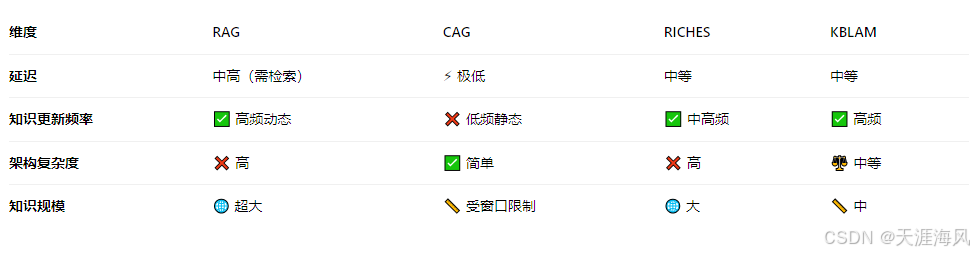
🚀 融合趋势与未来发展
1.混合架构•
- CAG + RAG:静态知识预加载(CAG) + 动态数据实时检索(RAG),例如客服系统预载产品手册(CAG),同时检索实时订单状态(RAG)。
2.硬件协同优化•
- NPU加速KV缓存计算(如Intel OpenVINO),边缘设备部署延迟降至32ms。
3.上下文窗口扩展
- Gemini等模型支持200万Token窗口,CAG/KBLAM适用性大幅提升。
💡 实践建议:
- 选择 RAG:需处理实时数据、多源检索的场景(如新闻聚合)。
- 选择 CAG:静态知识库+低延迟需求(如企业FAQ系统)。
- 探索 RICHES/KBLAM:复杂推理任务或资源受限环境(如医疗边缘计算)。