目录
[2、分布式 ID 设计要求](#2、分布式 ID 设计要求)
[3、常见分布式 ID 方案](#3、常见分布式 ID 方案)
[3.1. 数据库自增 ID](#3.1. 数据库自增 ID)
[3.2. 数据库分段号段模式](#3.2. 数据库分段号段模式)
[3.3. UUID / GUID](#3.3. UUID / GUID)
[3.4. Snowflake(雪花算法)](#3.4. Snowflake(雪花算法))
[3.5. Redis 生成 ID](#3.5. Redis 生成 ID)
[3.6. ZooKeeper 分布式 ID](#3.6. ZooKeeper 分布式 ID)
前言
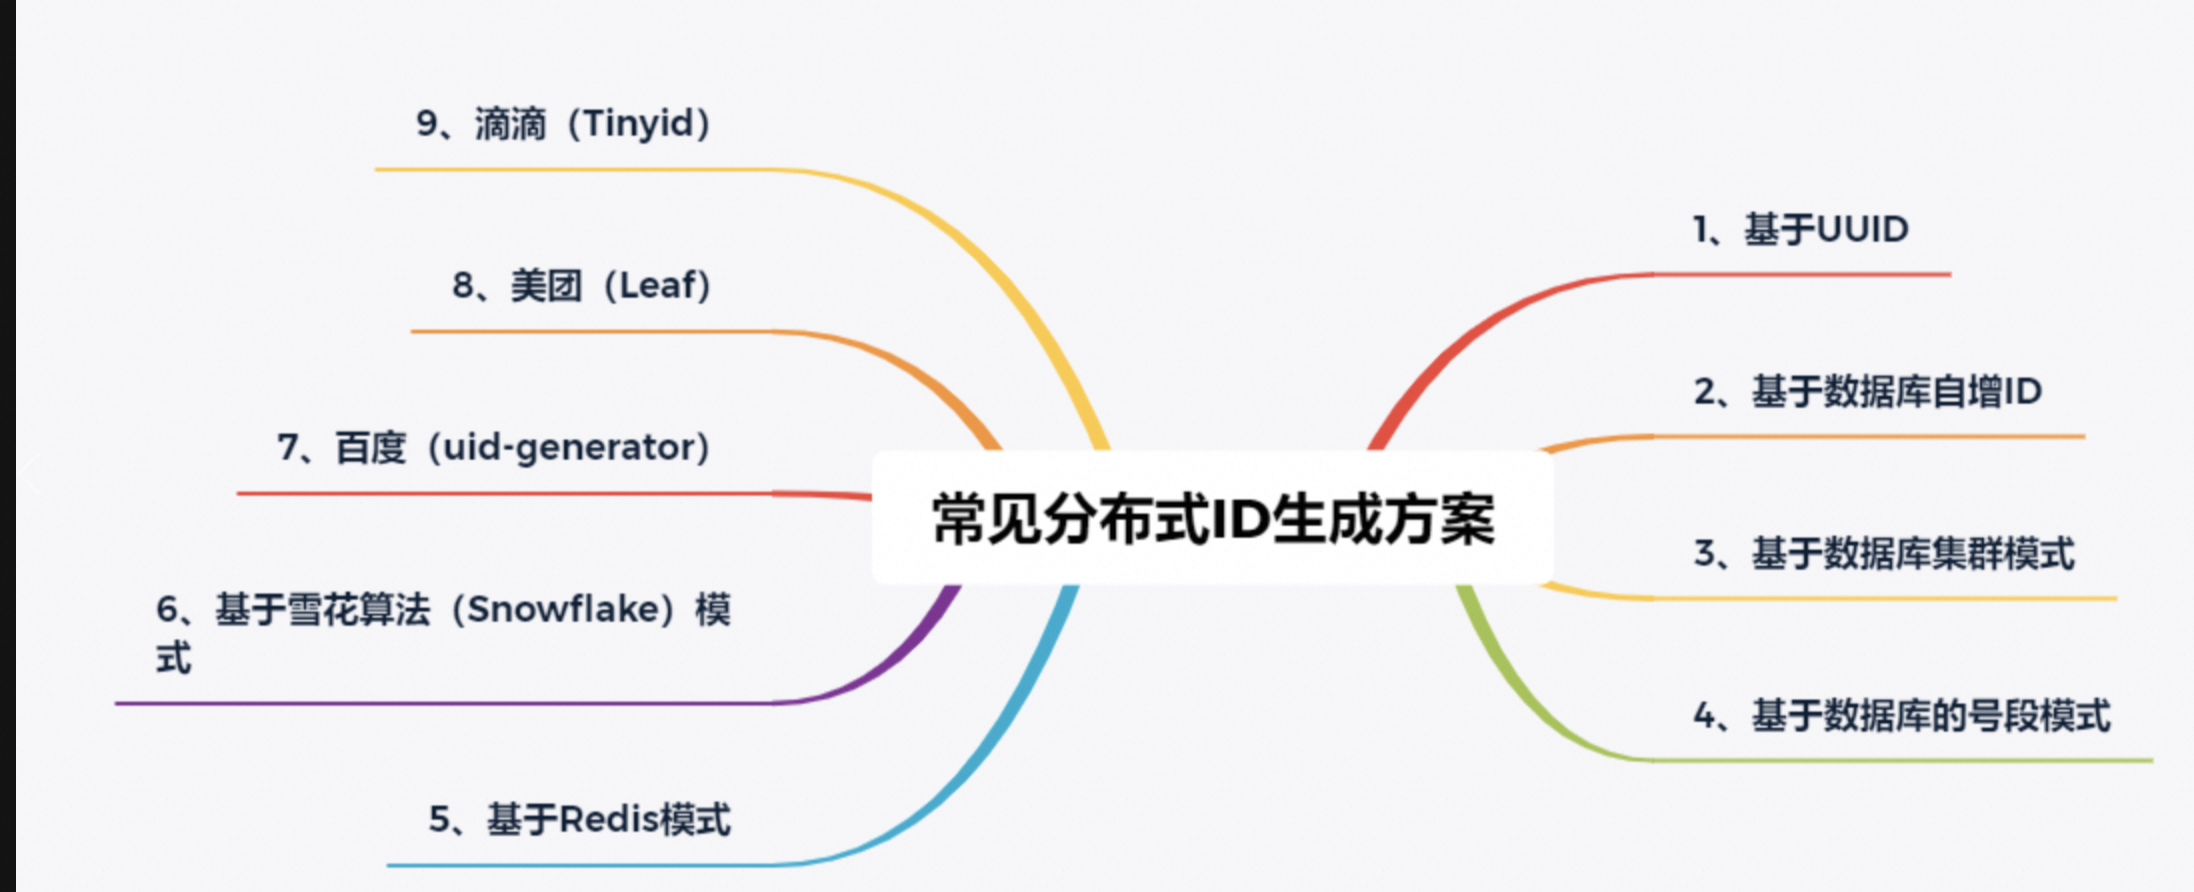
分布式 ID 设计 在分布式系统中是一个高频且关键的基础组件,牵涉到 唯一性、性能、趋势递增、可用性 等多个维度的权衡。
如下所示:
1、设计背景
在单机应用中,数据库自增主键(auto_increment / sequence)经常被用来做主键 ID。
但在分布式环境中:
- 多节点或多数据库实例无法依赖单点生成自增 ID
- 并发高、请求量大,ID 生成要高可用且不会冲突
- 可能要求 ID 有顺序性、可排序性(例如按时间分表)
- 有时还要求 信息可解读(编码一些业务信息),例如机房、业务类型等
所以就衍生出了多种分布式 ID 生成方案。
2、分布式 ID 设计要求
常见指标:
- 全局唯一性(不会重复)
- 高性能(高并发场景也能快速生成)
- 高可用(某个节点挂掉不会影响整体)
- 趋势递增(有序 ID 方便写入数据库的聚簇索引)
- 安全性(不暴露业务数据)
- 可扩展性(支持未来节点扩容)
3、常见分布式 ID 方案
3.1. 数据库自增 ID
1、原理
利用数据库自增字段(auto_increment)或 sequence。
2、优缺点
优点
- 简单,DB 自带
- 实现成本低
缺点
- 单点瓶颈(主库压力大)
- 数据库宕机不可用
- 扩展性差
- 跨库跨表不方便保证唯一 ID
改进方案
- 多主模式,设置不同起始值和步长:
- 节点1:起始1,步长3 → 1,4,7...
- 节点2:起始2,步长3 → 2,5,8...
- 适合 ID 生成需求量不大,系统简单的场景。
3.2. 数据库分段号段模式
1、原理
用一个数据库表存储当前可用 ID 最大值,每次业务服务批量申请一段(比如 1000 或 10000 个 ID),缓存在本地内存使用。
示例表
sql
CREATE TABLE id_generator (
  biz_tag VARCHAR(100) PRIMARY KEY,
  max_id BIGINT NOT NULL,
  step INT NOT NULL,
  update_time TIMESTAMP NOT NULL
)
2、流程:
- 应用向 ID 服务请求一个号段
- ID 服务从数据库读取当前 max_id,加 step,并更新回表
- 应用在内存中分配这段号段,发完后再申请下一段
优点
- 数据库只会被少量更新(每次取一段号)
- 性能比直接用数据库自增高很多
- 可自定义步长,自适应高并发
缺点
- 依赖数据库(但压力小)
- ID 无业务含义,只有趋势递增
- 多实例下需要一个号段服务(保持 DB 更新安全)
3、应用
美团 Leaf(Leaf-segment 模式)就用这种方式。
数据库主键自增这种模式,每次获取 ID 都要访问一次数据库,ID 需求比较大的时候,肯定是不行的。
如果我们可以批量获取,然后存在在内存里面,需要用到的时候,直接从内存里面拿就舒服了。
3.3. UUID / GUID
1、原理
利用算法(如 Java UUID.randomUUID()、数据库 UUID 函数)生成 128bit 唯一值。
2、优缺点
优点
- 全球唯一
- 不依赖中心节点
- 本地离线生成
缺点
- ID 长(16字节或32字符)
- 无序,插入数据库会导致索引分裂,性能下降
- 不可读,不带业务信息
3、应用
- 适合分布式文件系统、对象存储等对顺序性不敏感的场景。
- Twitter 的一些 Trace ID 也用 UUID。
3.4. Snowflake(雪花算法)
1、原理
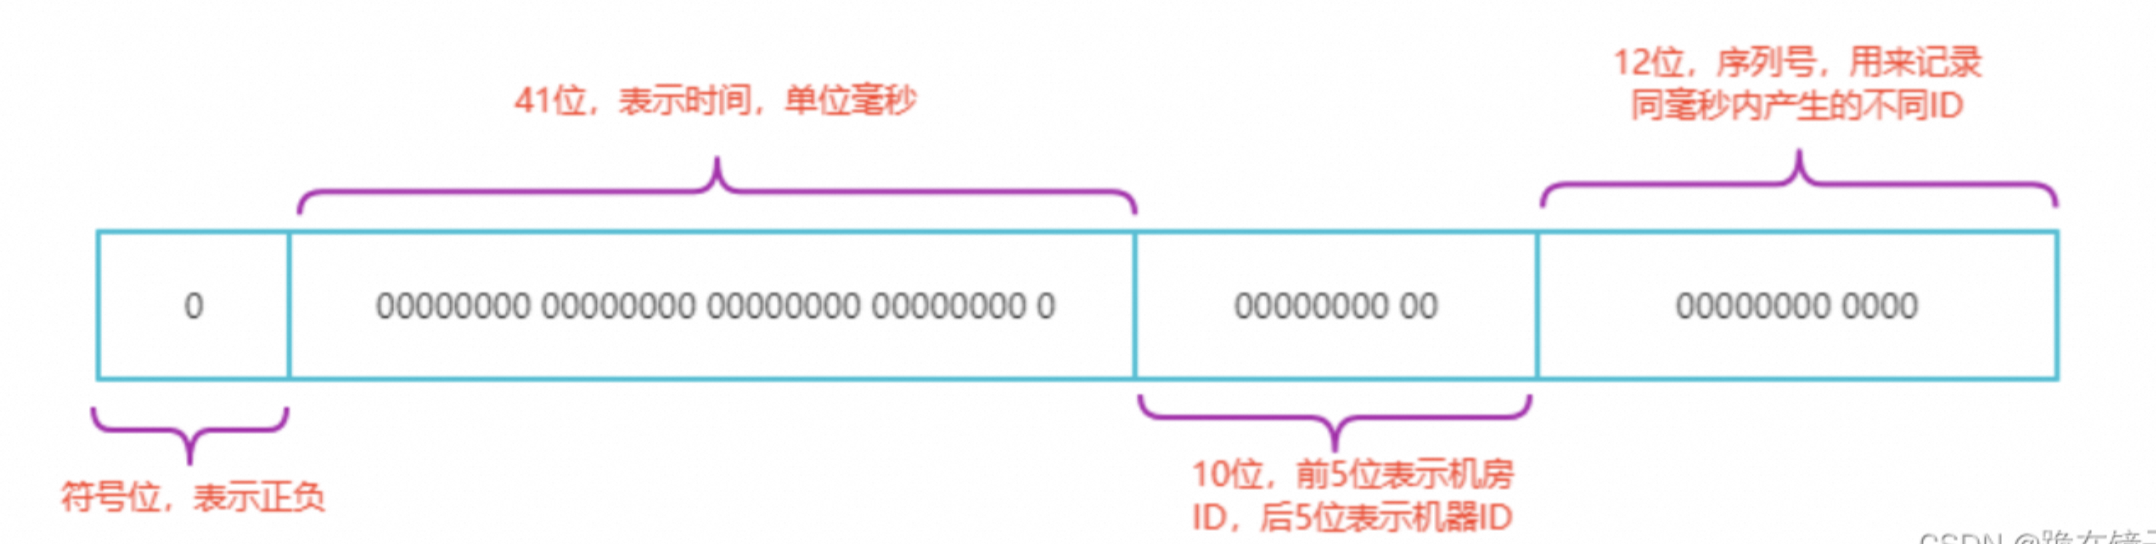
最初由 Twitter 提出,使用 64bit long 按位划分:
bash
0 - 符号位(1bit,始终为0)
41 - 时间戳(毫秒)
10 - 机器ID(数据中心ID + 机器ID)
12 - 序列号(毫秒内计数器)
一个典型 Snowflake 结构:
bash
[ 1bit 符号位 ][ 41bit 时间戳 ][ 5bit 数据中心ID ][ 5bit 机器ID ][ 12bit 序列号 ]- 第1位置为最高位是符号位,正数是0,负数是1,所以id一般是正数,最高位是0。
- 第2-42位是相对时间戳,通过当前时间戳减去一个固定的历史时间戳生成。
- 第43-52位是机器号workerID,每个Server的机器ID不同。
- 第53-64位是12位序列,毫秒内的计数,12位的计数顺序号支持每个节点每毫秒(同一机器,同一时间截)产生4096个ID序号。
2、优缺点
优势:
- 毫秒级高性能生成
- 单机每毫秒可生成 4096 个 ID
- 趋势递增
- 分布式部署,节点 ID 可配置
缺陷:
- 依赖系统时间;时钟回拨会导致 ID 冲突或服务不可用
- 机器 ID 配置需要保证唯一
改进:
- 百度 UidGenerator
- 美团 Leaf(Leaf-snowflake 模式,借助 ZooKeeper 分配 workerId)
- Instagram 的 ID 生成器(时间 + shard ID + 自增序列)
代码示例:
java
package com.sitech.ep.appinfo.util;

import org.shade.apache.commons.lang3.RandomUtils;
import org.shade.apache.commons.lang3.StringUtils;
import org.shade.apache.commons.lang3.SystemUtils;

import java.net.Inet4Address;
import java.net.UnknownHostException;
import java.util.Arrays;
import java.util.concurrent.TimeUnit;
import java.util.concurrent.locks.LockSupport;

/**
 * @Description:
 * @Author: yangjj_tc
 * @Date: 2022/12/28 15:04
 */
public class SnowflakeIdWorker {

    /**
     * 开始时间截 (2022-12-28)
     */
    private final long twepoch = 1672211070000L;

    /**
     * 数据标识id所占的位数
     */
    private final long dataCenterIdBits = 5L;

    /**
     * 机器id所占的位数
     */
    private final long workerIdBits = 5L;

    /**
     * 序列在id中占的位数
     */
    private final long sequenceBits = 12L;

    /**
     * 支持的最大数据标识id,结果是31
     */
    private final long maxDatacenterId = -1L ^ (-1L << dataCenterIdBits);

    /**
     * 支持的最大机器id,结果是31 (这个移位算法可以很快计算出几位二进制数所能表示的最大十进制数)
     */
    private final long maxWorkerId = -1L ^ (-1L << workerIdBits);

    /**
     * 机器ID向左移12位
     */
    private final long workerIdShift = sequenceBits;

    /**
     * 数据标识id向左移17位(12+5)
     */
    private final long datacenterIdShift = sequenceBits + workerIdBits;

    /**
     * 时间截向左移22位(5+5+12)
     */
    private final long timestampLeftShift = sequenceBits + workerIdBits + dataCenterIdBits;

    /**
     * 生成序列的掩码,这里为4095 (0b111111111111=0xfff=4095)
     */
    private final long sequenceMask = -1L ^ (-1L << sequenceBits);

    /**
     * 工作机器ID(0~31)
     */
    private long workerId;

    /**
     * 数据中心ID(0~31)
     */
    private long datacenterId;

    /**
     * 毫秒内序列(0~4095)
     */
    private long sequence = 0L;

    /**
     * 上次生成ID的时间截
     */
    private long lastTimestamp = -1L;

    /**
     * 构造函数
     *
     * @param workerId 工作ID (0~31)
     * @param datacenterId 数据中心ID (0~31) 此方法是判断传入的机房号和机器号是否超过了最大值31或者小于0
     */
    public SnowflakeIdWorker(long workerId, long datacenterId) {
        if (workerId > maxWorkerId || workerId < 0) {
            throw new IllegalArgumentException(
                String.format("worker Id can't be greater than %d or less than 0", maxWorkerId));
        }
        if (datacenterId > maxDatacenterId || datacenterId < 0) {
            throw new IllegalArgumentException(
                String.format("datacenter Id can't be greater than %d or less than 0", maxDatacenterId));
        }
        this.workerId = workerId;
        this.datacenterId = datacenterId;
    }

    /**
     * 核心方法 获得下一个ID (该方法是线程安全的)
     *
     * @return SnowflakeId
     */
    public synchronized long nextId() {
        // 获取当前的系统时间
        long timestamp = timeGen();
        // 如果当前时间小于上一次ID生成的时间戳,说明系统时钟回退过这个时候应当抛出异常
        if (timestamp < lastTimestamp) {
            throw new RuntimeException(String.format(
                "Clock moved backwards.  Refusing to generate id for %d milliseconds", lastTimestamp - timestamp));
        }
        // 如果是同一时间生成的,则进行毫秒内序列
        if (lastTimestamp == timestamp) {
            // sequence 要增1, 但要预防sequence超过 最大值4095,所以要 与 SEQUENCE_MASK 按位求与
            // 即如果此时sequence等于4095,加1后为4096,再和4095按位与后,结果为0
            sequence = (sequence + 1) & sequenceMask;
            // 毫秒内序列溢出
            if (sequence == 0) {
                // 阻塞到下一个毫秒,获得新的时间戳
                timestamp = tilNextMillis(lastTimestamp);
            }
        } // 时间戳改变,毫秒内序列重置
        else {
            sequence = 0L;
        }

        // 上次生成ID的时间截
        // 把当前时间赋值给 lastTime, 以便下一次判断是否处在同一个毫秒内
        lastTimestamp = timestamp;

        // 移位并通过或运算拼到一起组成64位的ID
        long id = ((timestamp - twepoch) << timestampLeftShift) // 时间戳减去默认时间 再左移22位 与运算
            | (datacenterId << datacenterIdShift) // 机房号 左移17位 与运算
            | (workerId << workerIdShift) // 机器号 左移12位 与运算
            | sequence; // 序列号无需左移 直接进行与运算
        return id;
    }

    /**
     * 阻塞到下一个毫秒,直到获得新的时间戳
     *
     * @param lastTimestamp 上次生成ID的时间截
     * @return 当前时间戳
     */
    protected long tilNextMillis(long lastTimestamp) {
        long timestamp = timeGen();
        while (timestamp <= lastTimestamp) {
            timestamp = timeGen();
        }
        return timestamp;
    }

    /**
     * 返回以毫秒为单位的当前时间
     *
     * @return 当前时间(毫秒)
     */
    protected long timeGen() {
        return System.currentTimeMillis();
    }

    /**
     * @Description: 测试
     * @Author: yangjj_tc
     * @Date: 2022/12/30 10:22
     */
    public static void main(String[] args) {
        SnowflakeIdWorker idWorker = new SnowflakeIdWorker(0, 0);
        for (int i = 0; i < 1000; i++) {
            long id = idWorker.nextId();
            System.out.println(id);
        }
    }

    private static Long getWorkId() {
        try {
            String hostAddress = Inet4Address.getLocalHost().getHostAddress();
            int[] ints = StringUtils.toCodePoints(hostAddress);
            int sums = 0;
            for (int b : ints) {
                sums += b;
            }
            return (long)(sums % 32);
        } catch (UnknownHostException e) {
            return RandomUtils.nextLong(0, 31);
        }
    }

    private static Long getDataCenterId() {
        int[] ints = StringUtils.toCodePoints(SystemUtils.getHostName());
        int sums = 0;
        for (int i : ints) {
            sums += i;
        }
        return (long)(sums % 32);
    }
}
3.5. Redis 生成 ID
1、原理
利用 incr 或 incrby (原子自增)的特性。
bash
INCR order_id时间+用redis的incr自增命令(每日从1开始),代码如下:
java
public class RedisCounterRepository {
    private final DateTimeFormatter dateTimeFormatter = DateTimeFormatter.ofPattern("yyyyMMdd");
    private RedisTemplate<String, Object> redisTemplate;
    @Autowired
    public RedisCounterRepository(RedisTemplate<String, Object> redisTemplate) {
        this.redisTemplate = redisTemplate;
    }
    // 根据获取的自增数据,添加日期标识构造分布式全局唯一标识,changeNumPrefix是自己定义的随机前缀
    private String getNumFromRedis(String changeNumPrefix) {
        String dateStr = LocalDate.now().format(dateTimeFormatter);
        Long value = incrementNum(changeNumPrefix + dateStr);
        //不足4位补0,redis从1开始生成的,每天再次请0
        return dateStr + StringUtils.leftPad(String.valueOf(value), 4, '0');
    }
    // 从redis中获取自增数据(redis保证自增是原子操作)
    private long incrementNum(String key) {
        RedisConnectionFactory factory = redisTemplate.getConnectionFactory();
        if (null == factory) {
            log.error("Unable to connect to redis.");
            throw new UserException(AppStatus.INTERNAL_SERVER_ERROR);
        }
        RedisAtomicLong redisAtomicLong = new RedisAtomicLong(key, factory);
        long increment = redisAtomicLong.incrementAndGet();
        if (1 == increment) {
            // 如果数据是初次设置,需要设置超时时间
            redisAtomicLong.expire(1, TimeUnit.DAYS);
        }
        return increment;
    }
}
用redis实现需要注意一点,要考虑到redis持久化的问题。
redis有两种持久化方式:
1、RDB:
RDB会定时打一个快照进行持久化,假如连续自增但redis没及时持久化,而这会Redis挂掉了,重启Redis后会出现ID重复的情况。
2、AOF:
AOF会对每条写命令进行持久化,即使Redis挂掉了也不会出现ID重复的情况,但由于incr命令的特殊性,会导致Redis重启恢复的数据时间过长。
2、优缺点
优点:
- 全局递增
- Redis 单线程保证原子性
- 高性能
缺点:
- 依赖 Redis 可用性
- 需要持久化(RDB/AOF)保证重启不丢数据
- redis 宕机后不可用,RDB重启数据丢失会重复ID
- 自增,数据量易暴露。
3、适用:
高并发下的业务 ID(订单号、流水号等)
3.6. ZooKeeper 分布式 ID
1、原理
Zookeeper 有顺序节点(sequential node)特性,创建节点时自动附加单调递增序列号。
2、优缺点
优点:
- 顺序性保证
- 高可用(ZK 集群)
缺点:
- 性能不如 Redis/Snowflake
- ZK 不适合高频操作,适合低频 ID 生成
3、应用:
- 分布式事务编号
- 对顺序依赖较高的业务
4、对比
| 方案 | 唯一性 | 性能 | 趋势递增 | 有序 | 去中心化 | 依赖组件 | 适用场景 |
|---|---|---|---|---|---|---|---|
| DB 自增 | ✅ | 低 | ✅ | ✅ | ❌ | 数据库 | 小规模简单 |
| DB 号段 | ✅ | 中高 | ✅ | ✅ | ❌ | 数据库 | 大部分业务 ID |
| UUID | ✅ | 高 | ❌ | ❌ | ✅ | 无 | 高频生成、无序数据 |
| Snowflake | ✅ | 高 | ✅ | 部分 | ✅ | 时间同步 | 高并发,大部分业务 |
| Redis INCR | ✅ | 高 | ✅ | ✅ | ❌ | Redis | 高频递增 ID |
| Zookeeper 顺序 | ✅ | 低中 | ✅ | ✅ | ❌ | ZK | 少量且必须顺序的 ID |
总结
1、99% 场景 推荐 Snowflake(或改进版):高性能、可分布式部署、趋势递增
2、如果有绝对顺序性要求:Zookeeper 顺序节点
3、如果需要简单稳定且无极端高并发:数据库号段模式
4、无序 且不关心性能:UUID
5、Redis 已经是必备基础设施,且目标是高性能递增 ID:Redis INCR
参考文章