目录
DataStream API是Flink的核心层API,一个Flink程序,其实就是对DataStream的各种转换,具体来说,代码基本上都由以下几部分构成
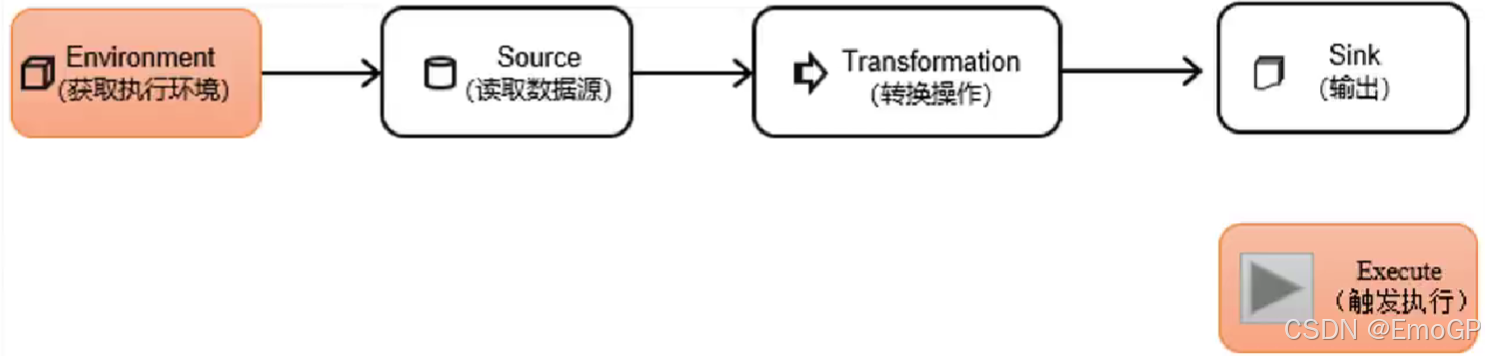
执行环境
Flink程序可以在各种上下文环境中运行:我们可以在本地JVM中执行程序,也可以提交到远程集群上运行。
不同的环境,代码的提交运行的过程会有所不同。这就要求我们在提交作业执行计算时,首先必须获取当前Flink的运行环境,从而建立起与Flink框架之间的联系。
我们要获取的执行环境,是StreamExecutionEnvironment类的对象,这是所有Flink程序的基础。在代码中创建执行环境的方式,就是调用这个类的静态方法,具体有以下三种。
getExecutionEnvironment
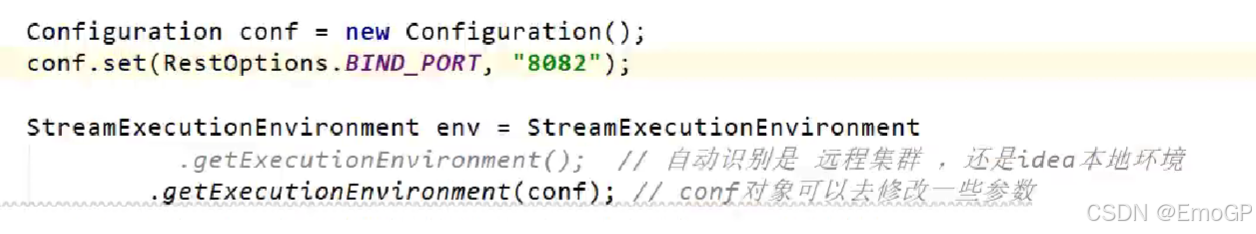
最简单的方式,就是直接调用getExecutionEnvironment方法。它会根据当前运行的上下文直接得到正确的结果:如果程序是独立运行的,就返回一个本地执行环境;如果是创建了jar包,然后从命令行调用它并提交到集群执行,那么就返回集群的执行环境。也就是说,这个方法会根据当前运行的方式,自行决定该返回什么样的运行环境。
clike
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();这种方式,用起来简单高效,是最常用的一种创建执行环境的方式。
createLocalEnvironment
这个方法返回一个本地执行环境。可以在调用时传入一个参数,指定默认的并行度;如果不传入,则默认并行度就是本地的CPU核心数。
StreamExecutionEnvironment localEnv = StreamExecutionEnvironment.createLocalEnvironment();
createRemoteEnvironment
这个方法返回集群执行环境。需要在调用时指定JobManager的主机名和端口号,并指定要在集群中运行的Jar包。
clike
StreamExecutionEnvironment remoteEnv = StreamExecutionEnvironment
  		.createRemoteEnvironment(
    		"host",                   // JobManager主机名
    		1234,                     // JobManager进程端口号
   			"path/to/jarFile.jar"  // 提交给JobManager的JAR包
		);
执行模式
从Flink 1.12开始,官方推荐的做法是直接使用DataStream API,在提交任务时通过将执行模式设为BATCH来进行批处理。不建议使用DataSet API。
clike
// 流处理环境
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
DataStream API执行模式包括:流执行模式、批执行模式和自动模式。
流执行模式(Streaming)
这是DataStream API最经典的模式,一般用于需要持续实时处理的无界数据流。默认情况下,程序使用的就是Streaming执行模式。
批执行模式(Batch)
专门用于批处理的执行模式。
自动模式(AutoMatic)
在这种模式下,将由程序根据输入数据源是否有界,来自动选择执行模式。
批执行模式的使用。主要有两种方式:
(1)通过命令行配置
clike
bin/flink run -Dexecution.runtime-mode=BATCH ...在提交作业时,增加execution.runtime-mode参数,指定值为BATCH。
(2)通过代码配置
clike
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

env.setRuntimeMode(RuntimeExecutionMode.BATCH);
在代码中,直接基于执行环境调用setRuntimeMode方法,传入BATCH模式。
实际应用中一般不会在代码中配置,而是使用命令行,这样更加灵活。
触发程序执行
需要注意的是,写完输出(sink)操作并不代表程序已经结束。因为当main()方法被调用时,其实只是定义了作业的每个执行操作,然后添加到数据流图中;这时并没有真正处理数据------因为数据可能还没来。Flink是由事件驱动的,只有等到数据到来,才会触发真正的计算,这也被称为"延迟执行"或"懒执行"。
所以我们需要显式地调用执行环境的execute()方法,来触发程序执行。execute()方法将一直等待作业完成,然后返回一个执行结果(JobExecutionResult)。
clike
env.execute();-
默认env.execute()触发一个flink job,一个main方法可以调用多个execute,但是没有意义,执行到第一个就会阻塞住
-
env.executeAsync(),异步触发,不阻塞,一个main方法里,executeAsync()个数 = 生成的flink job数