1 RDD的数据是过程数据
- RDD之间进行相互迭代计算(Transform转换),当执行开启后,新的RDD生成,老的RDD消失
- RDD的数据是过程数据,只在处理的过程中存在,一旦处理完成就不见了。
- 这个特性可以最大化利用资源,老的RDD没用了,就从内存中清除,给后续的计算腾出内存。
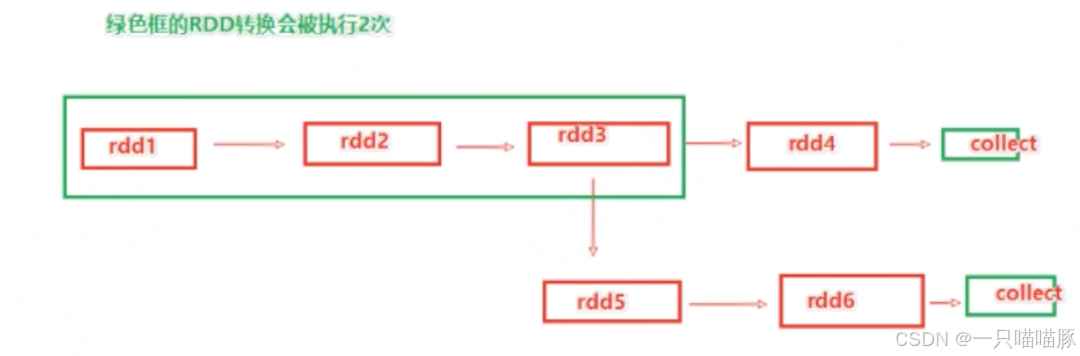
2 RDD缓存
-
RDD缓存:Spark提供了缓存API,可以通过调用API将指定的RDD数据保留在内存或硬盘上
-
缓存在设计上认为是不安全的,会保存前置RDD的血缘关系
-
缓存是分散存储的
RDD3被两次使用,可以加入缓存进行优化
rdd.cache() # 缓存到内存中
rdd.persist(StorageLevel.MEMORY_ONLY) # 仅内存缓存
rdd.persist(StorageLevel.MEMORY_ONLY_2) # 仅内存缓存,2副本
rdd.persist(StorageLevel.DISK_ONLY) # 仅磁盘缓存
rdd.persist(StorageLevel.DISK_ONLY_2) # 仅磁盘缓存,2副本
rdd.persist(StorageLevel.MEMORY_AND_DISK) # 先缓存到内存,不够缓存到硬盘
rdd.persist(StorageLevel.MEMORY_AND_DISK_2) # 先缓存到内存,不够缓存到硬盘,2副本
rdd.persist(StorageLevel.OFF_HEAP) # 堆外内存(系统内存)一般建议使用rdd3.persist(StorageLevel.MEMORY_AND_DISK)
内存较小的集群,建议使用rdd3.persist(StorageLevel.DISK_ONLY) 或使用CheckPoint
主动清理缓存的API
rdd.unperisist()
3 RDD CheckPoint
-
CheckPoint仅支持硬盘缓存(HDFS)
-
CheckPoint设计上认为是安全的,不保留血缘关系
-
CheckPoint是集中收集各个分区数据进行存储的
设置CheckPoint第一件事:选择CP的保存路径
如果是local模式,可以支持本地文件系统,如果在集群运行,务必用HDFS
sc.setCheckpointDir("hdfs://node1:8020/output/aaa123ckp")
使用时直接调用checkpoint算子即可
rdd.checkpoint()
4 缓存 VS CheckPoint
- CheckPoint不论分区数量多少,风险一致;缓存分区越多,风险越高
- CheckPoint支持写入HDFS;缓存不支持。HDFS是高可靠存储,CheckPoint被认为是安全的
- CheckPoint不支持内存;缓存支持。缓存如果写内存,性能比CheckPoint好
- CheckPoint设计上认为是安全的,所以不保留血缘关系;缓存设计上认为是不安全的,所以保留血缘关系。