PySpark数据输入
1.理解RDD对象
2.掌握PySpark数据输入的2种方法
RDD对象
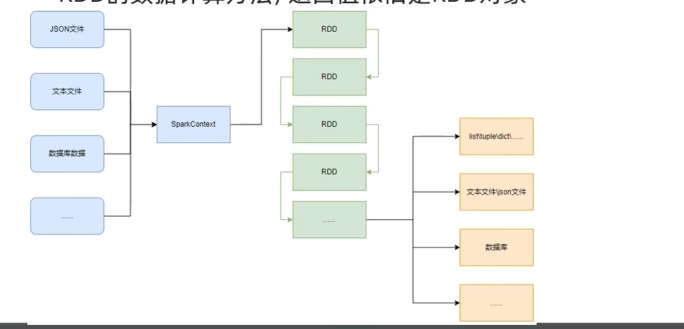
PySpark支持多种数据的输入,在输入完成后,都会得到一个:RDD类的对象
RDD全称为:弹性分布式数据集(Resilient Distributed Datasets)
PySpark针对数据的处理,都是以RDD对象作为载体,即:
数据存储在RDD内;各类数据的计算方法,也都是RDD的成员方法;RDD的数据计算方法,返回值仍旧是RDD对象
Python数据容器转RDD对象
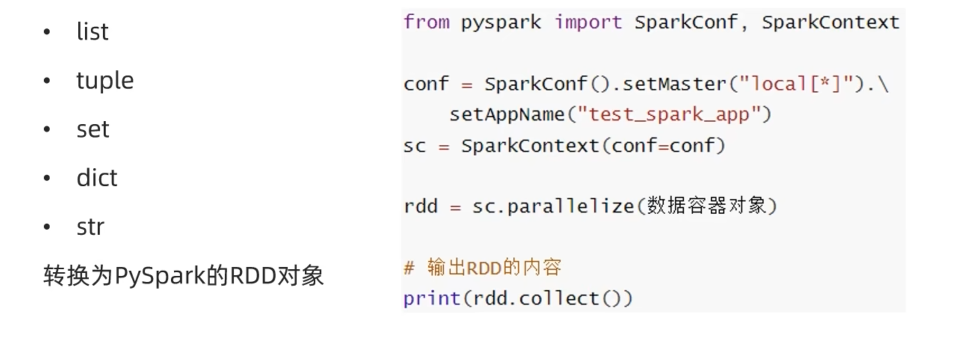
PySpark支持通过SparkContext对象的parallelize成员方法,将
注意:
字符串会被拆分为1个个的字符,存入RDD对象;字典仅有key会被存入RDD对象
python
"""
通过PySpark代码加载数据,即数据输入
"""
from pyspark import SparkContext
sc = SparkContext(conf=conf)

# 通过paralelize 方法将Pythn对象加载到Spark内,成为RDD对象
rdd1 = sc.paralelize([1,2,3,4,5])
rdd2 = sc.paralelize((1,2,3,4,5))
rdd3 = sc.paralelize("abcdedf")
rdd4 = sc.paralelize({1,2,3,4,5})
rdd5 = sc.paralelize("key1":"value1","key2":"value2")

# 如果要查看RDD里面有什么内容,需要用collect()方法
print(rdd1.collect())
print(rdd2.collect())
print(rdd3.collect())
print(rdd4.collect())
print(rdd5.collect())

sc.stop()
# 用过textFile方法,读取文件数据加载到Spark内,成为RDD对象
rdd = sc.textFile("D:/hello.txt")
print(rdd.collect())

sc.stop()
读取文件转RDD对象
PySpark也支持通过SparkContext入口对象,来读取文件,来构建出RDD对象
python
from pyspark import SparkContext

conf = SparkConf().ssetMaster("local[*]").setAppName("test_spark_app")
sc = SparkContext(conf=conf)

rdd = sc.textFile(文件路径)

# 打印RDD内容
print(rdd.collect())
总结
1.RDD对象是什么?为什么要使用它
RDD对象称之为分布式弹性数据集,是PySpark中数据计算的载体,它可以:提供数据存储;提供数据计算的各类方法;数据计算的方法,返回值仍旧是RDD(RDD迭代计算)后续对数据进行各类计算,都是基于RDD对象进行
2.如何输入数据到Spark(即得到RDD对象)
通过SparkContext的parallelize成员方法,将Python数据容器转换为RDD对象
通过SparkContext的textFile成员方法,读取文本文件得到RDD对象