【GPT入门】第65课 vllm指定其他卡运行的方法,解决单卡CUDA不足的问题

【GPT入门】第65课 vllm指定其他卡运行的方法,解决单卡CUDA不足的问题

1.原理

要将 vllm 部署在第二张 GPU 卡上(设备编号为 1),只需在命令前添加 CUDA_VISIBLE_DEVICES=1 环境变量指定 GPU 设备:

bash 复制代码
CUDA_VISIBLE_DEVICES=1 vllm serve /root/autodl-tmp/models_xxzh/Qwen/Qwen1.5-1.8B-Chat
说明:

  • CUDA_VISIBLE_DEVICES=1 是核心配置,强制程序仅使用编号为 1 的 GPU(第二张卡,GPU 编号从 0 开始计数)

  • 若需验证 GPU 编号,可先运行 nvidia-smi 查看所有 GPU 设备的序号和状态

  • 如需额外参数(如指定端口、并发数等),可直接追加在命令后,例如:

    bash 复制代码
    CUDA_VISIBLE_DEVICES=1 vllm serve /root/autodl-tmp/models_xxzh/Qwen/Qwen1.5-1.8B-Chat --port 8000 --max-num-seqs 32

2.实践

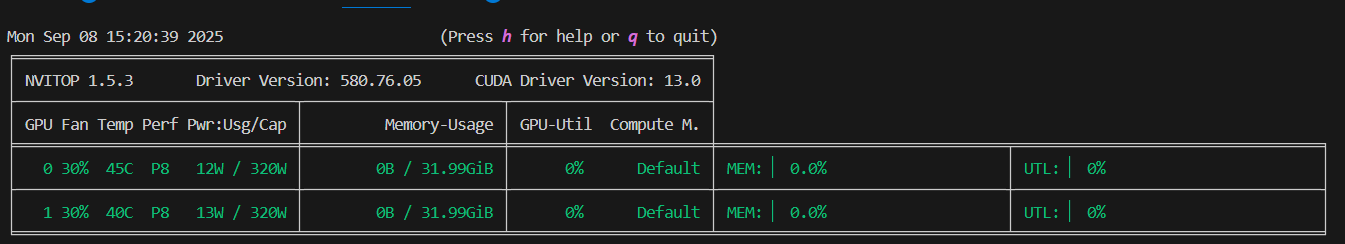
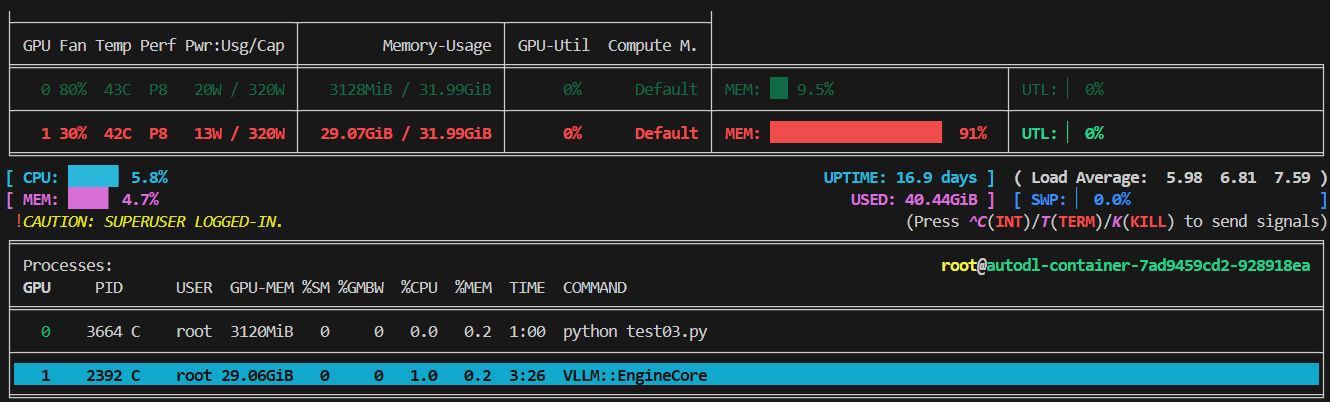
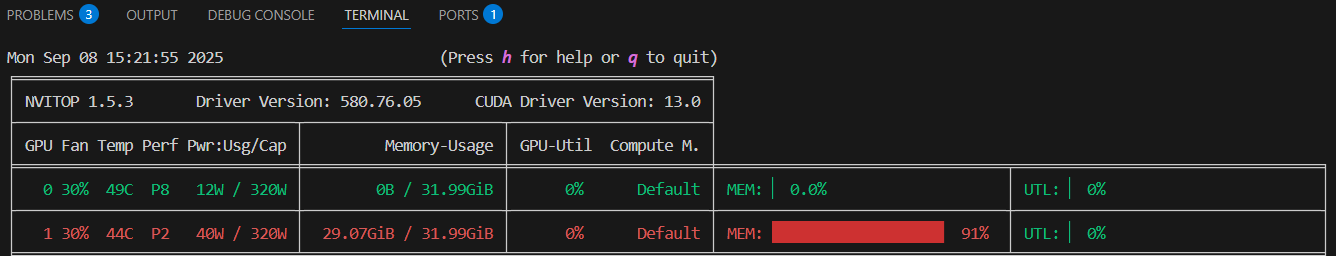
下面的图是nvitop, (通过pip install nvitop 安装) 的截图

  • 运行前
  • 指定第一个卡运行
    命令:
c 复制代码
CUDA_VISIBLE_DEVICES=1  vllm serve /root/autodl-tmp/models_xxzh/Qwen/Qwen1.5-1.8B-Chat
  • 其他llm程序默认在第0个卡运行
相关推荐
可乐ea3 小时前
智能体的模型列表为什么要从三处来源合成:一次让 GPT-6.1 Sol 选不上的发布延迟
人工智能·gpt·chatgpt·智能体框架·模型列表·多源数据合成·客户端工程
AllData公司负责人4 小时前
AI大模型数据开发底座系列说明书:AllData集成DB-GPT开源项目建设 AI 多模态分析底座,涵盖模态解析/智能大屏/MCP 扩展!
大数据·数据库·人工智能·gpt·数据采集·数据接入·模态解析
汤姆宝库1 天前
从零手写一个GPT:预训练循环的完整实现
gpt
夕阳_醉了2 天前
Codex 客户端从装好到跑通:第三方 API 接入与配置避坑指南
人工智能·gpt·openai·codex·ai 编程
变量棱镜4 天前
GPT-6.2 灰度的 3D 演示火了
gpt
一缕82年的清风4 天前
没买显卡,我用 Google Colab 免费跑通了 AI 生图:从零部署 Z-Image Turbo
gpt·claude·gemini
謓泽6 天前
【插件】用写网页的方式做视频?HyperFrames 让我重新理解了“做视频“这件事!
gpt·ai·大模型·音视频·媒体·claude·视频
一缕82年的清风8 天前
7 美元芯片如何给 AI 挂上“物理手眼”?从 AirPlay 视讯流到 USB HID 物理注入的真实硬件黑客流
gpt·claude
敢敢のwings9 天前
用 GPT‑6 构建可交互 USD 资产:从 USDCraft 到一扇能用于仿真的柜门
gpt
七牛云行业应用10 天前
MIT “权重空间编程”:GPT-6 Astra 修改 0.016% 的 Qwen 权重,MATH-500 从 7.9% 升至 48.1%
人工智能·gpt·ai