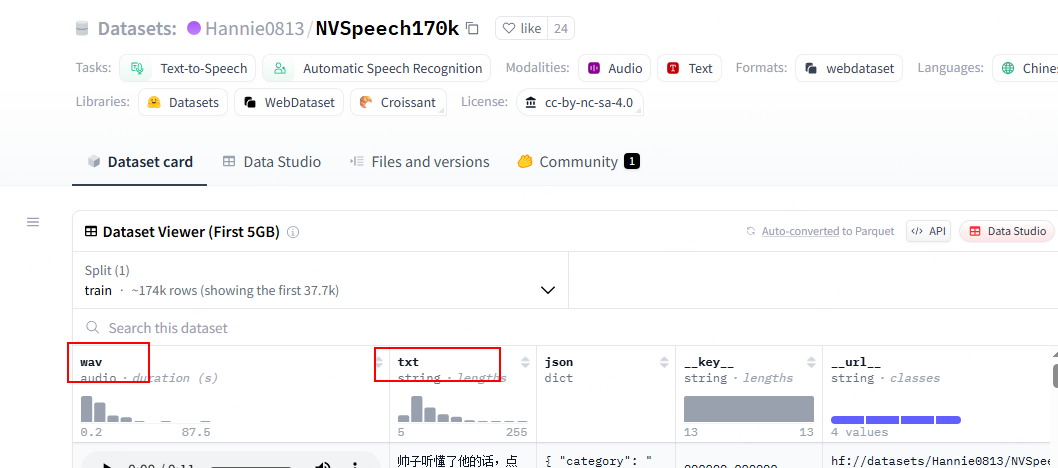
先从 hugging face 上进行下载:https://huggingface.co/datasets/Hannie0813/NVSpeech170k,然后通过一下脚本提取音频和文本,方便后续处理。
python
import os

from datasets import load_dataset
import soundfile as sf
from tqdm import tqdm

# --- 1. 配置参数 ---

# 【【【 请在这里修改为您本地的数据集路径 】】】
# 这个路径应该是包含 .arrow 文件和 dataset_info.json 的文件夹。
# 例如: "D:\\my_hf_datasets\\Hannie0813___NVSpeech170k"
# 或者: "/home/user/.cache/huggingface/datasets/Hannie0813___NVSpeech170k/default/0.0.0/..."
LOCAL_DATASET_PATH = "./xxx/NVSpeech_170k" # <--- !!! 修改这里 !!!

# 您要使用的分割(通常是 'train')
DATA_SPLIT = "train"
# 保存文件的输出文件夹名称
OUTPUT_DIR = "extract_audio"


def main():
    """
    主函数:从本地文件夹加载Hugging Face数据集,并将音频和文本提取出来。
    """
    # --- 2. 检查本地路径配置 ---
    if LOCAL_DATASET_PATH == "/path/to/your/local/dataset_folder":
        print("错误:请先在脚本中修改 'LOCAL_DATASET_PATH' 变量,将其指向您本地的数据集文件夹。")
        return

    if not os.path.isdir(LOCAL_DATASET_PATH):
        print(f"错误:指定的本地路径 '{LOCAL_DATASET_PATH}' 不是一个有效的文件夹,请检查。")
        return

    print(f"将从本地路径加载数据集: '{LOCAL_DATASET_PATH}'")
    print("-" * 30)

    # --- 3. 创建输出文件夹 ---
    print(f"准备将文件保存到 '{OUTPUT_DIR}/' 文件夹中...")
    os.makedirs(OUTPUT_DIR, exist_ok=True)
    print("文件夹准备就绪。")
    print("-" * 30)

    # --- 4. 从本地加载数据集 ---
    print("开始加载数据集...")
    try:
        # 直接将本地文件夹路径传给 load_dataset
        dataset = load_dataset(LOCAL_DATASET_PATH)
        print("数据集从本地加载成功!")
        print(dataset.keys())
    except Exception as e:
        print(f"错误:数据集加载失败。请确保指定的路径是正确的数据集缓存文件夹。")
        print(f"详细错误信息: {e}")
        return

    print("-" * 30)

    # --- 5. 遍历数据集并保存文件 ---
    # 选择我们想要处理的数据分割
    if DATA_SPLIT not in dataset:
        print(f"错误:在数据集中找不到名为 '{DATA_SPLIT}' 的分割。可用的分割有: {list(dataset.keys())}")
        return

    data_split = dataset[DATA_SPLIT]

    print(f"开始处理 '{DATA_SPLIT}' 分割中的 {len(data_split)} 条数据...")

    # 使用 tqdm 创建一个进度条
    for idx, sample in enumerate(data_split):
        print('sample: ', sample.keys())
        try:
            # 从样本字典中提取信息
            audio_info = sample['wav']
            text_content = sample['txt']
            file_id = str(idx).zfill(5)

            # 提取音频数据和采样率
            audio_array = audio_info['array']
            sampling_rate = audio_info['sampling_rate']

            # 定义输出文件路径
            wav_path = os.path.join(OUTPUT_DIR, f"{file_id}.wav")
            txt_path = os.path.join(OUTPUT_DIR, f"{file_id}.txt")

            # 保存文件
            sf.write(wav_path, audio_array, sampling_rate)
            with open(txt_path, 'w', encoding='utf-8') as f:
                f.write(text_content)

        except Exception as e:
            print(f"\n处理样本 {sample.get('id', '未知ID')} 时出错: {e}")

    print("-" * 30)
    print("所有文件提取完成!")
    print(f"请在 '{os.path.abspath(OUTPUT_DIR)}' 文件夹中查看结果。")

if __name__ == "__main__":
    main()