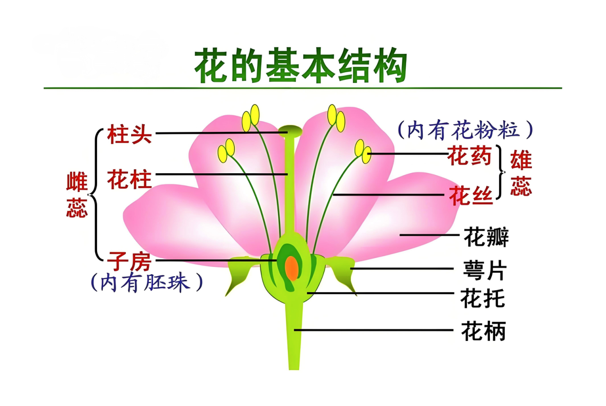
1.5 第一个机器学习应用:鸢(yuan)尾花分类
代码1.1
python
# ----------------------------数据加载与探索----------------------------
# 从sklearn的数据集模块导入加载鸢尾花数据集的函数
from sklearn.datasets import load_iris
# 加载鸢尾花数据集,返回一个Bunch对象(类似字典的结构)
iris_dataset = load_iris()

# 打印数据集包含的键,了解数据集的组成部分
print('iris_dataset.keys() = ',iris_dataset.keys())
# 查看特征数据的数据类型(通常是numpy数组)
print(type(iris_dataset['data']))
# 查看特征数据的形状 (样本数, 特征数),鸢尾花数据集包含150个样本,每个样本有4个特征
print(iris_dataset['data'].shape)
# 查看标签数据的形状 (样本数,),每个样本对应一个标签
print(iris_dataset['target'].shape)
# 查看标签对应的鸢尾花品种名称(3个类别)
print(iris_dataset['target_names'])
# 查看标签值(0, 1, 2分别代表三种不同的鸢尾花)
print(iris_dataset['target'])
# 查看前6个样本的特征数据(4个特征分别是:花萼长度、花萼宽度、花瓣长度、花瓣宽度)
print(iris_dataset['data'][:6])

# ----------------------------数据划分----------------------------
# 从模型选择模块导入训练集和测试集分割函数
from sklearn.model_selection import train_test_split
# 将数据集划分为训练集(用于训练模型)和测试集(用于评估模型)
# X_train: 训练集特征, X_test: 测试集特征, y_train: 训练集标签, y_test: 测试集标签
# random_state=0 用于固定随机种子,确保每次运行划分结果一致
X_train, X_test, y_train, y_test = train_test_split(
    iris_dataset['data'], iris_dataset['target'], random_state=0)

# 打印训练集的前10个特征数据,查看划分结果
print("X_train:{}".format(X_train[:10]))
# 打印训练集的前10个标签数据,查看特征与标签的对应关系
print("y_train:{}".format(y_train[:10]))

# ----------------------------模型构建与训练----------------------------
# 从近邻算法模块导入K近邻分类器
from sklearn.neighbors import KNeighborsClassifier
# 创建KNN分类器对象,设置参数n_neighbors=1表示使用最近的1个邻居进行预测
knn = KNeighborsClassifier(n_neighbors=1)
# 使用训练集数据训练模型,拟合特征与标签之间的关系
knn.fit(X_train, y_train)

# 打印KNN分类器的详细参数(默认参数)
KNeighborsClassifier(algorithm='auto', leaf_size=30, metric='minkowski',
                     metric_params=None, n_jobs=1, n_neighbors=1, p=2,
                     weights='uniform')

# ----------------------------模型预测----------------------------
# 导入numpy库,用于处理数组数据
import numpy as np
# 创建一个新的样本数据(花萼长5,花萼宽2.9,花瓣长1,花瓣宽0.2)
Xnew = np.array([[5, 2.9, 1, 0.2]])
# 使用训练好的模型对新样本进行预测,得到预测的标签
prediction = knn.predict(Xnew)
# 打印预测的标签值
print("Prediction: {}".format(prediction))
# 根据标签值获取对应的鸢尾花品种名称并打印
print("Predicted target name:{}".format(iris_dataset['target_names'][prediction]))

# ----------------------------模型评估----------------------------
# 使用测试集评估模型性能,score方法返回模型在测试集上的准确率
# 准确率 = 预测正确的样本数 / 测试集总样本数
print("Test set score:{}".format(knn.score(X_test, y_test)))
运行结果
C:\Users\71042\.conda\envs\tf_gpu_new\python.exe E:\教学\2025教学\机器学习\机器学习数据代码\1-2章数据代码\ch1.1_iris_classification.py
iris_dataset.keys() = dict_keys('data', 'target', 'frame', 'target_names', 'DESCR', 'feature_names', 'filename', 'data_module')
<class 'numpy.ndarray'>
(150, 4)
(150,)
'setosa' 'versicolor' 'virginica'
[0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0
0 0 0 0 0 0 0 0 0 0 0 0 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 2 2 2 2 2 2 2 2 2 2 2
2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2
2 2]
\[5.1 3.5 1.4 0.2
4.9 3. 1.4 0.2
4.7 3.2 1.3 0.2
4.6 3.1 1.5 0.2
5. 3.6 1.4 0.2
5.4 3.9 1.7 0.4\]
X_train:\[5.9 3. 4.2 1.5
5.8 2.6 4. 1.2
6.8 3. 5.5 2.1
4.7 3.2 1.3 0.2
6.9 3.1 5.1 2.3
5. 3.5 1.6 0.6
5.4 3.7 1.5 0.2
5. 2. 3.5 1.
6.5 3. 5.5 1.8
6.7 3.3 5.7 2.5\]
y_train:1 1 2 0 2 0 0 1 2 2
Prediction: 0
Predicted target name:'setosa'
Test set score:0.9736842105263158
Process finished with exit code 0