Linux编译器- gcc/g++
1.背景知识
1.预处理(进行宏替换)
2.编译(生成汇编)
3.汇编(生成机器可识别的代码)
4.链接(生成可执行文件或库文件)
2.gcc/g++语法
语法:gcc/g++ 选项 文件
常用选项:
1)-E 只进行预处理,这个不生成文件,你只需要重定向到一个输出文件里面(否则将把预处理后的结果打印到屏幕上)。
2)-S 编译到汇编语言,不进行汇编和链接,即只需要进行预处理和翻译。
3)-c 编译到目标文件。
4)-o 将处理结果输出到指定文件,该选项后续紧跟输出文件名。
5)-static 此选项对生成的文件采用静态链接。
6)-g 生成调试信息(如不携带该选项则生成默认文件release版本)。
7)-shared 此选项将尽量使用动态库,生成文件较小。
8)-w 不生成任何警告信息。
9)Wall生成所有警告信息。
10)-O0/-O1/-O2/-O3编译器优化选项的四个级别,-O0表示没有优化,-O1为缺省值,O3优化级别最高。
预处理(进行宏替换)
[zuoge@VM-24-14-centos ~]$ gcc -E mycode.c -o mycode.i
//告诉gcc,从现在开始进行程序的翻译,将预处理工作做完就停下来,不要往后走了
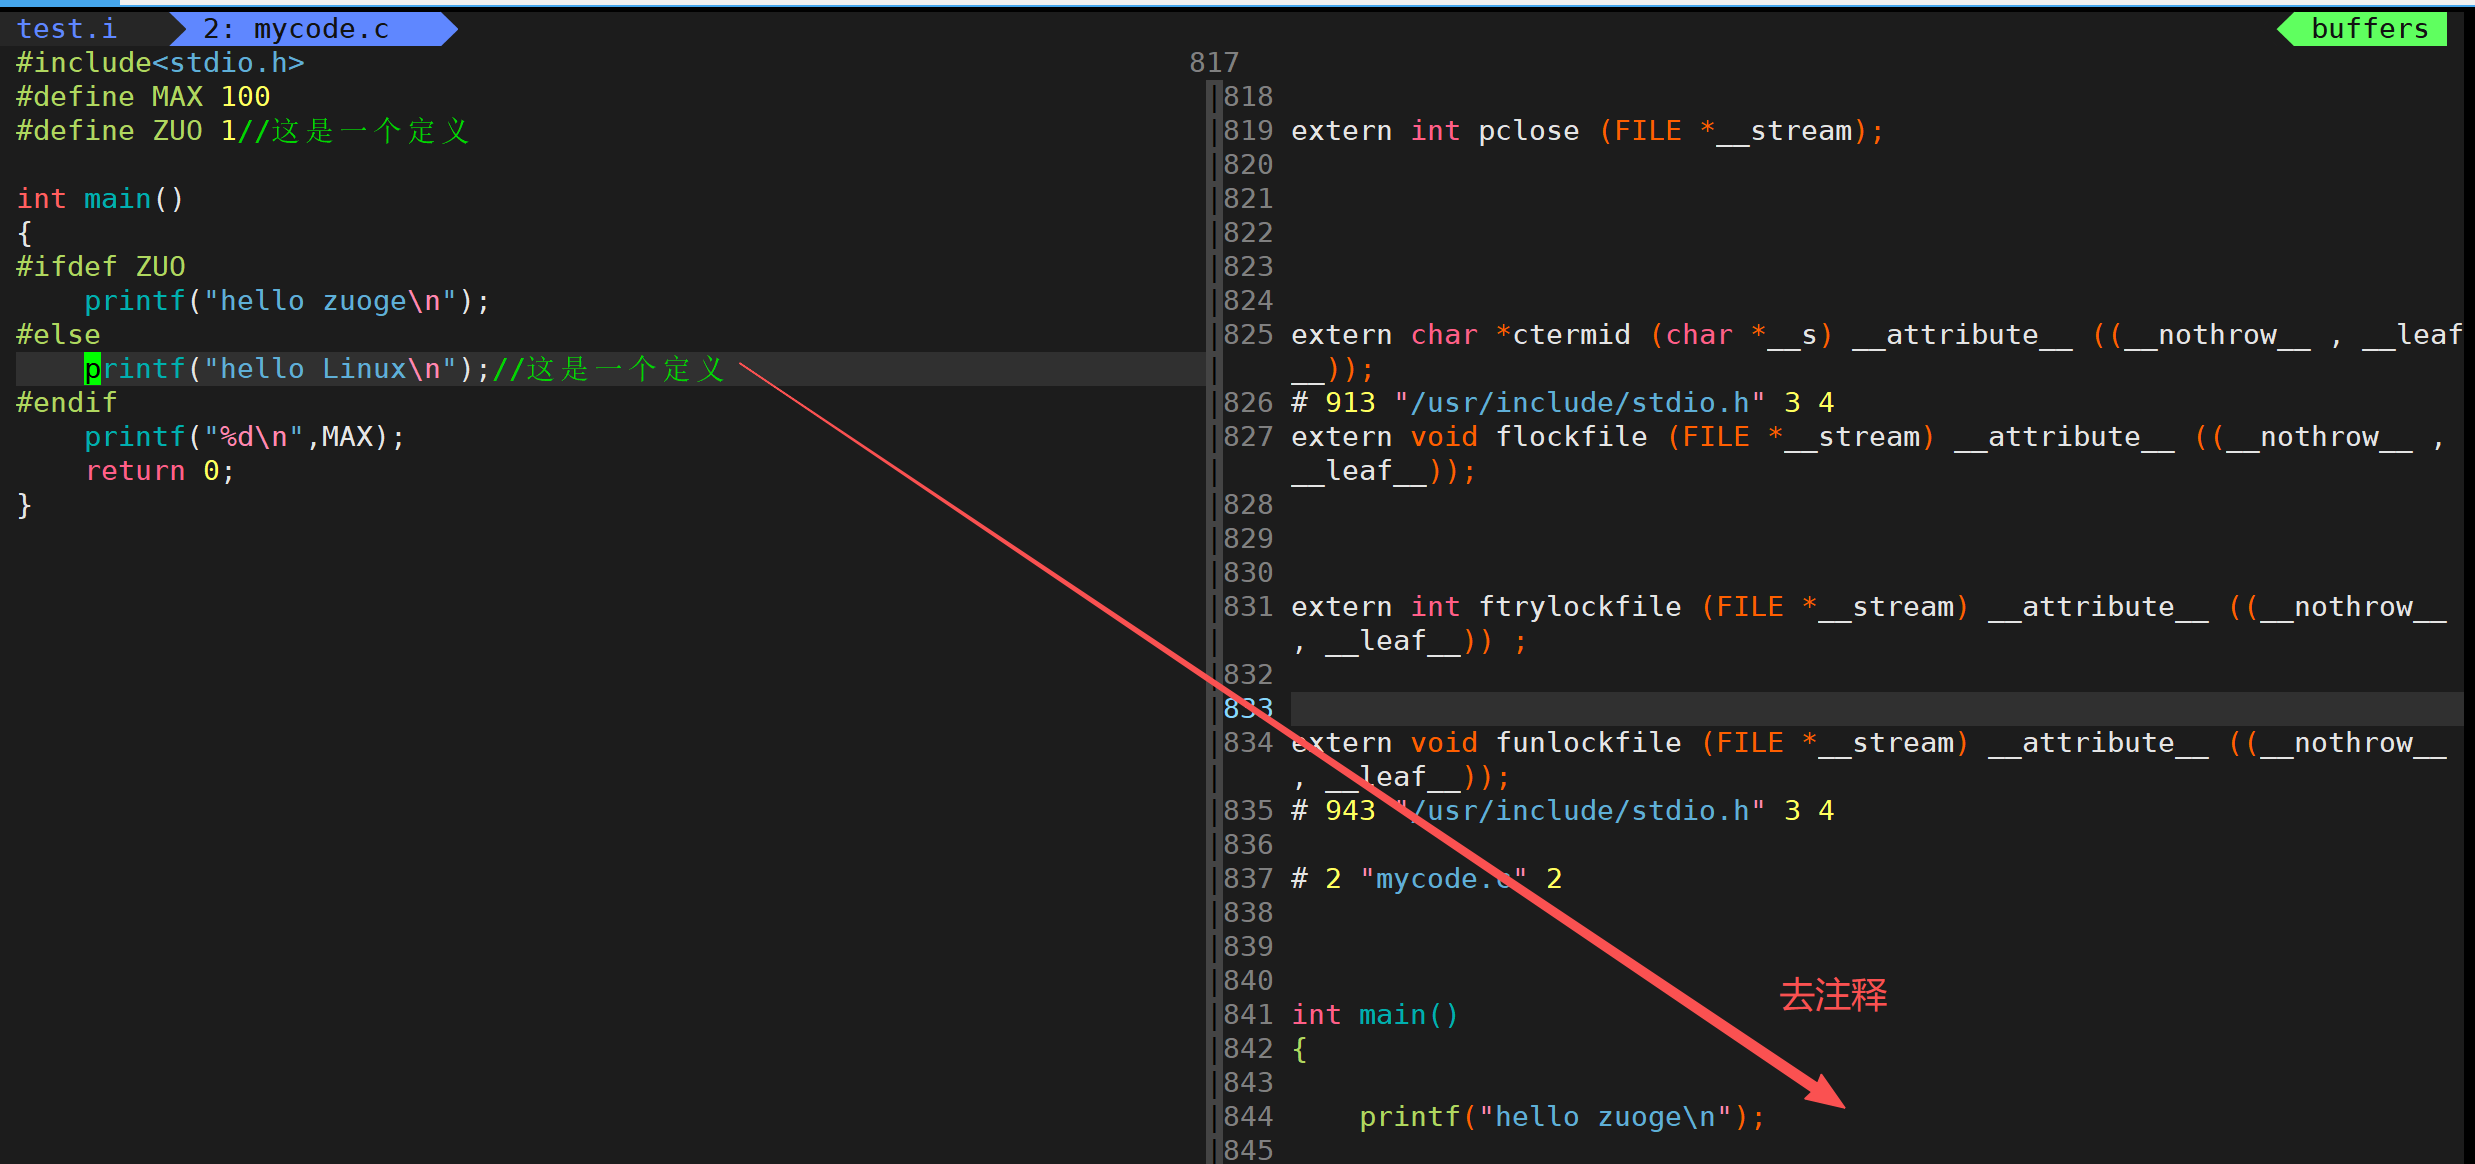
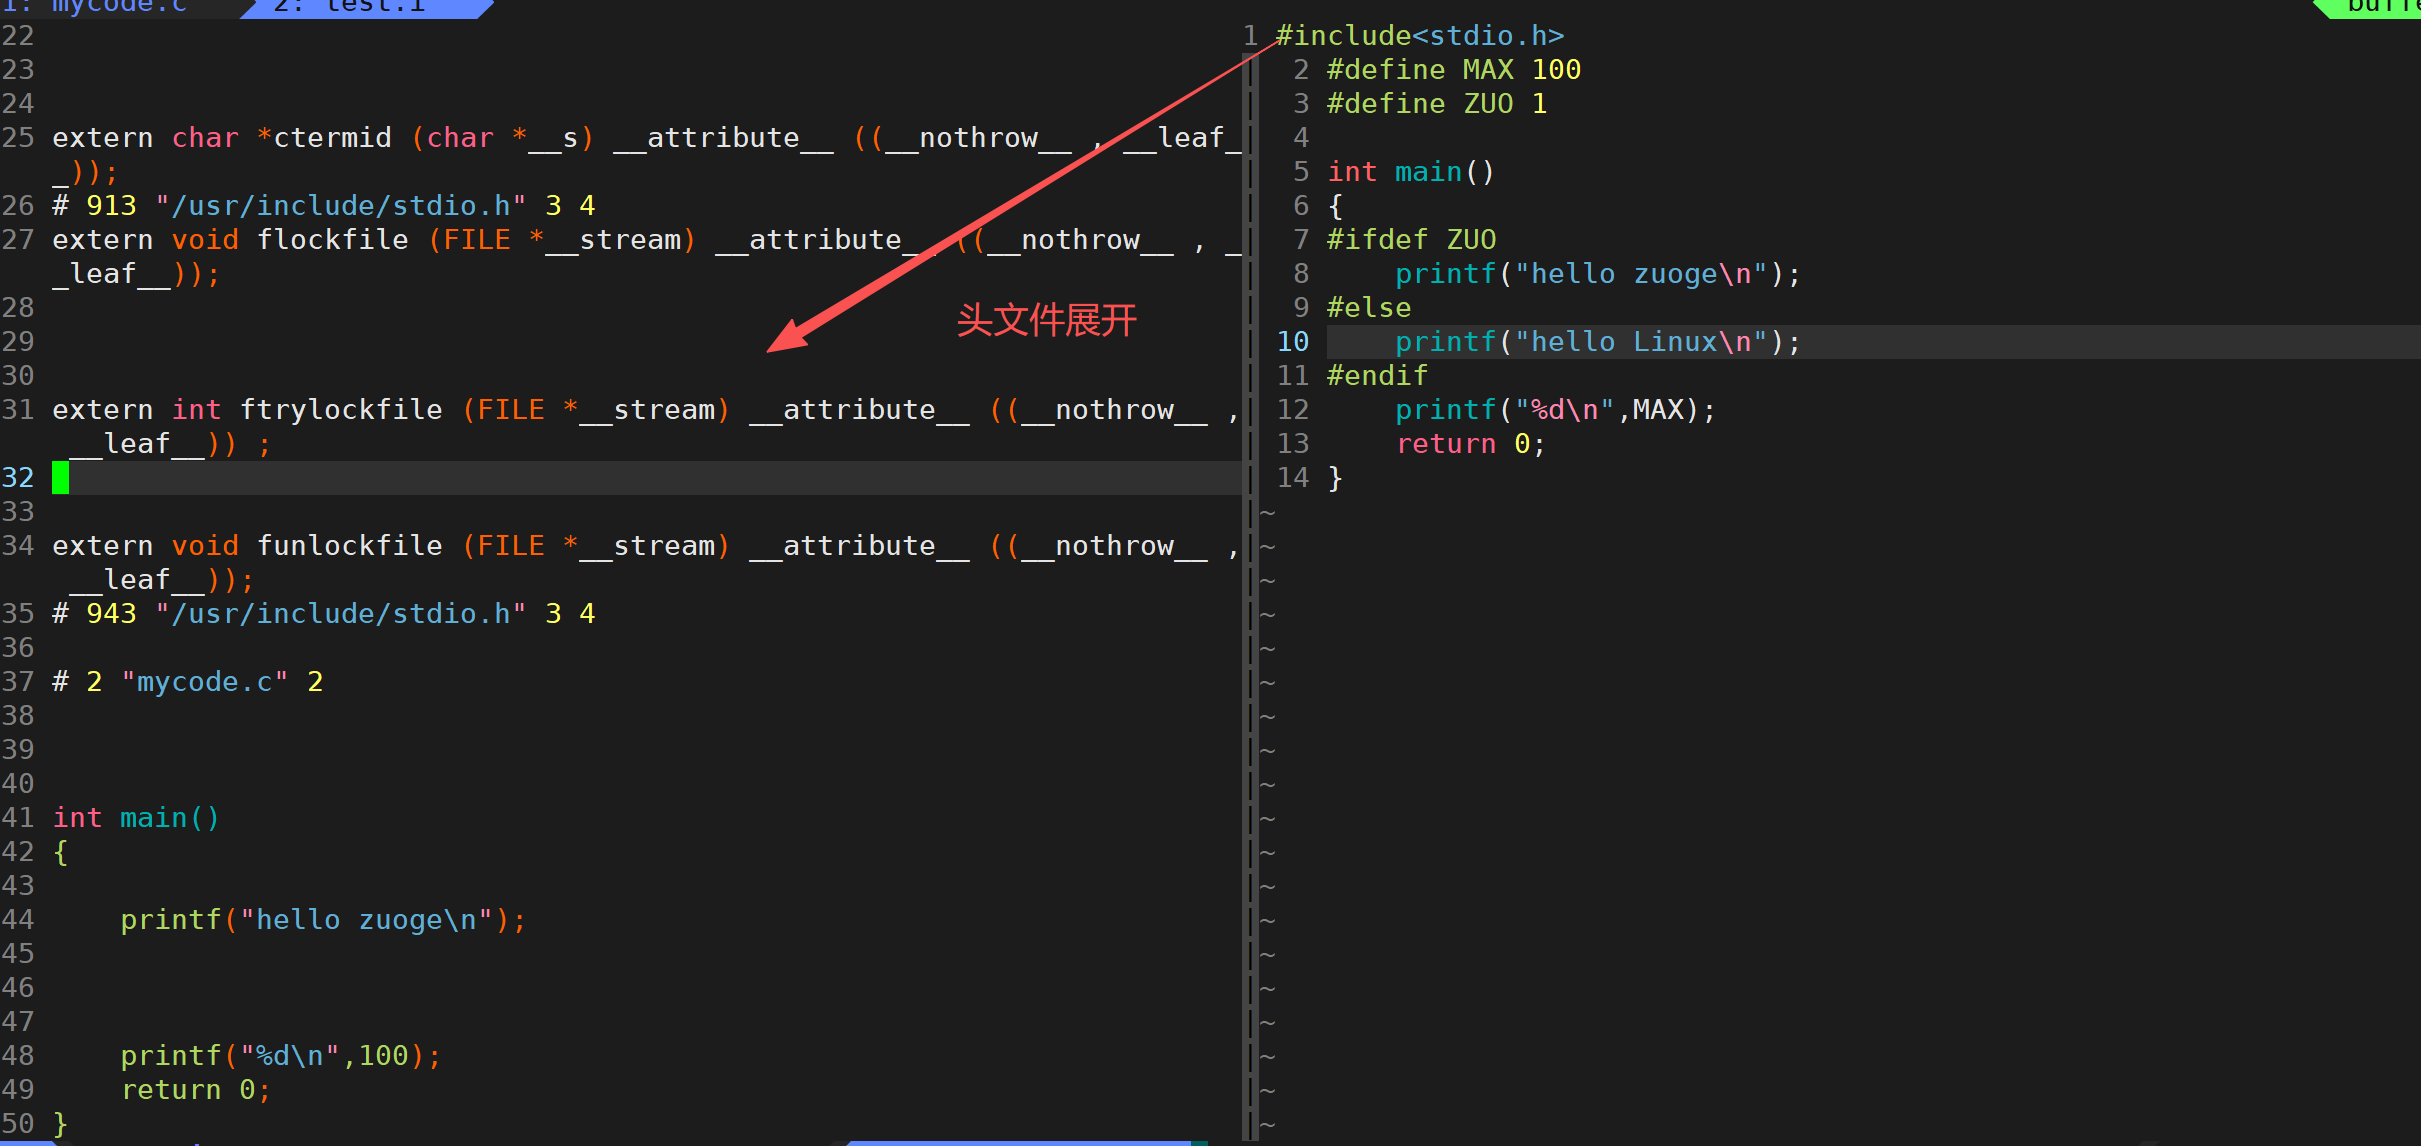
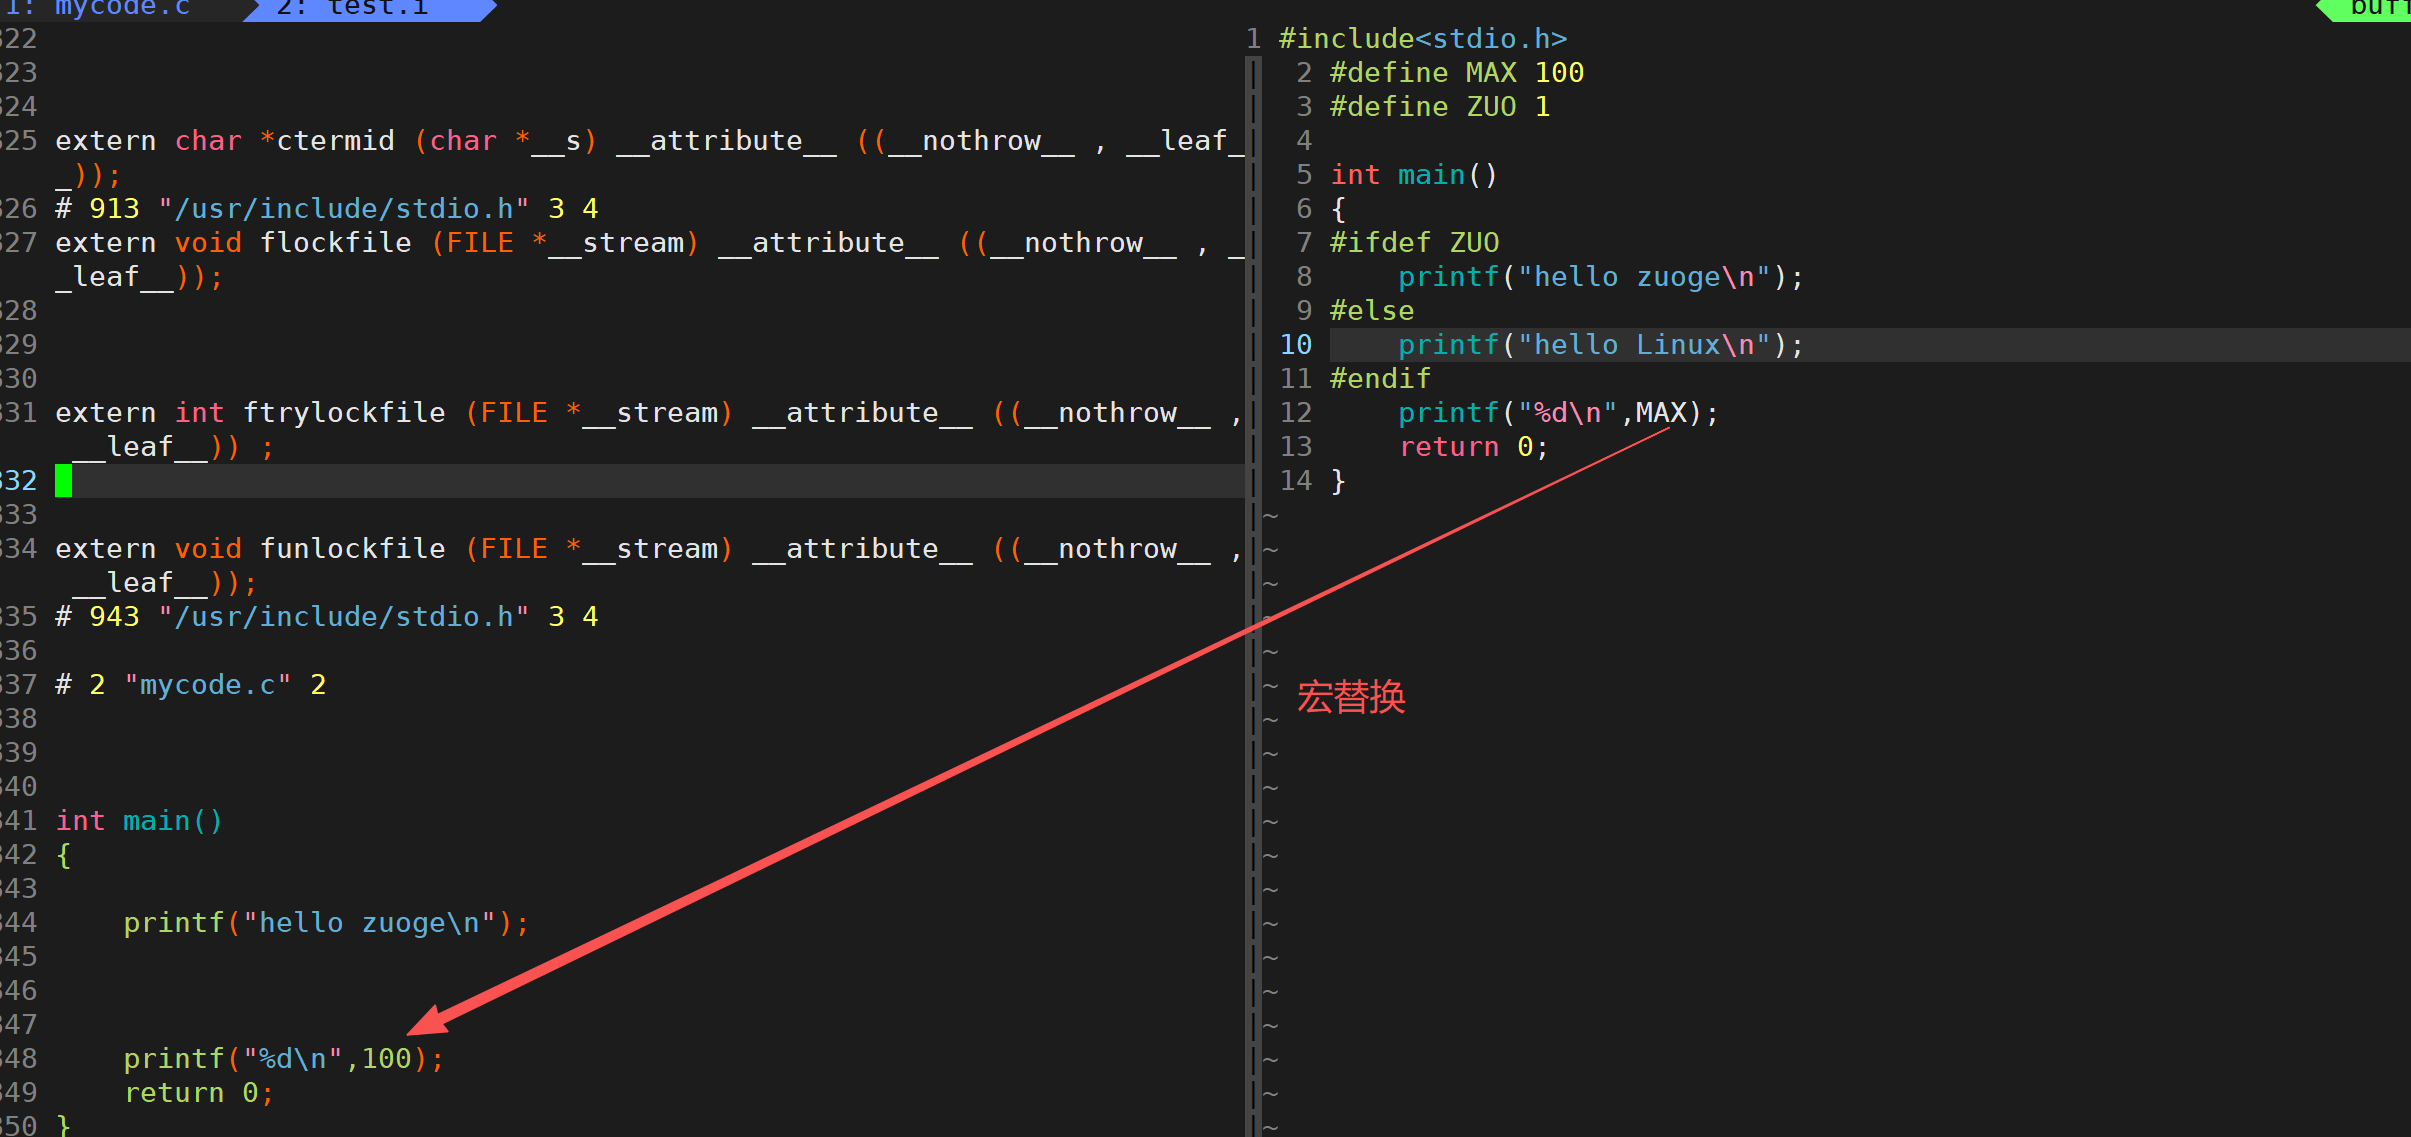
~预处理功能主要包括头文件展开,去注释,宏替换,条件编译等等。
~预处理指令是以#开头的代码行。
-E选项的作用是让gcc/g++在预处理结束后就停止编译。
-o选项是指目标文件,"xxx.i"文件为已经过预处理的原始程序。
a.去注释
b.头文件展开
c.条件编译
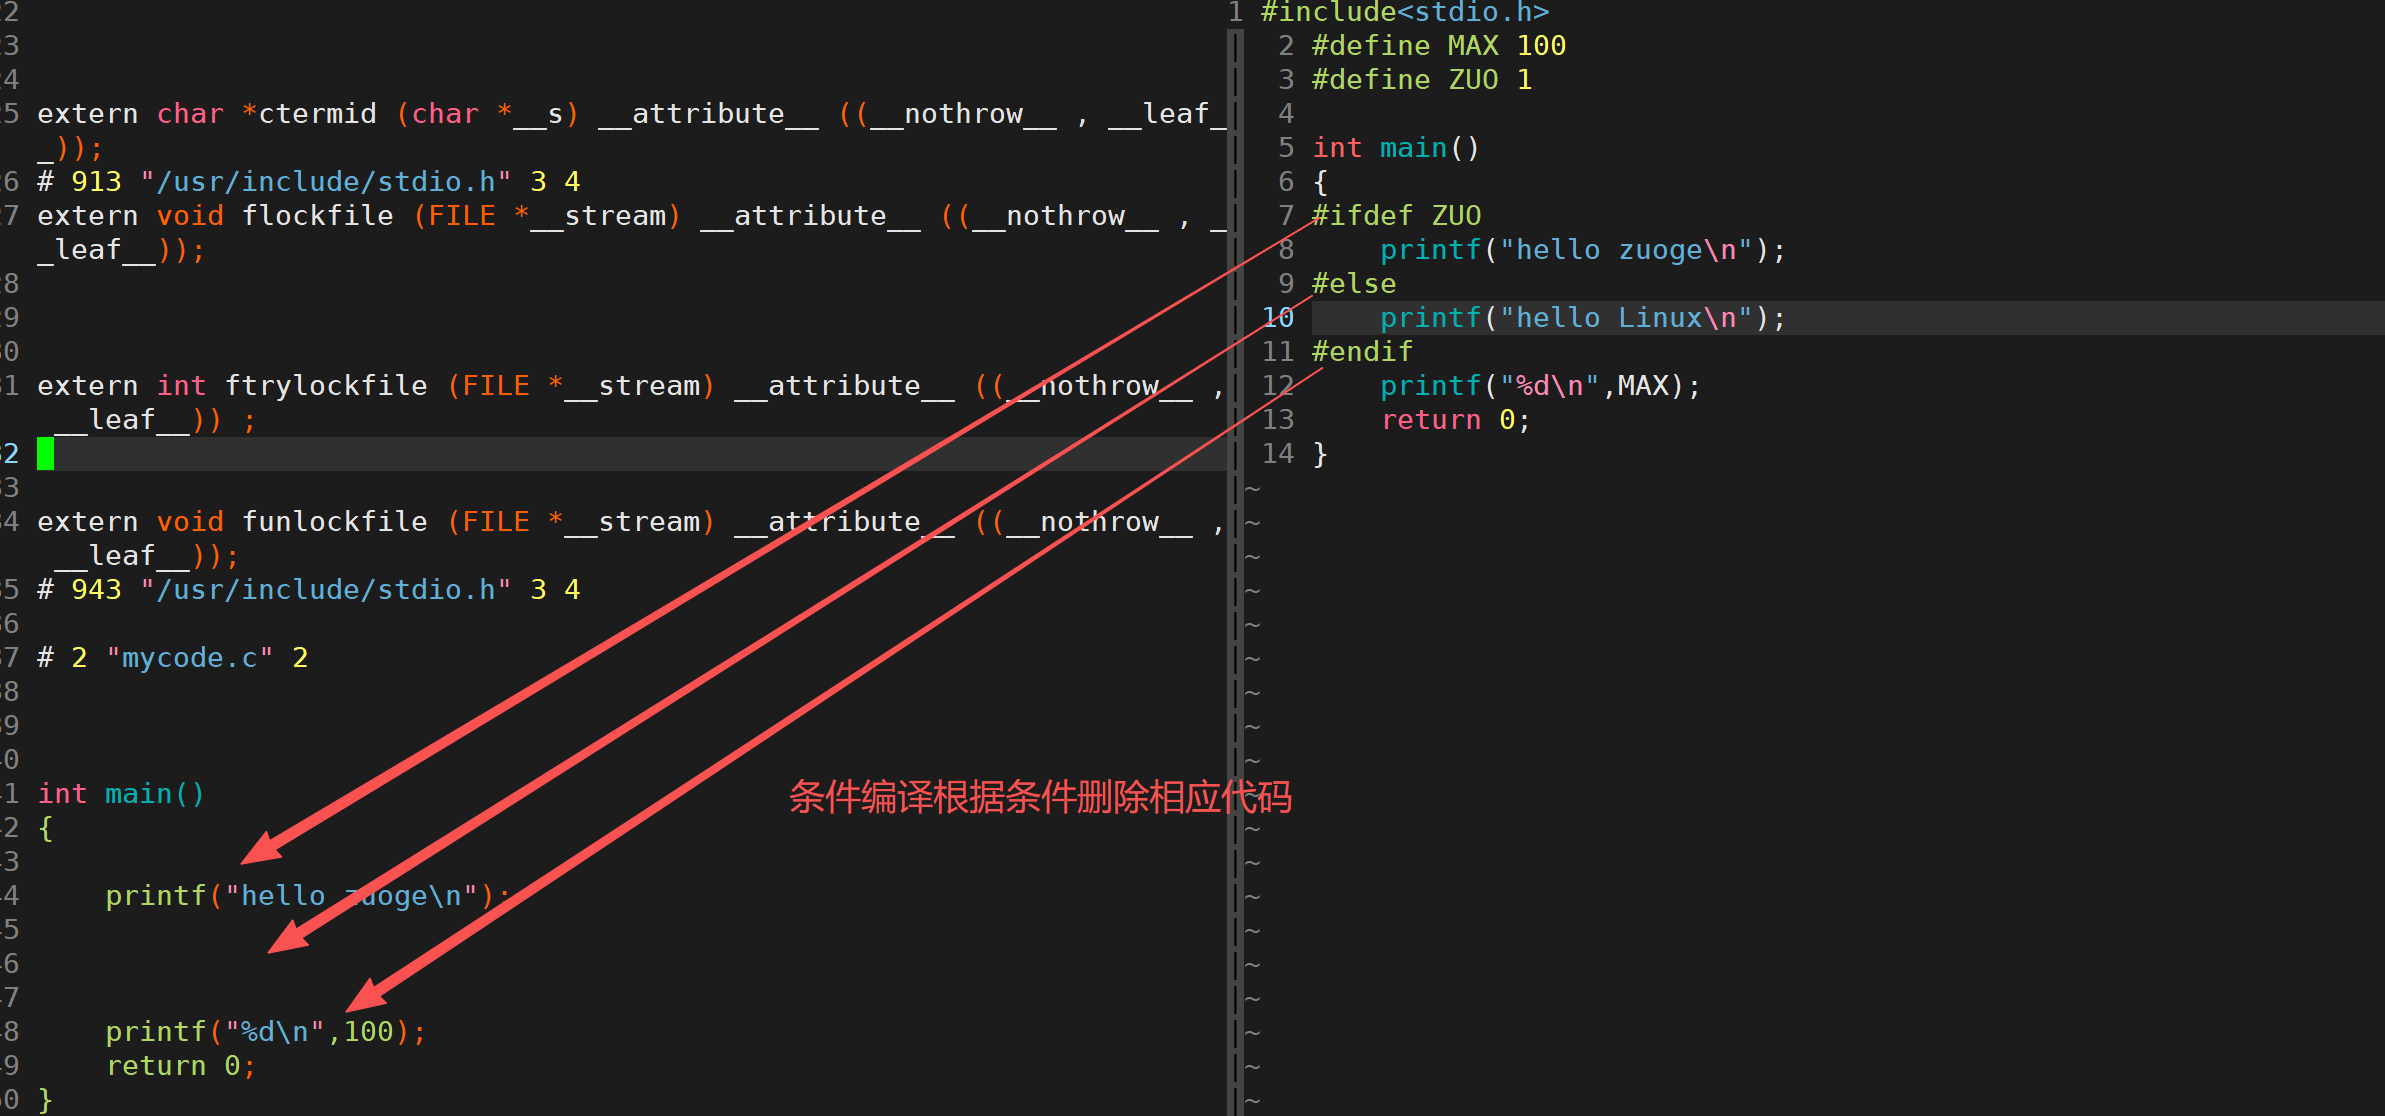
条件编译应用场景:
为什么要有条件编译呢?
我们都曾经使用过VS2019,拿VS2019来举例VS2019分为社区版和专业版,这两个版本的功能是有些差异的,难道说提供这些软件的公司需要维护两份代码吗?
当然不是,此时只需要使用条件编译出来功能略有差异的不同版本即可。
d.宏替换
编译(生成汇编)
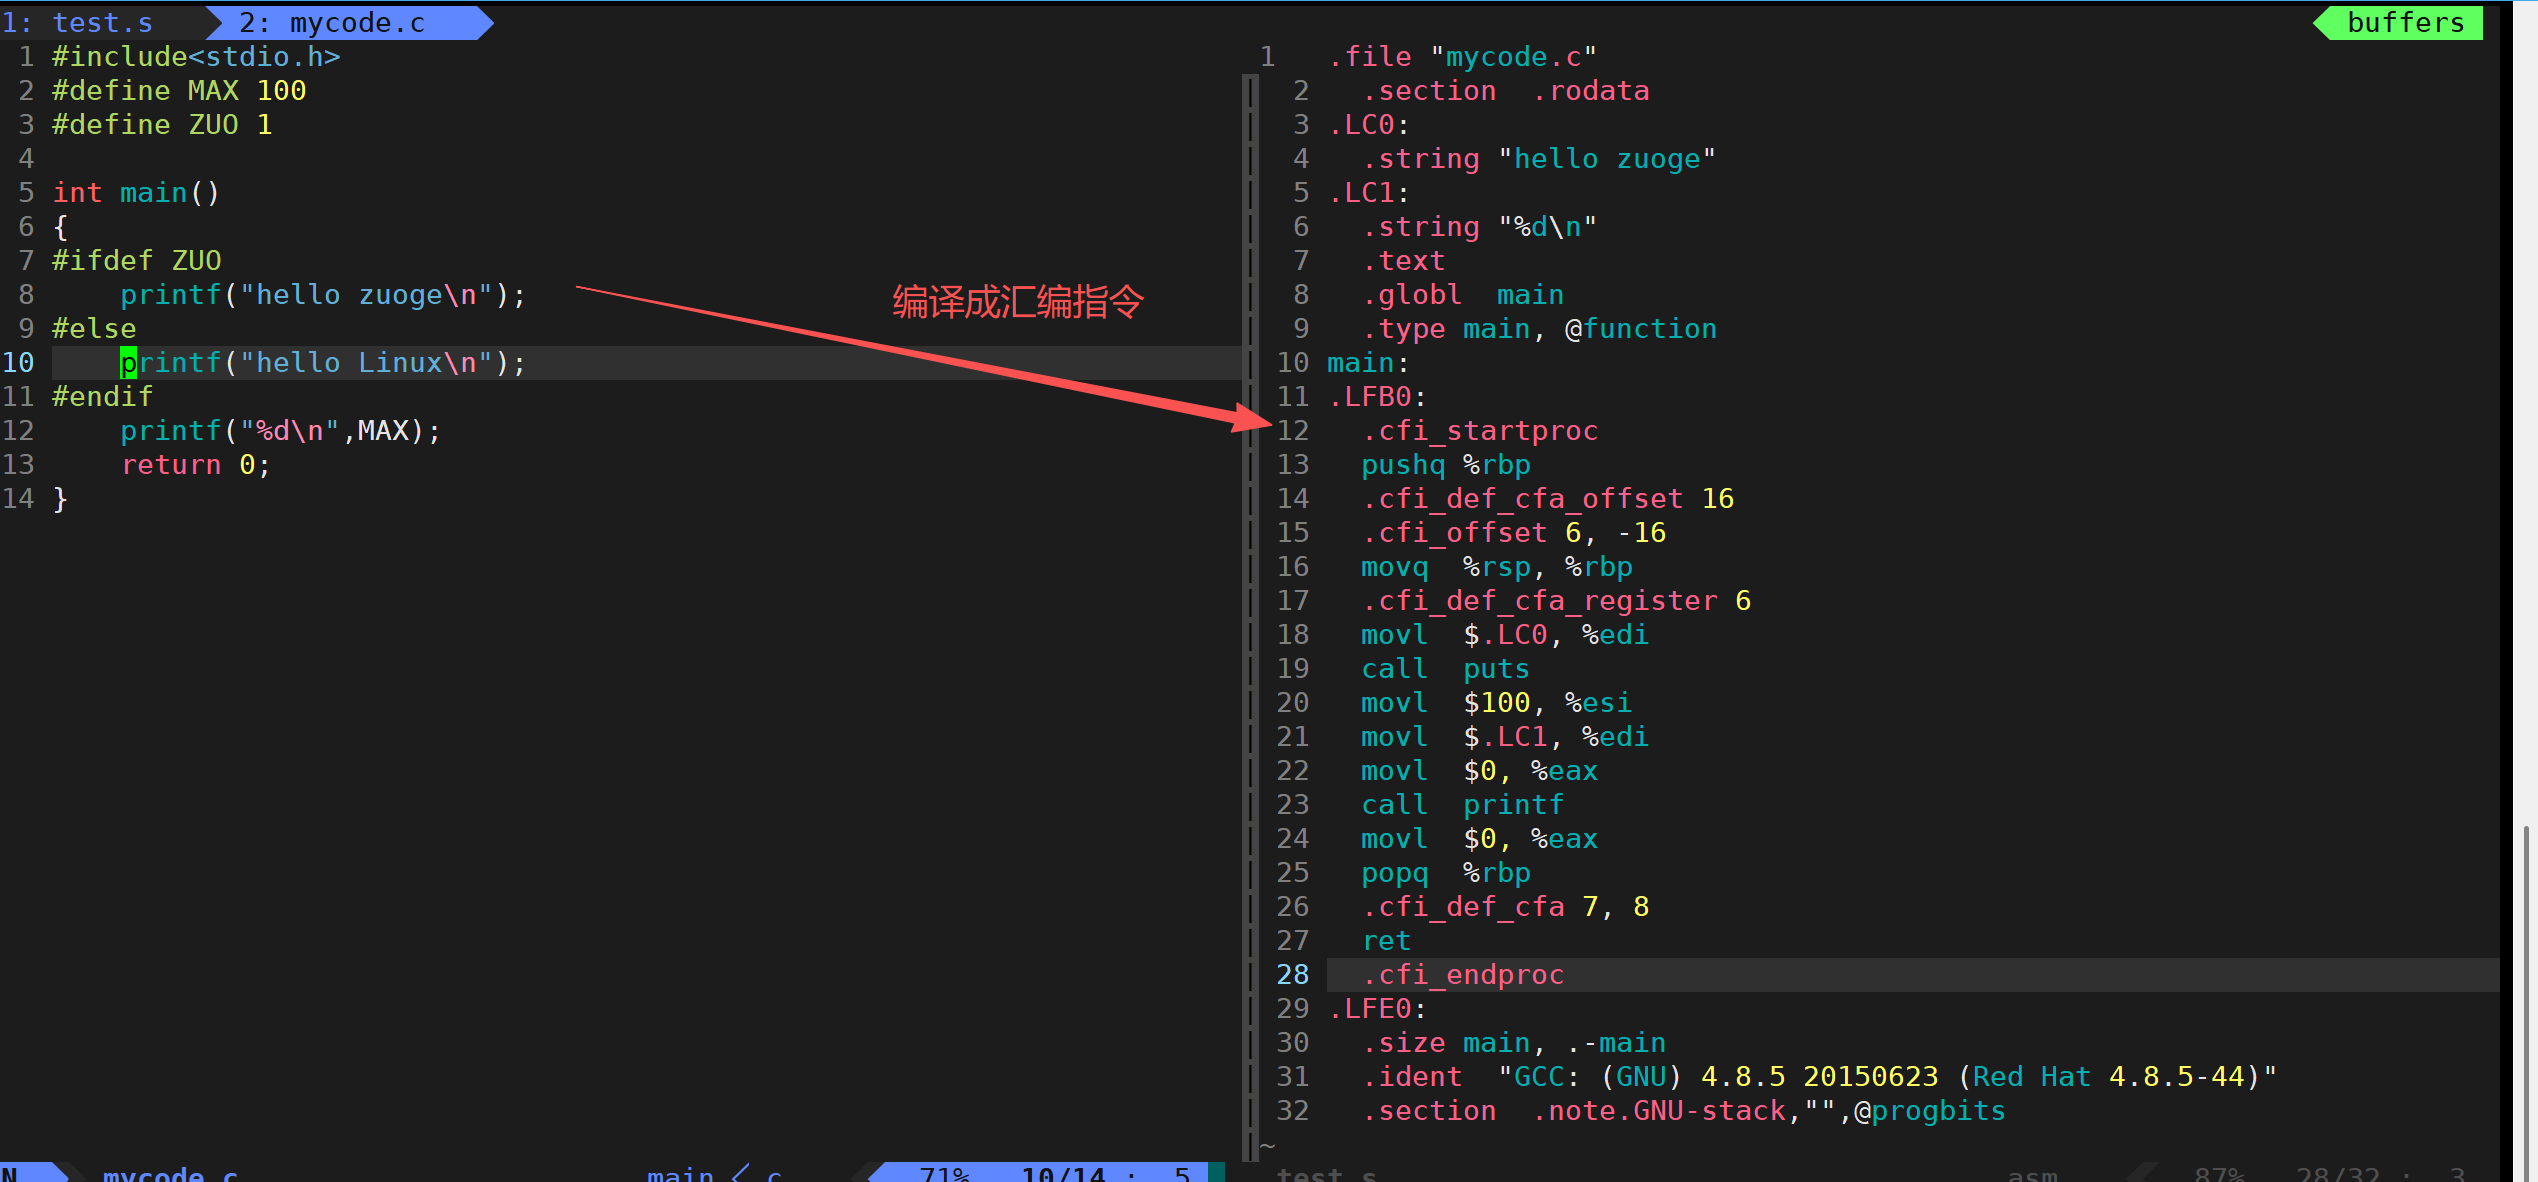
[zuoge@VM-24-14-centos ~]$ gcc -S mycode.i -o mycode.s
//告诉gcc,从现在开始进行程序的翻译,将编译工作做完就停下来
在这个阶段,gcc/g++首先检查代码的规范性、是否有语法错误等,以确定代码的实际要做的工作,在检查代码无误后,将代码翻译成汇编语言。
用户可以使用-S选项来进行查看,该选项只进行编译不进行汇编,生成汇编代码。
-o选项是指目标文件,"xxx.s"文件为已翻译过的原始程序。
汇编(生成机器可识别代码)
cpp
[zuoge@VM-24-14-centos ~]$ gcc -c mycode.s -o mycode.o
//告诉gcc,从现在开始进行程序的翻译,将编译工作做完就停下来
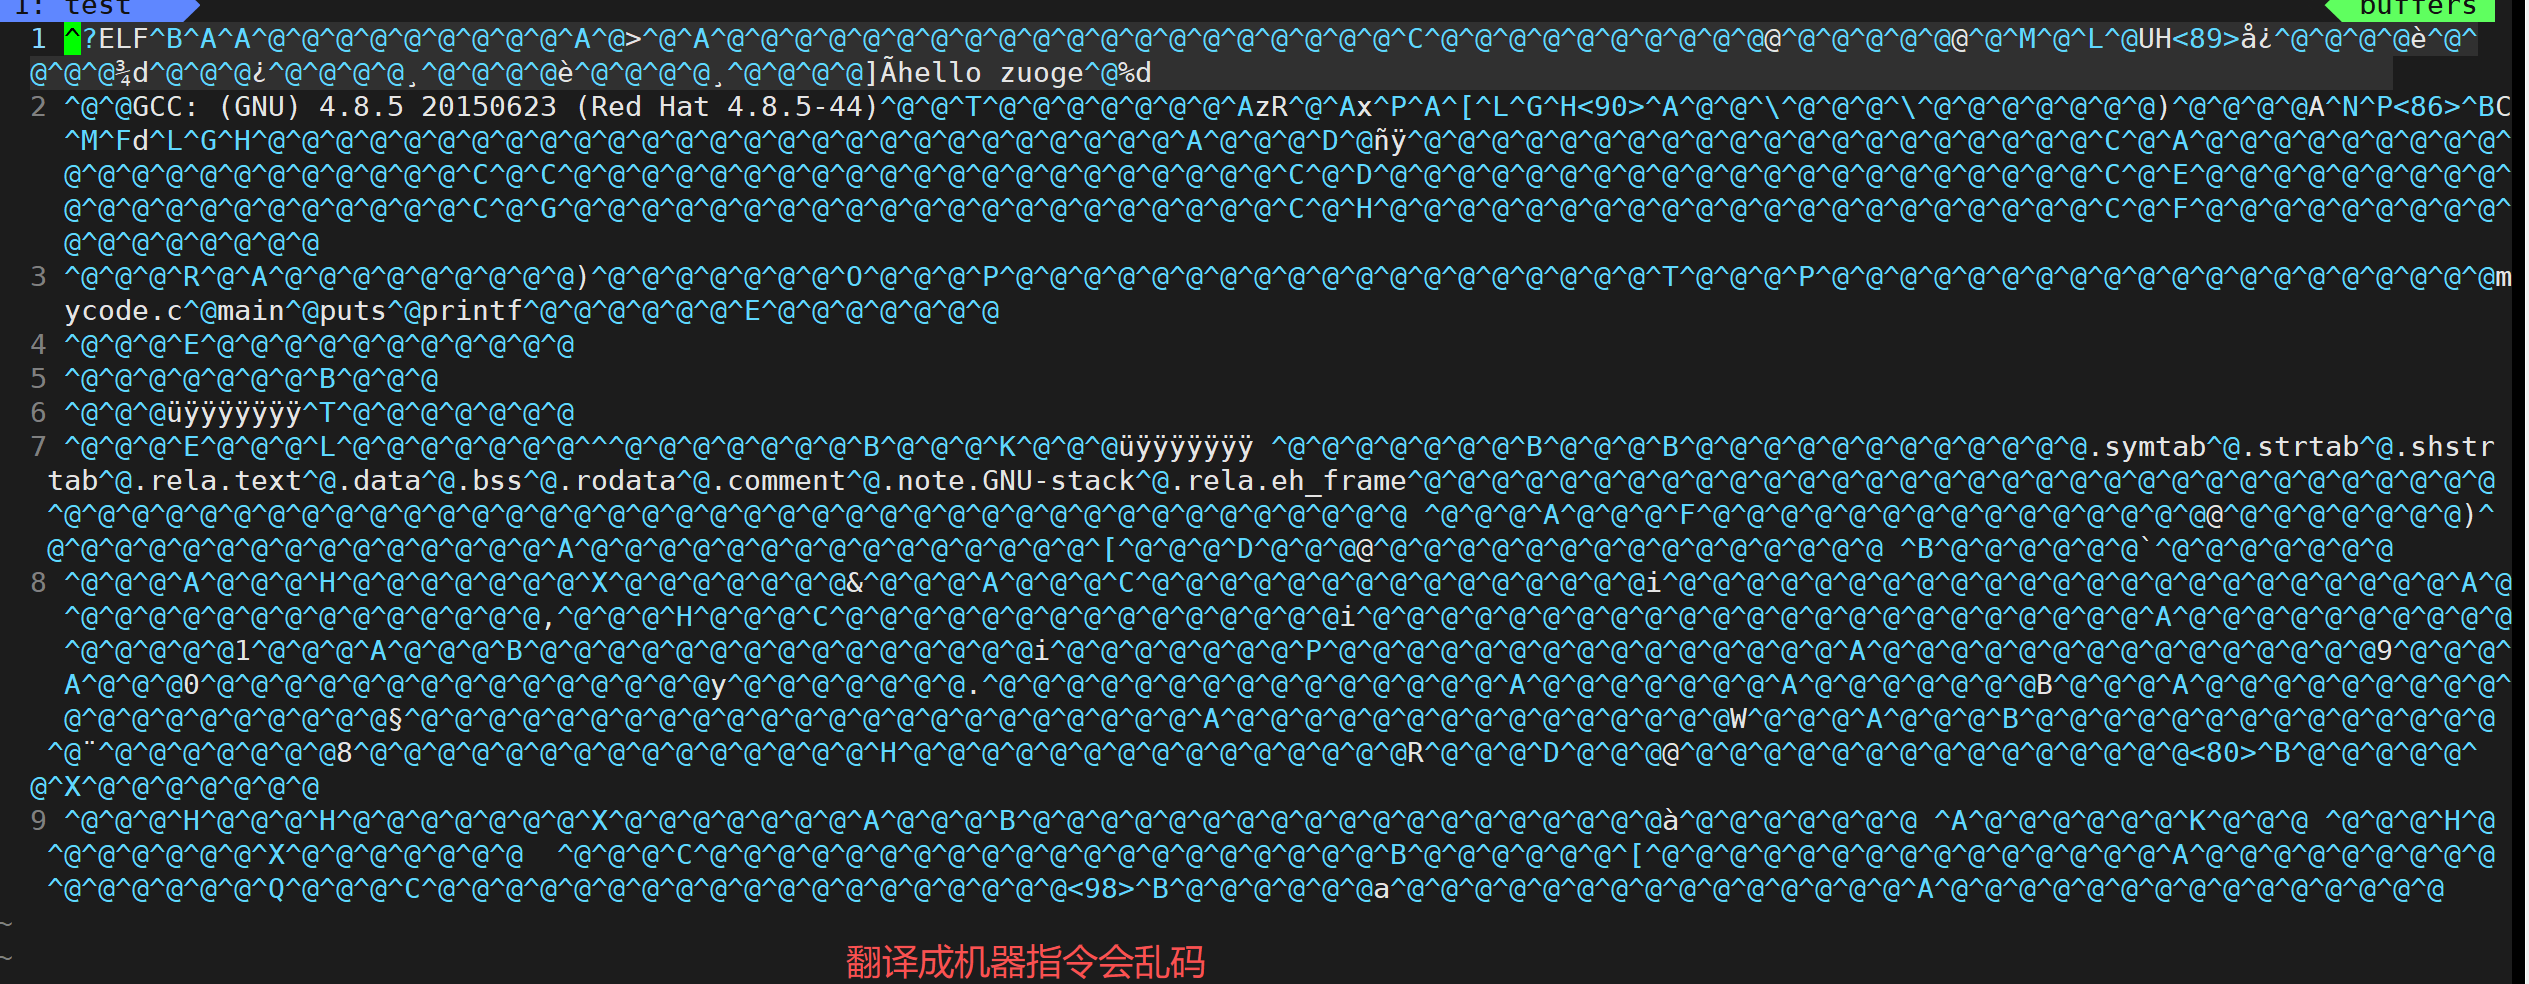
汇编阶段是把编译阶段生成的"xxx.s"文件转成目标文件。
使用-c选项就可以得到汇编代码转化成"xxx.o"的目标二进制文件。
链接(生成可执行文件或库文件)
cpp
[zuoge@VM-24-14-centos ~]$ gcc mycode.o -o mycode在完成上述步骤后,就进入了链接阶段。
链接的主要任务是将生成的各个"xxx.o"文件进行链接,生成可执行文件。
gcc/g++不带-E、-S、-c选项时,就默认生成预处理,编译,汇编,链接全过程后的文件。
若不用-o选项指定生成文件的文件名,则默认生成的可执行文件名为a.out。
注意:链接后生成的也是二进制文件。
记忆选项的方式:
看你键盘坐上的角的Esc只不过命令是ESc注意大小写。
静态库与动态库
1.情景引入
我们为什么能够在Windows或者Linux上进行C/C++或者其他形式的开发呢?
我们的系统中一定是提前安装上,C/C++相关的头文件和库文件。
C/C++的开发环境不仅仅是VS,gcc,g++,更重要的是,语言文件的头文件和库文件。
其实我们装vs2019、vs2022等,我们其实还在安装时,选择对应的开发包,同步下载c的头文件和库文件。
简而言之:编译型语言,安装开发包,必定下载对应的头文件+库文件
2.静态库与动态库的介绍
函数一般分为静态库和动态库两种:
静态库是指编译链接时,把库文件的代码全部加载到可执行文件当中,因此生成的文件较大,但是在运行时也就不需要库文件了,静态库一般以.a为后缀。
动态库与之相反,在编译链接时并没有把库文件的代码加载到可执行文件当中,而是在程序运行时由链接文件加载库,这样可以节省系统的开销,动态库一般以.so为后缀。
动态链接:
优点:省空间(磁盘空间,内存的空间),bin体积小,加载速度快。
缺点:依赖动态库,程序的可移植性较差。
静态链接:
优点:不依赖第三方库,程序的可移植性高。
确定:浪费空间。
gcc和g++默认生成的二进制程序是动态链接,我们可以使用file指令进行查看。

其次我们还可以使用ldd指令查看动态链接的可执行文件所依赖的库
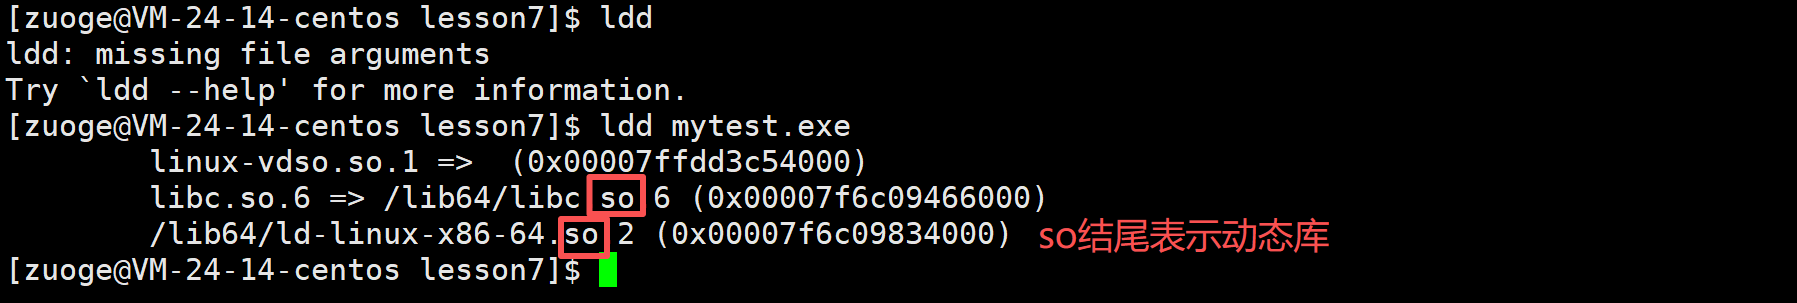
(图中/lib/libc.s0.6就是当前云服务器当中的C标准库)。
虽然gcc/g++默认采用的是动态链接,但是我们如果需要使用静态链接,但是-static选项即可。
此时生成的文件就是静态链接了

注意看此时两个文件的大小
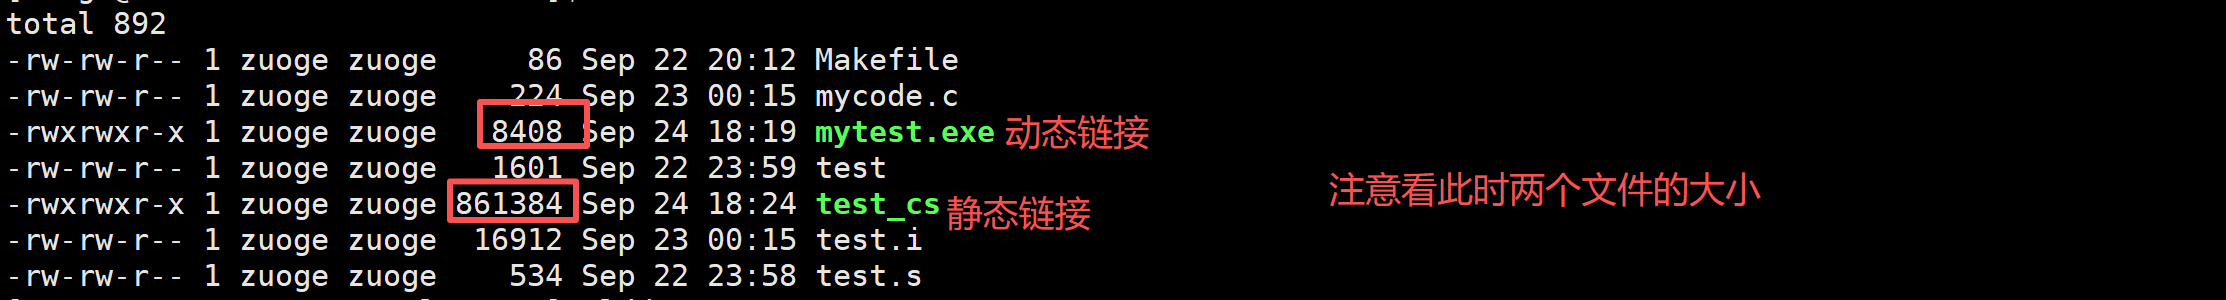
此处也证明了动态链接比较浪费空间。
扩展:可执行程序形成的时候,不是无序的二进制构成,有自己的格式----可执行程序有自己的二进制格式---ELF格式。
Linux项目自动化构建工具--make/Makefile
make/Makefile的重要性
1.会不会写Makefile,从侧面说明一个人是否具备完成大型工程的能力。
2.一个工程中的源文件不计数,按器其类型、功能模块分别放在若干目录中,makefile定义一系列的规则来指定,哪些文件需要先编译,哪些为文件需要后编译,哪些文件文件需要重新编译,甚至于进行更复杂的功能操作。
3.makefile带来的好处就是---"自动化编译",一旦写好,只需一个make命令,整个工程完全自动编译,极大提高了软件开发的效率。
4.make是一个命令工具,是一个解释makefile中指令的命令工具,一般来说,大多数的IDE都有这个命令,比如说:Delphi的make,Visual C++的make,Linux下GUN的make。makefile都成为了一种在工程方面的编译方法。
5.make是一条指令,makefile是一个文件,两个搭配使用,完成项目自动化构建。
依赖关系和依赖方法
在使用make/Makefile前我们首先应该理解各个文件之间的依赖关系以及依赖方法。
依赖关系:文件A的变更会影响到文件B,那么就称文件B依赖于文件A。
例如,test.o文件是由test.c文件通过预处理,编译以及汇编后生成的文件,所以test.c的改变会影响test.o,所以说test.o文件依赖于test.c文件。
依赖方法:如果说文件B依赖于文件A,那么通过文件A得到文件B的方法,就是文件B依赖于文件A的方法。
例如,test.o依赖于test.c,而test.c通过gcc -c test.c -o
test.o指令就可以得到test.o,那么test.o依赖于test.c的依赖方法就是gcc -c test.c -o。
多文件编译
当你有多个源文件时,应该如何编译呢?
我们可以通过上面学到的gcc/g++命令一步一步进行最后进行合并。
注意:多文件编译时,一般不使用源文件直接生成可执行程序,而是先用每个源文件生成各自的二进制文件,然后将二进制文件通过链接生成可执行程序。
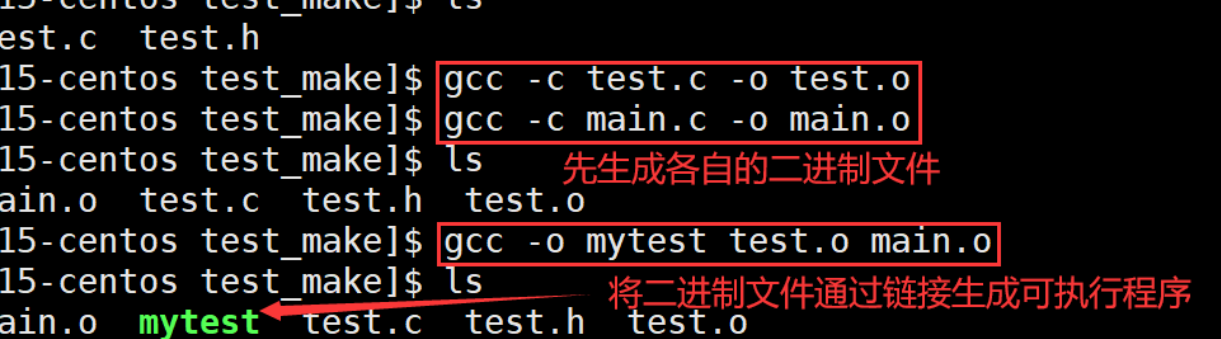
原因:
若是直接使用源文件生成可执行程序,那么其中一个源文件进行了修改,再生成可执行程序时就需要将所有的源文件进行重新编译链接。
而若是先用每个源文件各自生成的二进制文件,那么其中一个源文件进行了修改,就只需重新编译生成该源文件的二进制文件,然后再将这些二进制文件通过链接生成可执行程序即可。
注意:编译链接的时候不需要加上头文件,因为编译器通过源文件的内容可以知道所需的头文件名字,而通过头文件的方式("尖括号","双引号"),编译器就可以知道应该从何去找所需头文件。
但是随着源文件数量的怎加,我们每次重新生成可执行程序时,所需输入的gcc指令长度和数量也会随之增多。这是就学要make和makefile了,这将大大减少我们的工作量。
第一步创建Makefile文件

第二步编写Makefile文件
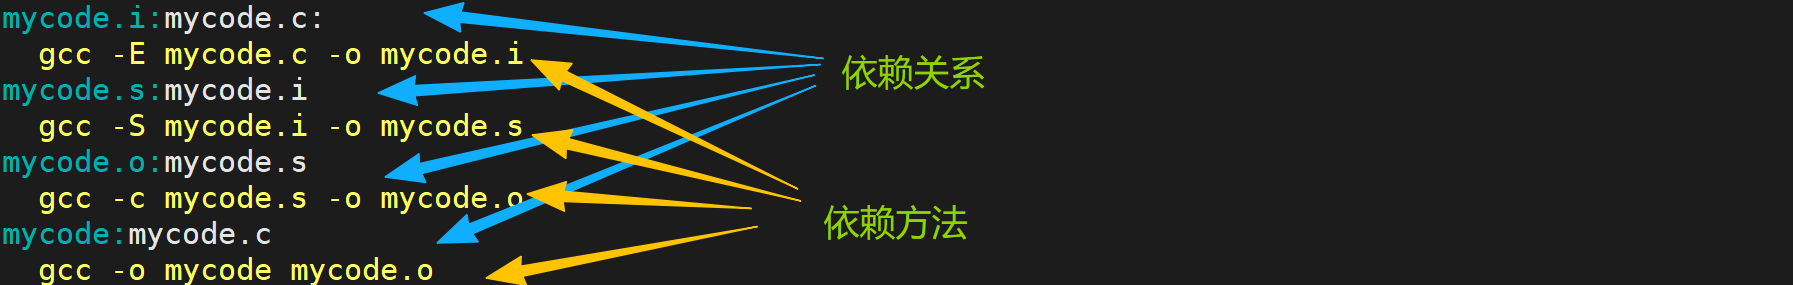
编写完后保存退出,然后执行make命令便可以生成可执行程序,以及该过程的中间产物。
Makefile文件的简写方式:
1.$@:表示依赖关系中的目标文件(冒号左侧)。
2.$^:表示依赖关系中的依赖文件列表(冒号右侧全部)。
3.$<:表示依赖关系中的第一个依赖文件(冒号右侧第一个)
说明: gcc/g++携带-c选项时,若不指定输出文件的文件名,则默认输出文件名为xxx.o,所以这里也可以不用指定输出文件名。
make原理
1.make会在当前目录下找名字为"Makefile"或"makefile"的文件。
2.如果找到,它会找文件当中的第一个目标文件,在上面的例子中,它会找到mytest这个文件,并把这个文件作为最终的目标文件。
3.如果mytest文件不存在,或是mytest所依赖的后面的test.o文件和main.o文件的文件修改时间比mytest文件新,那么它就会执行后面的依赖方法来生成mytest文件。
4.如果mytest所依赖的test.o文件不存在,那么make会在Makefile文件中寻找目标为test.o文件的依赖关系,如果找到则再根据其依赖方法生成test.o文件(类似于堆栈的过程)。
5.当然,你的test.c文件和main.c文件是存在的,于是make会生成test.o文件和main.o文件,然后再用test.o文件和main.o文件生成最终的mytest文件。
6.make会一层又一层地去找文件的依赖关系,直到最终编译出第一个目标文件。
7.在寻找的过程中,如果出现错误,例如最后被依赖的文件找不到,那么make就会直接退出,并报错。
项目清理
在我们每次重新生成可执行程序前,都应该将上一次生成可执行程序时生成的一系列文件进行清理,但是如果我们每次都手动执行一系列指令进行清理工作的话,未免有些麻烦,因为每次清理时执行的都是相同的清理指令,这时我们可以将项目清理的指令也加入到Makefile文件当中。
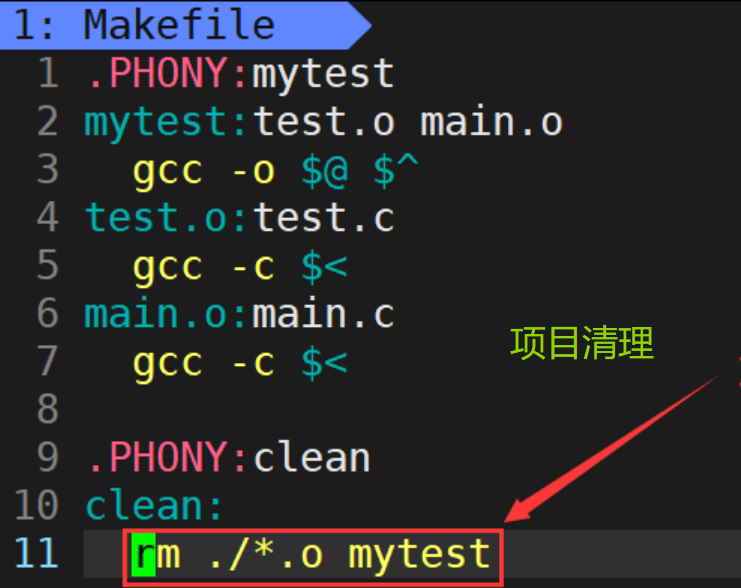
想clean这种,没有被第一个目标文件直接或间接关联,那么它后面所定义的命令将不会被自动执行,但我们可以显示要make执行。

注: 一般将这种clean的目标文件设置为伪目标,用.PHONY修饰,伪目标的特性是:总是被执行。
Linux第一个小程序 - 进度条
行缓冲区的概念
首先,我们来感受一下行缓冲区的存在,在Linux当中以下代码的运行结果是什么样的?
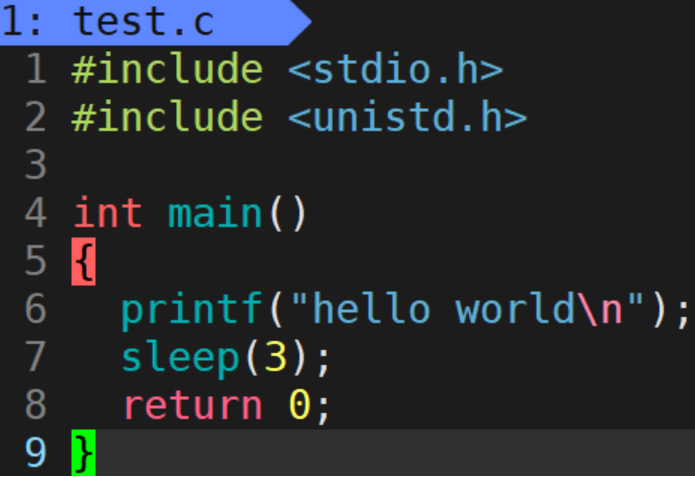
对于此代码,大家应该都没问题,当然是先输出字符串hello world然后休眠3秒之后结束运行。那么对于以下代码呢?
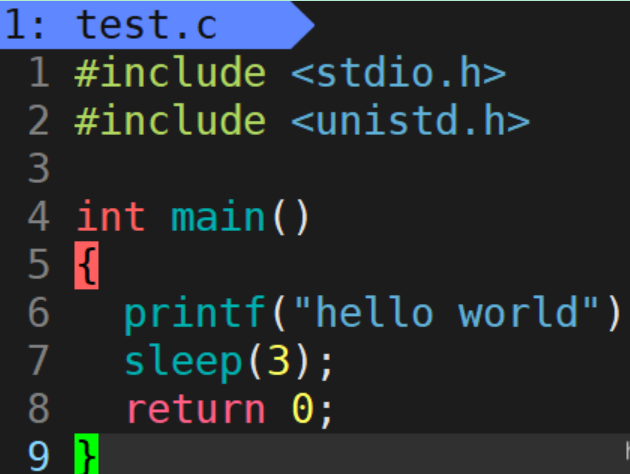
可以看到代码中仅仅删除了字符串后面的'\n',那么代码的运行结果还与之前相同吗?答案否定的,该代码的运行结果是:先休眠3秒,然后打印字符串hello world之后结束运行。该现象就证明了行缓冲区的存在。
显示器对应的是行刷新,即当缓冲区当中遇到'\n'或是缓冲区被写满才会被打印出来,而在第二份代码当中并没有'\n',所以字符串hello world先被写到缓冲区当中去了,然后休眠3秒后,直到程序运行结束时才将hello world打印到显示器当中。
\r和\n
\r: 回车,使光标回到本行行首。
\n: 换行,使光标下移一格。
而我们键盘上的Enter键实际上就等价于\n+\r
既然是\r是使光标回到本行行首,那么如果我们向显示器上写了一个数之后再让光标回到本行行首,然后再写一个数,不就相当于将前面一个数字覆盖了吗?
但这里有一个问题:不使用'\n'进行换行怎么将缓冲区当中数据打印出来?
这里我们可以使用fflush函数,该函数可以刷新缓冲区,即将缓冲区当中的数据刷新当显示器当中。
对此我们可以编写一个倒计时的程序。
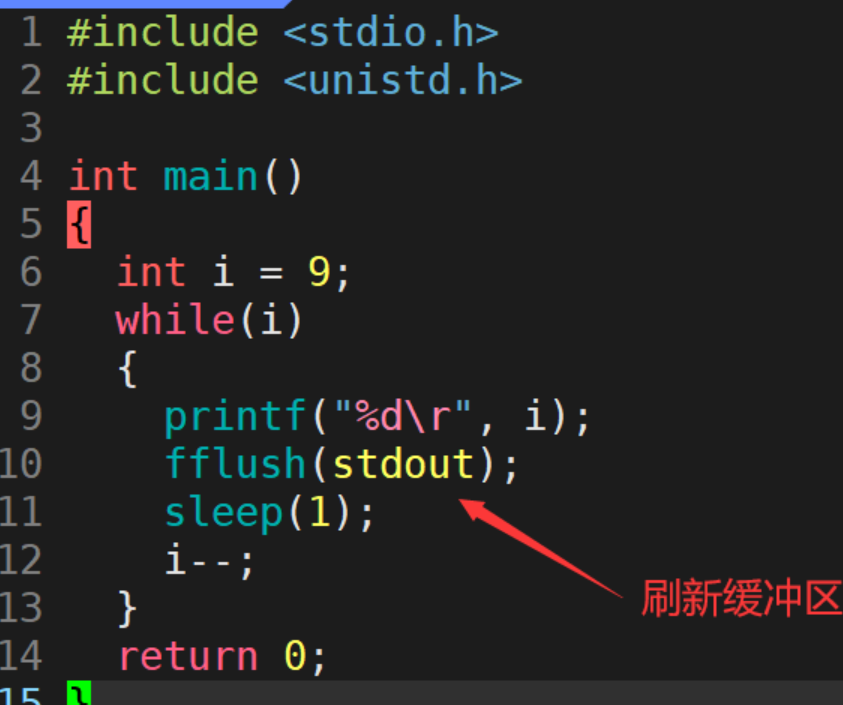
在输出下一个数之前都让光标先回到本行行首,就得到了倒计时的效果。
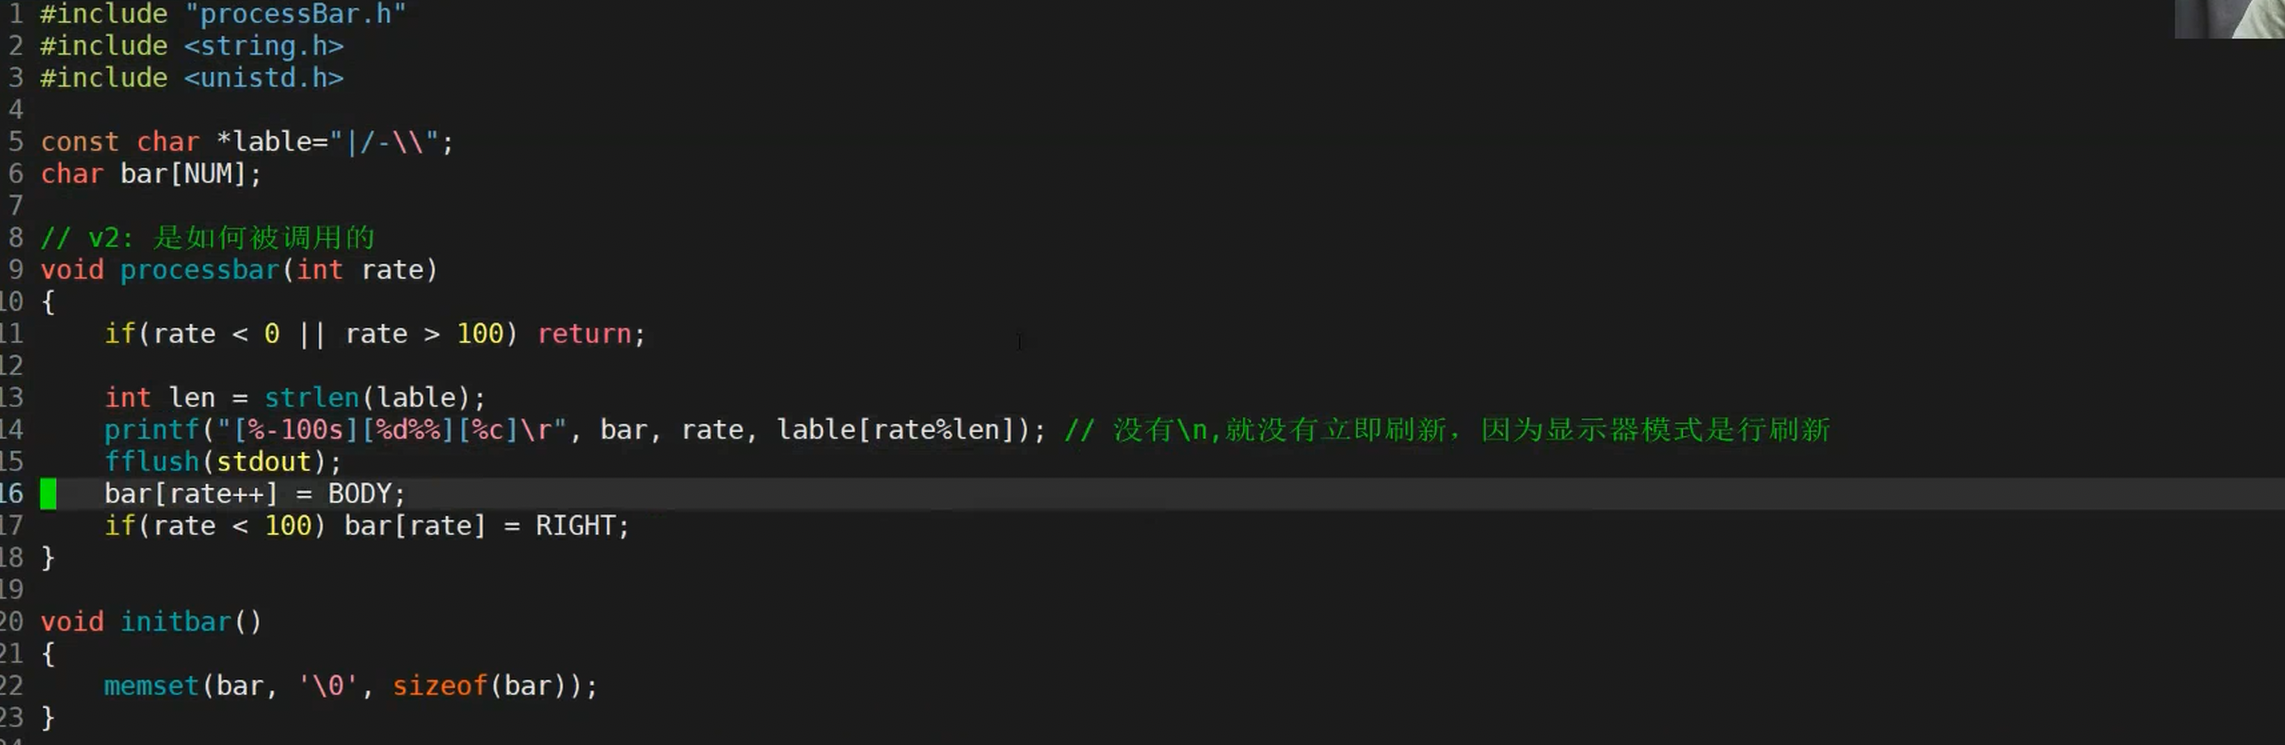
版本一:
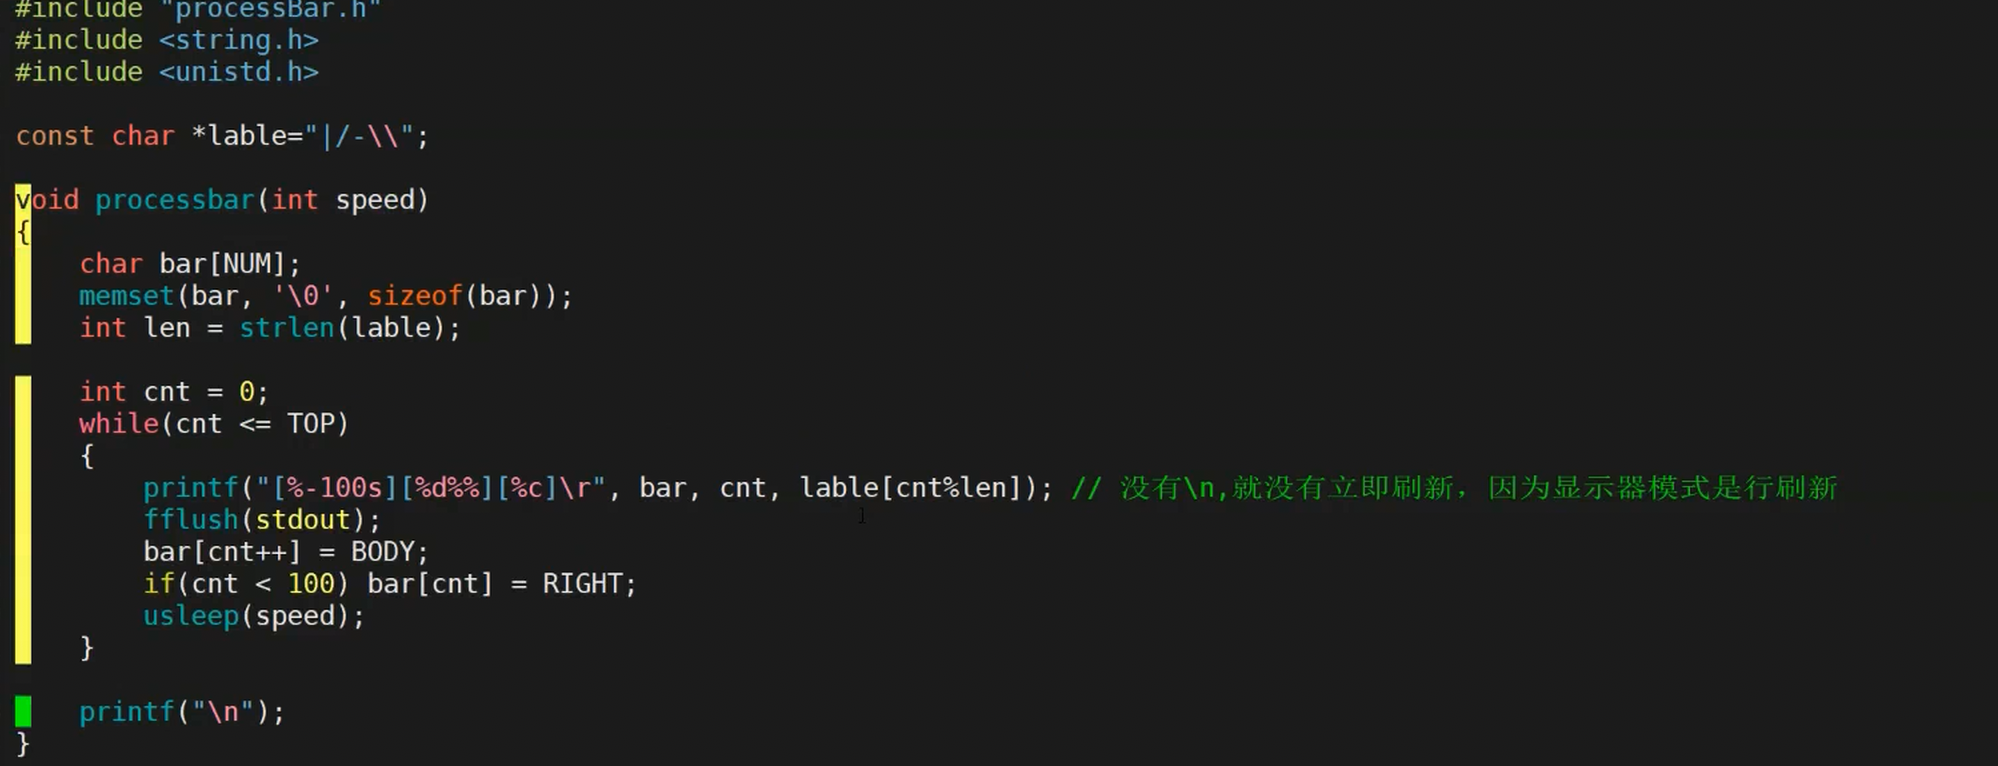
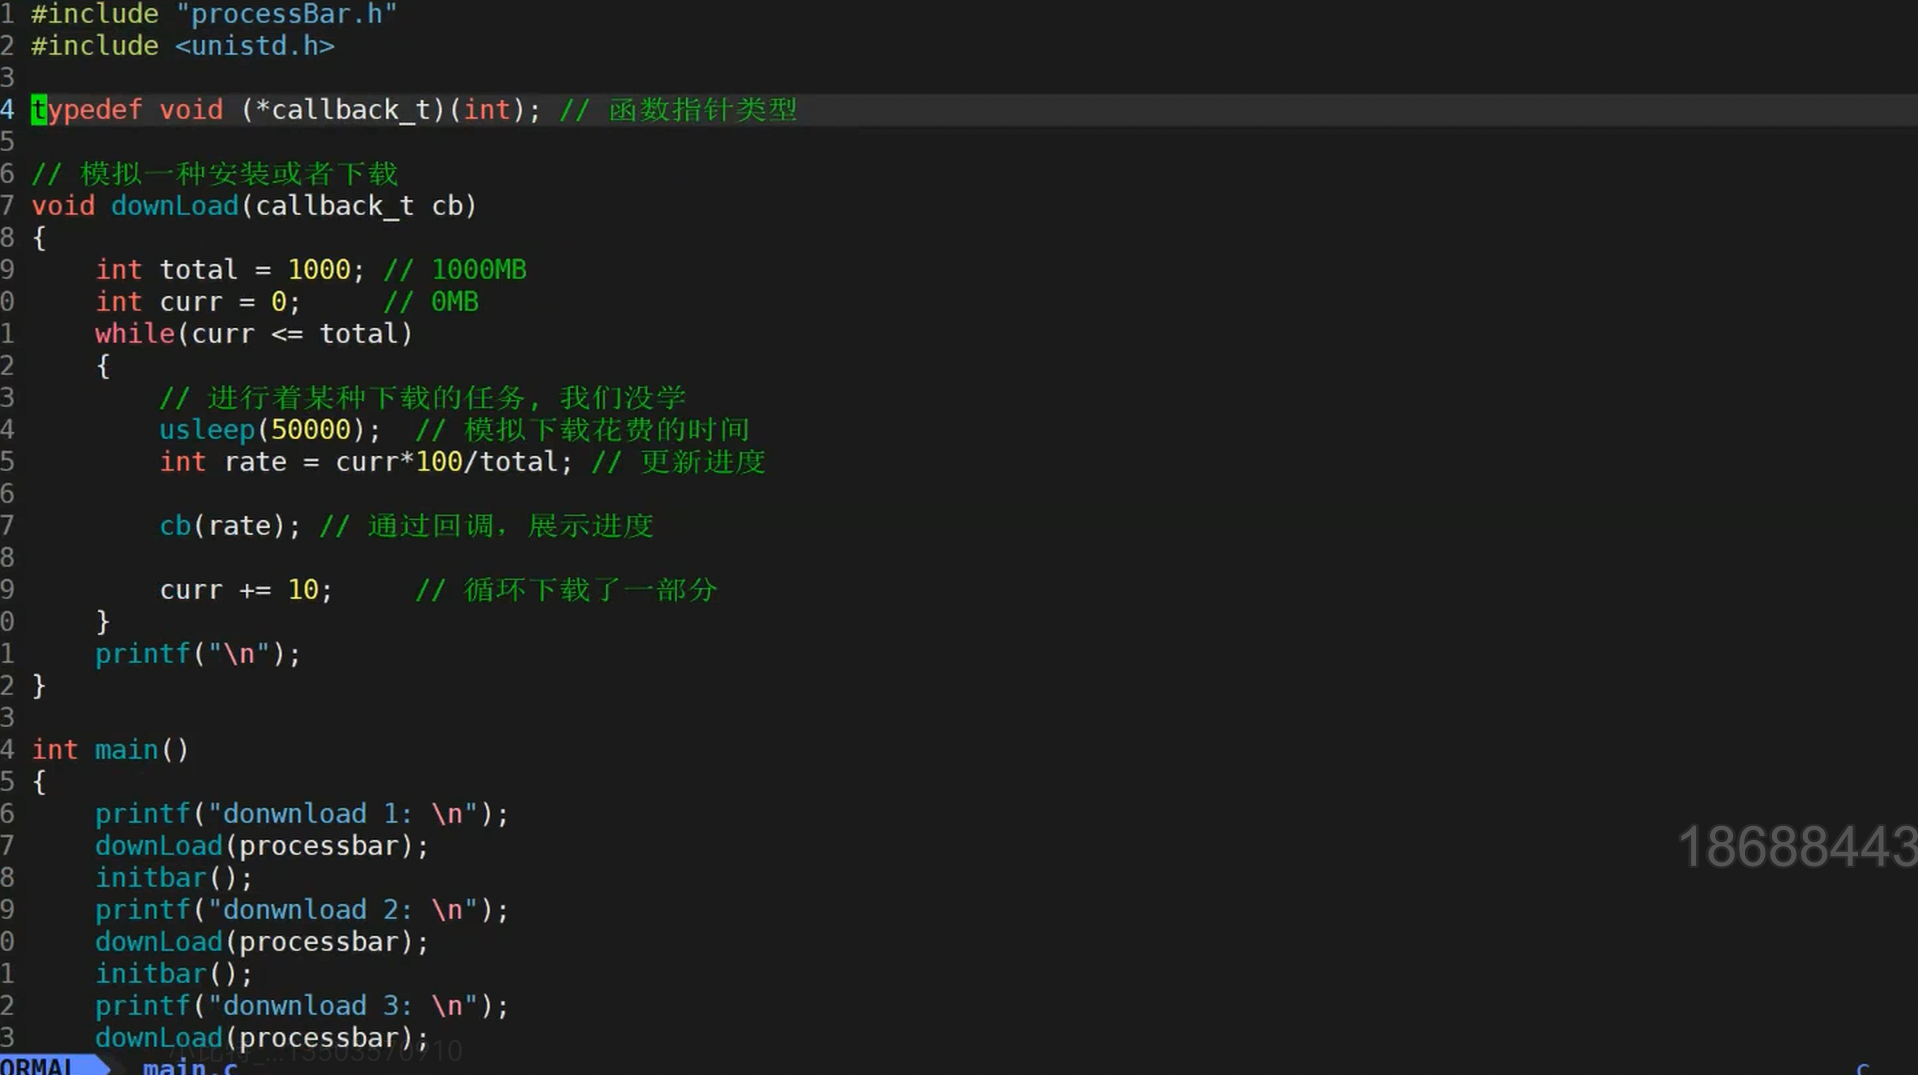
版本二:附带使用场景(我们下载一个东西时会显示下载百分比)
Linux调试器 - gdb
gdb使用须知
程序发布方式:
1、debug版本:程序本身会被加入更多的调试信息,以便于进行调试。
2、release版本:不会添加任何调试信息,是不可调试的。
在Linux当中gcc/g++默认生成的可执行程序是release版本的,是不可被调试的。如果想生成debug版本,就需要在使用gcc/g++生成可执行程序时加上-g选项。

对同一份源代码分别生成其release版本和debug版本的可执行程序,并通过ll指令可以看到,debug版本发布的可执行程序的大小比release版本发布的可执行程序的大小要大一点,其原因就是以debug版本发布的可执行程序当中包含了更多的调试信息。

gdb命令汇总
【进入gdb】
指令: gdb 文件名
【调试】
1)「run/r」:运行代码(启动调试)。
2)「next/n」:逐过程调试。
3)「step/s」:逐语句调试。
4)「until 行号」:跳转至指定行。
5)「finish」:执行完当前正在调用的函数后停下来(不能是主函数)。
6)「continue/c」:运行到下一个断点处。
7)「set var 变量=x」:修改变量的值为x。
【显示】
1)「list/l n」:显示从第n行开始的源代码,每次显示10行,若n未给出则默认从上次的位置往下显示.。
2)「list/l 函数名」:显示该函数的源代码。
3)「print/p 变量」:打印变量的值。
4)「print/p &变量」:打印变量的地址。
5)「print/p 表达式」:打印表达式的值,通过表达式可以修改变量的值。
6)「display 变量」:将变量加入常显示(每次停下来都显示它的值)。
7)「display &变量」:将变量的地址加入常显示。
8)「undisplay 编号」:取消指定编号变量的常显示。
9)「bt」:查看各级函数调用及参数。
10)「info/i locals」:查看当前栈帧当中局部变量的值。
【断点】
1)「break/b n」:在第n行设置断点。
2)「break/b 函数名」:在某函数体内第一行设置断点。
3)「info breakpoint/b」:查看已打断点信息。
4)「delete/d 编号」:删除指定编号的断点。
5)「disable 编号」:禁用指定编号的断点。
6)「enable 编号」:启用指定编号的断点。
【退出gdb】
1)「quit/q」:退出gdb。