RAG Day05 混合检索

上周学习了索引构建,本周开始学习检索相关。

索引是建立向量数据库时为这个信息提供一个标识,这种标识一般比较短,并且包含这块信息的主干内容,为将来快速检索打下了基础。

检索是希望更快的匹配问题语义和向量数据库的语义,那么语义如何与向量数据库对应也是快速检索的前提条件之一。

语义在向量化的过程中大致分为两类:稀疏向量和密集向量。

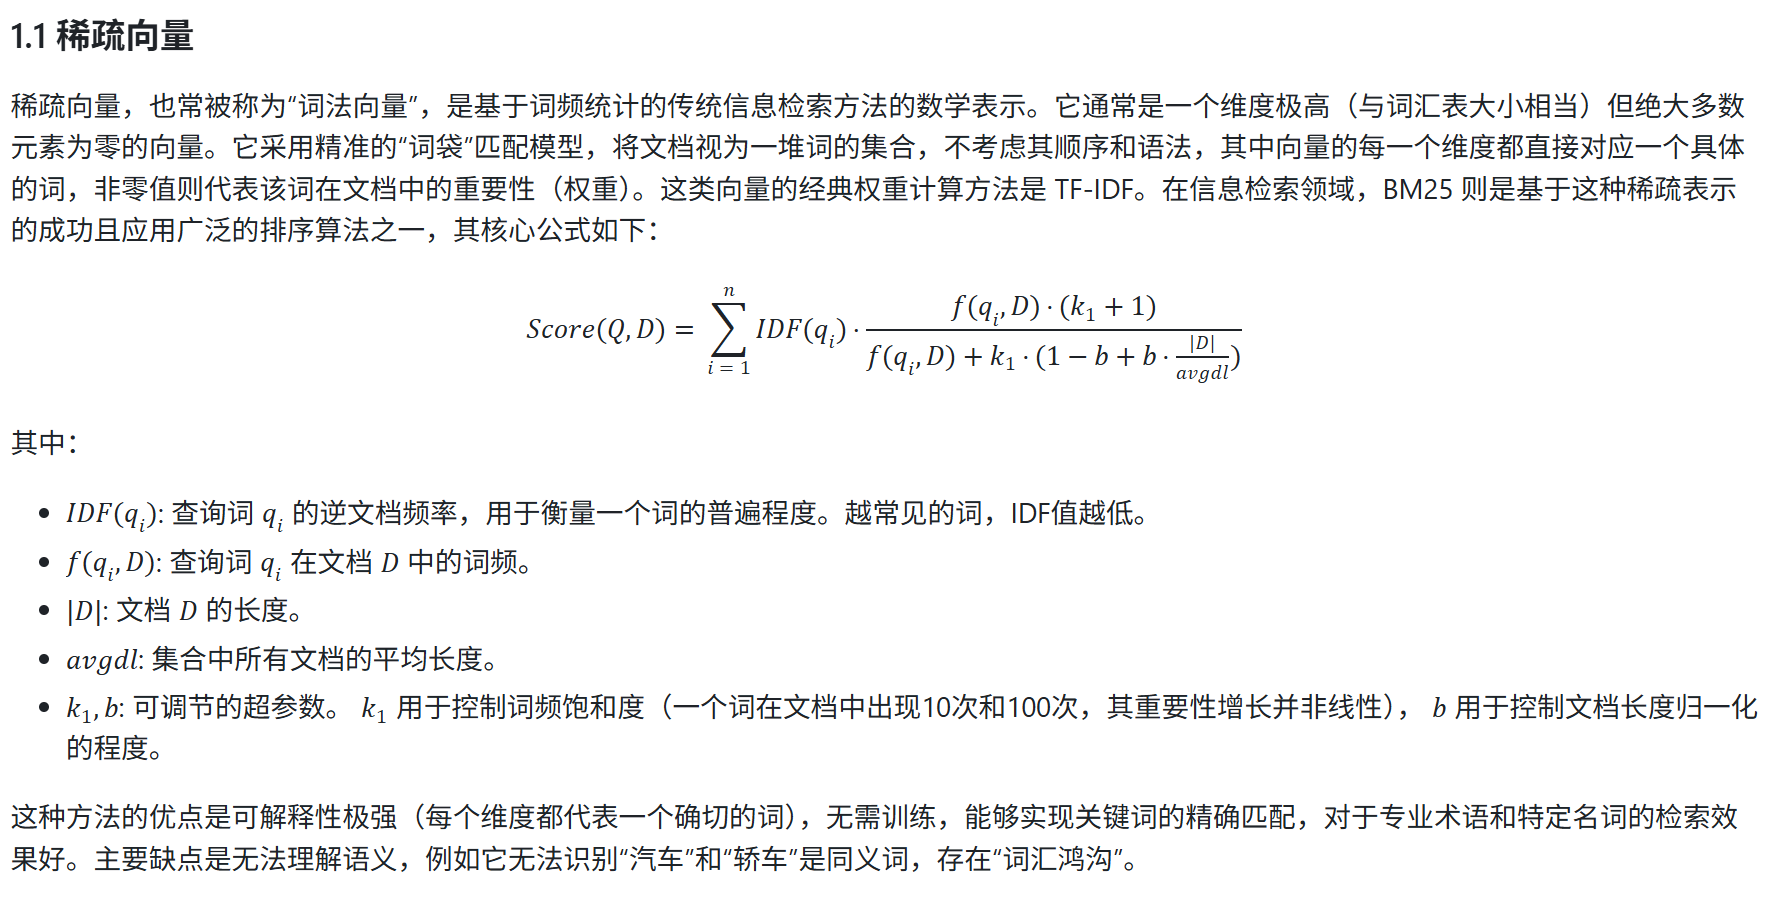
稀疏向量指的就是TF-IDF相关技术。他通过一个公式精确的将词频和词对应了起来,给更高的词频分配了更稀疏的向量编码,这个技术的好处是可以精确检索对应相关词条,整个过程具有强的可解释性和更高的效率,缺点是直接忽略未登录词。
密集向量在单词和向量映射之间采用了深度学习模型,从语义本位的角度出发理论上来说,相似语义的向量距离会更近,不相似语义的向量距离会更远。他的优点是通过深度学习的理论无限接近了语义这个理想点,缺点是可解释性差,并且需要大数据和算力。
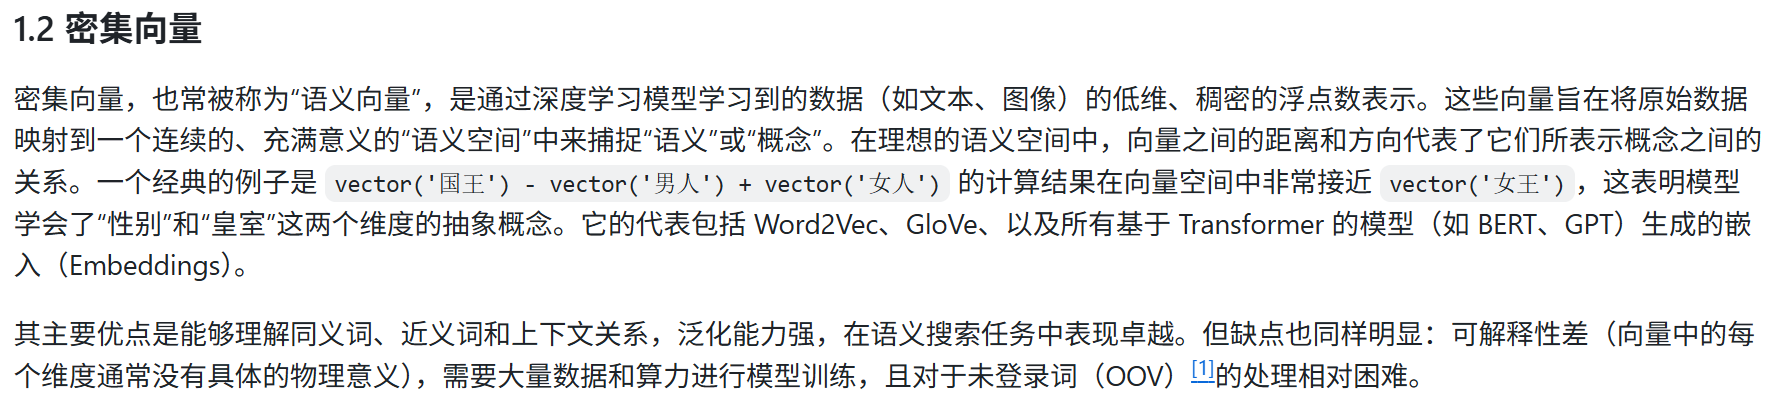
所谓混合检索就是稀疏检索和密集检索的加权。

利用二者的优势,更加理想化的接近了真实语义。

(代码设计了milvus,很难看懂,脑壳疼。)

学习内容来自Datawhale

还是很感谢开源精神,能写出这么一份高质量的教程也很不容易~

all-in-rag/docs/chapter4/11_hybrid_search.md at main · datawhalechina/all-in-rag · GitHub

相关推荐
wewowilling2 小时前
LangChain入门
python·ai·langchain·prompt
haluhalu.2 小时前
深入理解AIAgent(1.3)--- 设计模式
人工智能·python·设计模式·langchain
hackchen1 天前
LangChain 学习第 3 课 - 输出解析器(Output Parser)
数据库·学习·langchain
LMT流氓兔1 天前
第四单元——第17课:让回答边生成、边显示
服务器·数据库·人工智能·python·oracle·langchain
BD_Marathon1 天前
OpenAI库的基础使用
langchain
云和数据.ChenGuang1 天前
LangChain 实战指南:从入门到构建智能应用
开发语言·人工智能·python·langchain
ctlover2 天前
Langchain 消息与提示词模板
langchain
一千柯橘2 天前
通过 langchain 开发一个很 small 的 agent 来了解基本流程 - py 版本
langchain
YIAN2 天前
入门篇:LangGraph 入门实战:从零搭建最简单的 RAG 问答系统
javascript·langchain
YIAN2 天前
高级篇:进阶多跳 RAG:子问题拆解 + 循环检索 + 智能规划,搞定复杂链式问题
javascript·langchain