👋 哈喽,掘金的家人们(JYM)!
大家在玩 ChatGPT 或者各种国产大模型的时候,有没有遇到过这样一个场景:你问它一个非常具体或者只有你自己知道的事情(比如"我昨天中午吃了什么?"或者"公司内部的某种加密协议是什么?"),它不仅不承认自己不知道,反而自信满满、引经据典地给你编造了一个完全错误的答案?
这就是大模型圈子里著名的幻觉(Hallucination) 现象。
今天,我们就来聊聊怎么治好这个"病",并且通过实战代码,带大家从零实现一个RAG(检索增强生成) 应用。不管你是 AI 小白还是正在进阶的开发者,这篇文章绝对能让你对大模型应用开发有全新的认知!
🧐 第一部分:大模型为什么会"撒谎"?
1.1 知识的来源与局限
我们要知道,LLM(大语言模型)的知识来源于哪里?答案是训练数据集。 在训练阶段,工程师们喂给它海量的互联网文本,它学会了预测下一个字是什么。
但是,这里有两个致命的 BUG:
- 时效性滞后:模型训练完那一刻,它的知识就定格了。比如它可能不知道昨天发布的 iPhone 17 长什么样。
- 私有数据缺失:它绝对没有看过你们公司的内部文档,也没有读过你私人写的日记。
1.2 什么是"幻觉"?
当你问 LLM 一个它训练数据里没有 的问题时,基于生成式 AI(AIGC)的原理,它会试图根据概率去"猜"答案。 结果就是:它会认认真真地胡乱回答。这种现象,我们称之为"幻觉"。
💡 例子:你问它:"孙悟空的二姨夫的邻居的狗叫什么名字?" 它可能会回答:"根据《西游记》记载,那条狗叫旺财。" ------ 听起来好有道理,其实全是瞎编的!
🛠️ 第二部分:RAG ------ 给大模型搞个"外挂"
为了解决幻觉,RAG(Retrieval-Augmented Generation,检索增强生成) 横空出世。
2.1 RAG 的核心思想
如果说训练大模型是让它"背书",那么 RAG 就是允许它"开卷考试"。
当用户提问时,我们不直接扔给大模型,而是先做这几步:
- 检索(Retrieve):去我们准备好的"知识库"里,找到和问题相关的资料。
- 增强(Augment):把找到的资料和用户的问题打包在一起,组成一个新的 Prompt(提示词)。
- 生成(Generate):把这个"加了料"的 Prompt 喂给大模型,让它基于资料回答。
如果检索不到?那就老老实实说"不知道",总比瞎编强!
2.2 RAG 的四大护法
RAG 的关键流程:
- Retriever(检索器) :
- 这是 RAG 的眼睛。它负责在浩如烟海的数据中找到最相关的片段。
- 核心技术是 Embedding(向量化) 和 Cosine Similarity(余弦相似度计算)。
- Knowledge Base(知识库) :
- 这是 RAG 的大脑外存。
- 可以是专家知识、企业私有文档(PDF, TXT)、甚至是视频音频的转录。
- 关键点:大文件不能直接存,必须切片(Document Chunking),然后 Embedding 化。
- Augmented(增强) :
- 原始 Prompt + 检索出来的相关文档 = 增强后的 Prompt。
- Generation(生成) :
- LLM 拿到增强 Prompt,根据上下文完美解答。
🧠 第三部分:硬核知识 ------ 向量(Vector)与语义搜索
很多同学不理解,计算机怎么知道"苹果"和"水果"是相关的,而"苹果"和"石头"是不相关的?
传统的关键词匹配(比如 SQL 的 LIKE 或者正则)是做不到语义理解的。 比如查询"文中提到的水果",如果文章里写的是"香蕉、荔枝",关键词匹配就瞎了,因为它没看到"水果"这两个字。
3.1 向量:万物皆可数字化
在 AI 的世界里,我们用**向量(Vector)**来表达信息。简单说,就是一串数字数组,比如 [0.1, 0.2, 0.9, ...]。
让我们用一个生动的例子(来自我们的笔记)来讲透这个概念:
假设我们用两个维度来描述物体:
- 食用性(0=不能吃,1=很好吃)
- 硬度(0=液体,1=金刚石)
那么:
- 🍎 苹果 :好吃,中等硬度 ->
[0.9, 0.5] - 🍌 香蕉 :好吃,软 ->
[0.9, 0.1] - 🪨 石头 :不能吃,巨硬 ->
[0, 1.0]
3.2 相似度怎么算?
看上面的坐标:
- 苹果
[0.9, 0.5]和 香蕉[0.9, 0.1]在"食用性"这个维度上非常接近,它们的距离(或者说向量夹角)很小。 - 苹果 和 石头
[0, 1.0],一个在左上角,一个在右下角,离得十万八千里。
这就是语义搜索的原理:
- 把"每个维度"扩展到成百上千个(不仅仅是食用性和硬度,还有颜色、用途、情感等等)。
- 将文字转化为高维空间中的向量。
- 通过计算向量之间的距离(通常用 Cosine Similarity 余弦相似度),就能知道谁跟谁是"亲戚"。
💻 第四部分:实战!用 LangChain 实现 RAG
好了,理论讲完了,是时候上代码了!我们要使用 LangChain 这个强大的框架来实现一个最小闭环的 RAG 系统。
我们将解析,看看代码是怎么一步步跑起来的。
4.1 环境准备与引入模块
首先,我们需要引入 LangChain 的核心组件。
javascript
import {
    ChatOpenAI,        // 用于调用大模型进行对话
    OpenAIEmbeddings   // 重点!用于将文本转化为向量的模型
} from "@langchain/openai";

// 知识库中一段知识的抽象概念
import {
    Document
} from "@langchain/core/documents";

// 内存向量数据库
// 在这里我们将向量临时存储在内存中,生产环境通常用 Chroma, Pinecone 等
import {
    MemoryVectorStore
} from "@langchain/classic/vectorstores/memory";
🔍 深度解析:
OpenAIEmbeddings:这是 RAG 的基石。它不负责回答问题,只负责把字变成向量。没有它,计算机就看不懂语义。Document:在 LangChain 里,任何一段文本都要被封装成Document对象,它包含pageContent(正文)和metadata(元数据,比如来源、作者、页码)。
4.2 实例化模型
javascript
const model = new ChatOpenAI({
    modelName: process.env.MODEL_NAME, // 比如 gpt-3.5-turbo 或 gpt-4
    apiKey: process.env.OPENAI_API_KEY,
    configuration: {
        baseURL: process.env.OPENAI_BASE_URL // 如果用代理或中转,这里很重要
    },
    temperature: 0, // 设为 0,让模型尽可能严谨,不要发散
});

const embeddings = new OpenAIEmbeddings({
    apiKey: process.env.OPENAI_API_KEY,
    model:  process.env.EMBEDDING_MODEL_NAME, // 比如 text-embedding-3-small
    configuration: {
        baseURL: process.env.OPENAI_BASE_URL
    },
});
这里我们实例化了两个对象:
model:负责最后的说话(生成)。embeddings:负责中间的理解(向量化)。
4.3 准备数据:切片与 Document 抽象
这是 RAG 最关键的一步:数据准备。
❓ 为什么要把故事拆成一段段的? 想象一下,你要在《西游记》里找"孙悟空是从哪儿蹦出来的"。
- 如果不拆分:你需要把整本《西游记》几十万字都塞给 LLM,说"帮我找找"。这不仅浪费 Token(钱!),而且因为上下文太长,LLM 可能会"迷失",找不到重点。
- 如果拆分:我们把书拆成 1000 个小片段。通过检索,只找出包含"石头"、"出生"的那 2 个片段。把这 500 字给 LLM,它瞬间就能回答,既省钱又精准。
看看我们的代码是如何构建这个"切片"数据的:
javascript
const documents = [
    new Document({
        pageContent: `光光是一个活泼开朗的小男孩...他特别擅长踢足球...`,
        metadata: { chapter: 1, character: "光光", type: "角色介绍", mood: "活泼" },
    }),
    new Document({
        pageContent: `东东是光光最好的朋友...东东喜欢读书和画画...`,
        metadata: { chapter: 2, character: "东东", type: "角色介绍", mood: "温馨" },
    }),
    // ... 省略中间的剧情 ...
    new Document({
        pageContent: `比赛那天终于到了...东东传出了一个漂亮的球...`,
        metadata: { chapter: 5, character: "光光和东东", type: "高潮转折", mood: "激动" },
    }),
    // ...
];
这里我们手动模拟了切片过程。在实际开发中,我们会用 TextSplitter 自动把 PDF 或大文本切成这样的小块。
4.4 向量化存储(入库)
有了数据,现在要让它们"入脑"(存入向量数据库)。
javascript
// 内存数据库
const vectorStore = await MemoryVectorStore.fromDocuments(
    documents,
    embeddings
);
🔥 这一行代码背后发生了什么?
MemoryVectorStore遍历documents数组。- 调用
embeddings模型,把每一段pageContent变成诸如[-0.012, 0.823, ...]的向量。 - 把向量和原始文本的映射关系存在内存里。
4.5 检索(Retrieve):寻找真相
现在,我们有一个问题:"光光和东东各自擅长什么?" 我们来看看如何找到答案。
方法一:使用 Retriever 接口
这是 LangChain 封装好的高级接口,最常用。
javascript
const retriever = vectorStore.asRetriever({ k: 2 }); // k: 2 表示只找最相似的 2 条
// ...
const retrievedDocs = await retriever.invoke(question);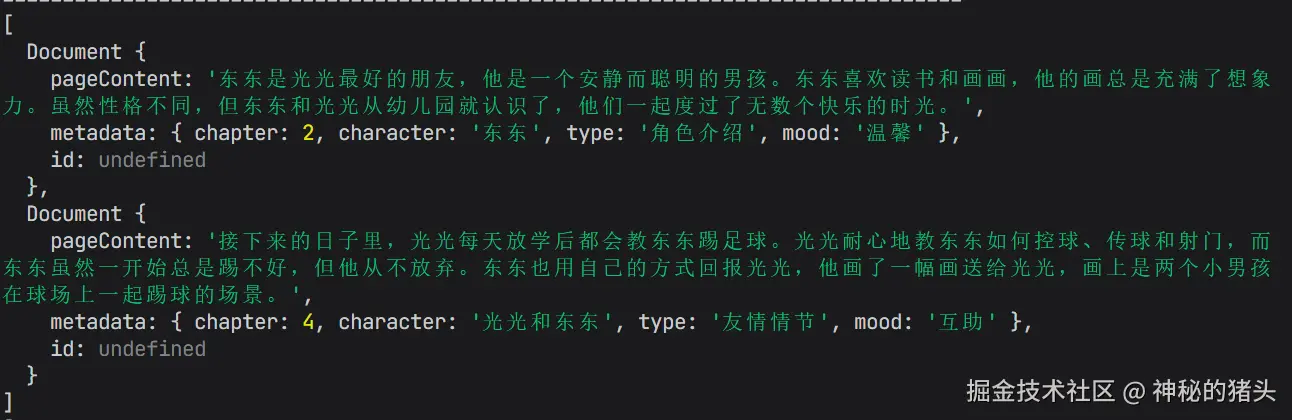
方法二:带分数的相似度搜索(硬核视角)
如果你想知道检索的质量如何,可以使用这个底层方法:
javascript
const scoreResults = await vectorStore.similaritySearchWithScore(question, 3);它会返回结果和相似度评分。我们可以打印出来看看:
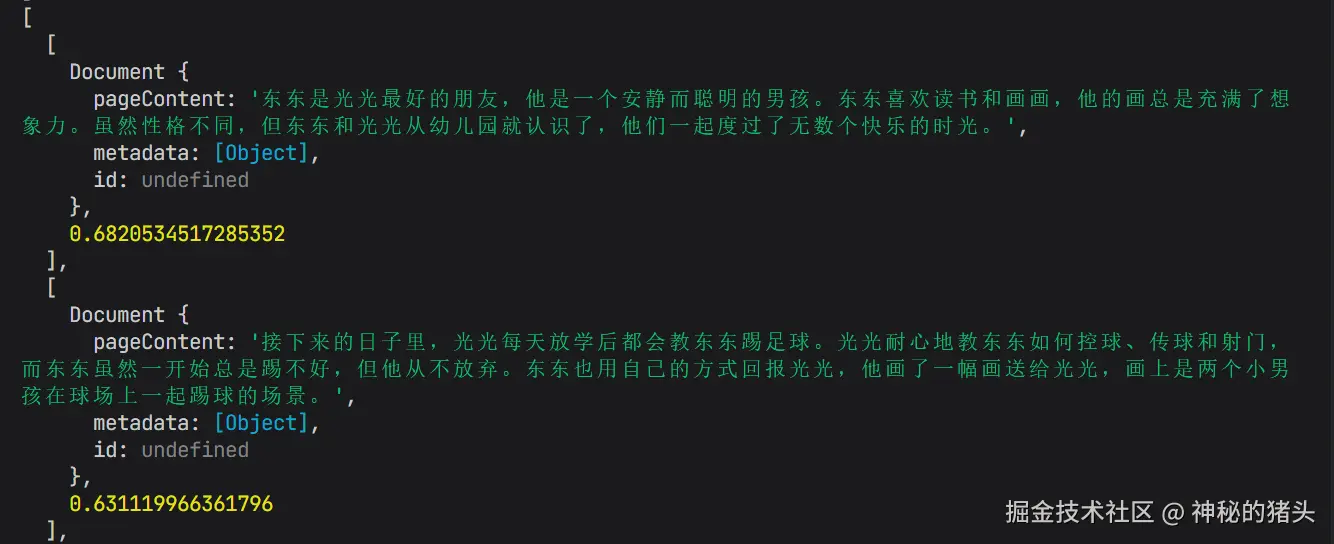
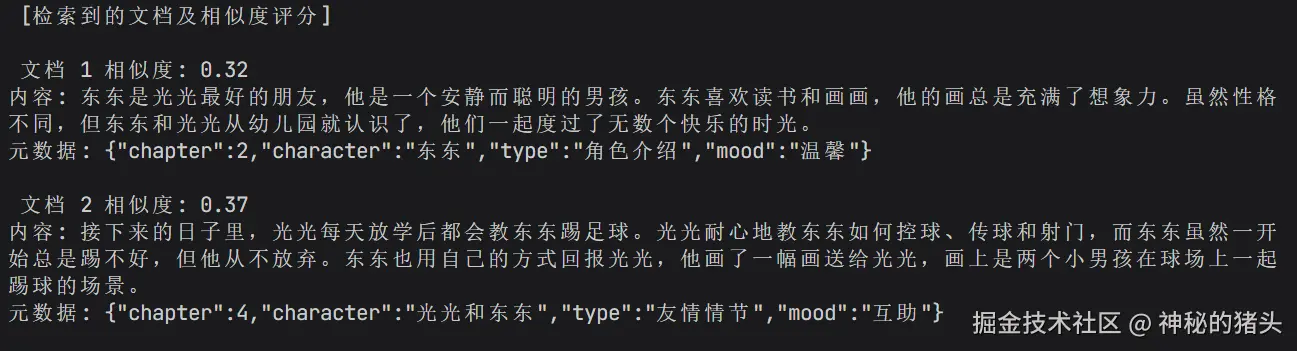
javascript
retrievedDocs.forEach((doc, i) => {
    console.log("\n [检索到的文档及相似度评分]");
    retrievedDocs.forEach((doc, i) => {
        const scoreResult = scoreResults.find(([scoredDoc]) => scoredDoc.pageContent === doc.pageContent);
        const score = scoreResult ? scoreResult[1] : null;
        const similarity = scoreResult ? (1 - score).toFixed(2) : "N/A";
        console.log(`\n 文档 ${i+1} 相似度: ${similarity}`);
        console.log(`内容: ${doc.pageContent}`);
        console.log(`元数据: ${JSON.stringify(doc.metadata)}`);
    });
    console.log(`\n 文档 ${i+1} 相似度: ${similarity}`);
    console.log(`内容: ${doc.pageContent}`);
    console.log(`元数据: ${JSON.stringify(doc.metadata)}`);
});当你运行这段代码,你会惊讶地发现,虽然问题里没有提"画画"或"足球",但向量数据库精准地把介绍"光光擅长足球"和"东东擅长画画"的那两段文档找出来了!这就是语义搜索的魅力。
4.6 增强(Augment):拼接上下文
找到相关片段后,我们需要把它们喂给大模型。
javascript
const context = retrievedDocs
    .map((doc,i) => `[片段${i+1}\n ${doc.pageContent}]`)
    .join("\n\n-----\n\n");
这一步就是把零散的 Document 对象变成了 LLM 能读懂的一长串字符串。
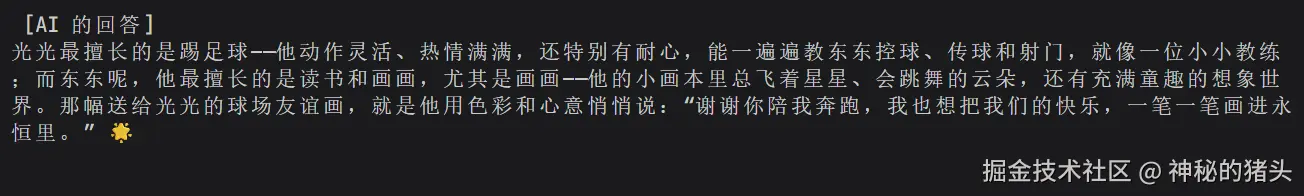
4.7 生成(Generate):见证奇迹
最后,构建 Prompt 并调用大模型。
javascript
const prompt = `
你是一个讲友情故事的老师。
基于以下故事片段回答问题,用温暖生动的语言。
如果故事中没有提及,就说"这个故事里没有提到这个细节"

故事片段:
${context}  <-- 这里就是我们检索出来的"外挂"知识

问题:
${question}

老师的回答:
`;

console.log("\n [AI 的回答]");
const response = await model.invoke(prompt);
console.log(response.content);通过这种方式,大模型不再是根据它的"潜意识"在瞎编 ,而是基于我们提供的 context 进行阅读理解。准确率直接 100%!
🎯 总结
看到这里,你已经完成了一次完整的 RAG 流程开发!🎉
让我们回顾一下今天的知识点:
- 痛点:LLM 有幻觉,且缺乏私有数据。
- 解法:RAG(检索增强生成)。
- 核心技术:向量(Embedding)和 相似度计算(Cosine Similarity)。
- LangChain 实战 :
Document封装知识。OpenAIEmbeddings向量化。VectorStore存储。Retriever检索。LLM生成。
LangChain 真的非常强大,它帮我们把这些复杂的数学计算和流程封装成了几行简单的代码。
✍️ 课后作业 : 试着修改 documents 里的内容,或者把问题改成一个故事里完全没提到的事(比如"光光喜欢吃什么?"),看看加上了"如果没提及就说不知道"的 Prompt 后,AI 会怎么回答?
希望这篇文章能帮你打开 RAG 的大门!如果觉得有用,记得点赞、收藏、关注哦!我们下期再见!👋