熵 (Entropy)
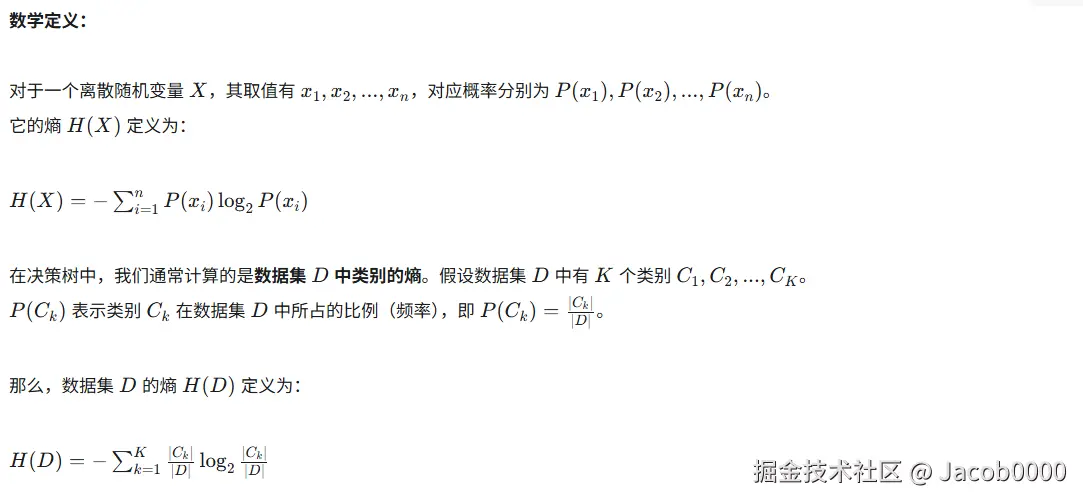
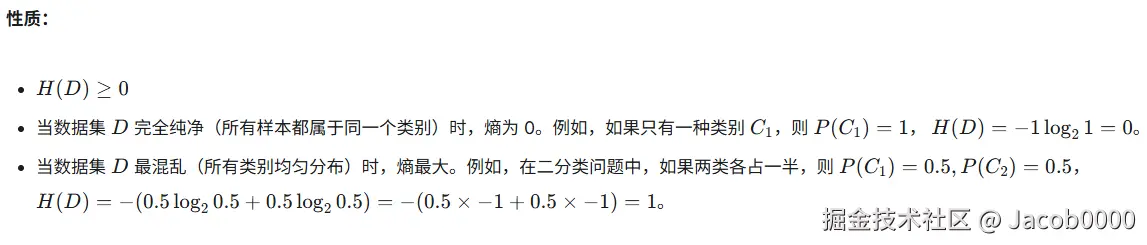
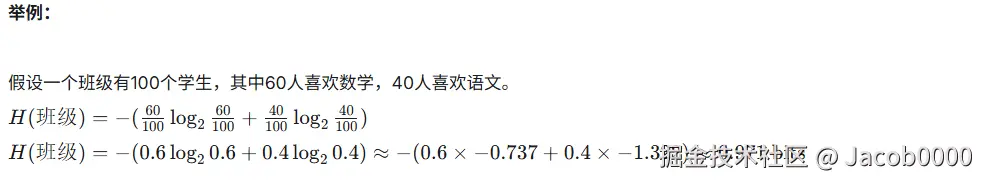
核心思想: 熵是信息论中用于衡量一个随机变量的**不确定性(uncertainty)或纯度(purity)**的指标。一个数据集的熵越高,表示其内部的混乱程度或不确定性越大;熵越低,表示其内部越有序,纯度越高。
熵 衡量一个数据集 的纯度
直观理解:
- 高熵(混乱) :如果你在一个袋子里,红球、绿球、蓝球各占三分之一,那么你随便摸出一个球,很难确定它是什么颜色,这个袋子的"不确定性"就很高,熵值就大。
- 低熵(纯净) :如果袋子里99%都是红球,只有少量绿球,你随便摸出一个球,基本可以确定是红球,这个袋子的"不确定性"就低,熵值就小。
- 零熵(完全纯净) :如果袋子里全是红球,你摸出的必然是红球,没有任何不确定性,熵值就是0。
IG (Information Gain)
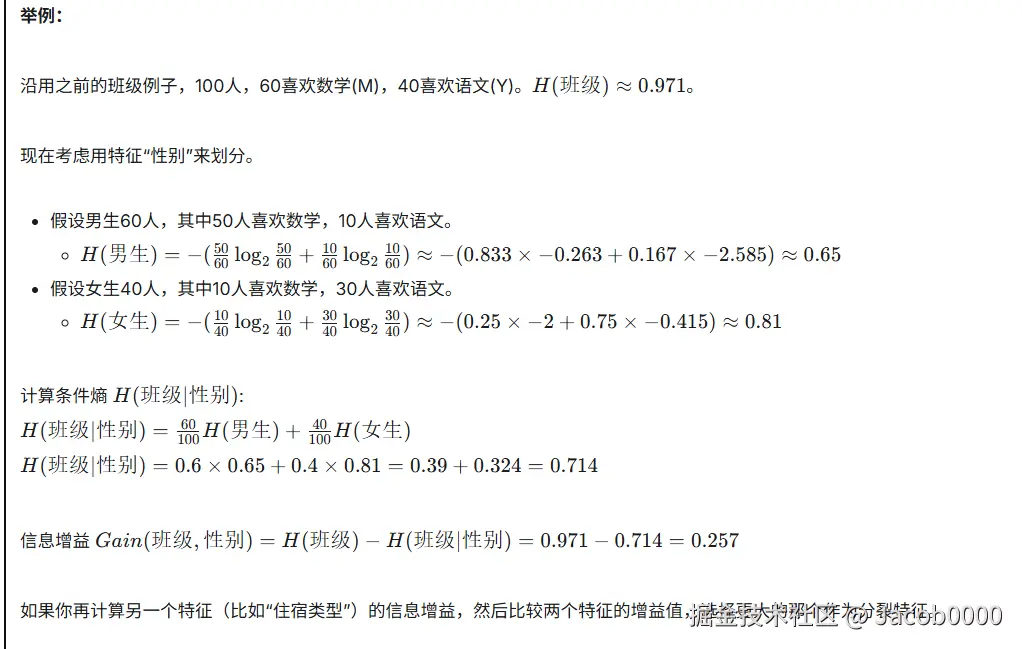
信息增益: 在知道(已知)某个特征A 后,数据集 的不确定性减少了多少。 通俗来说,就是通过特征A对该数据集D进行划分后,能够带来多少"信息",从而使得D变得更"纯"了。
信息增益越大,说明使用该特征进行划分的D的效果越好。
直观理解:
- 想象你有一堆混合的水果(苹果、香蕉、橙子),熵很高(很混乱)。
- 现在你用"颜色"这个特征来划分:红色的放一堆,黄色的放一堆,绿色的放一堆。
- 如果红色的那一堆主要是苹果,黄色的主要是香蕉,绿色的主要是青苹果,那么"颜色"这个特征就为你提供了很多信息,使得每一堆水果都变得更纯了。这种纯度的提升就是信息增益。
- 如果按"形状"划分,结果每堆里还是苹果香蕉橙子混着,那"形状"提供的信息增益就小。
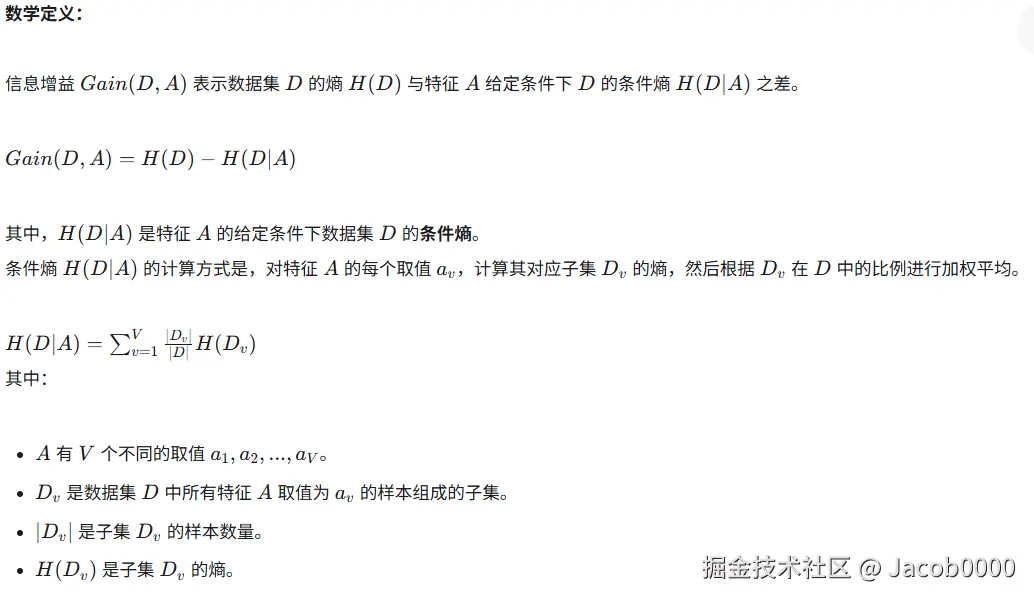
选择标准: (特征选取) 在ID3算法 中,决策树生成时,总是选择信息增益最大 的特征 作为当前节点的分裂特征。