我们都知道,hive默认的计算引擎是mr,但是mr计算依赖于磁盘,导致计算非常缓慢,开启本地模式会稍微快一点,但是治标不治本,于是有些公司就将计算引擎切换成tez或者spark。
spark作为目前主流的离线计算引擎,非常的方便,所以很多企业都想直接将计算引擎换成spark,但目前hive和spark结合有两种方式Spark On Hive ,还有一种Hive On Spark,到底应该怎么选择呢?
从字面意思不难看出,Spark On Hive 肯定是以spark为主,hive为辅助,而Hive On Spark,却是以hive为主,spark为辅助。
那目前的技术主流肯定是park,所以spark on hive肯定是主流。
那什么是spark on hive 呢?
让 Spark 能够读取 Hive 中创建的元数据(数据库、表结构等),从而可以用 Spark SQL 直接查询 Hive 表。
核心配置:只需要在 Spark 端进行配置,告诉 Spark 元数据服务在哪里。
Hive on Spark 的现状
Hive on Spark 并没有消失,但它有非常特定的使用场景:
-
历史遗留系统迁移:对于那些有大量复杂 HiveQL 脚本、UDF 且迁移到 Spark SQL 成本极高的企业,Hive on Spark 是一个不错的折中方案。它允许他们用最小的改动(只是换一个执行引擎)来提升性能。
-
对 HiveQL 有强依赖的团队 :如果团队技能栈完全集中在 Hive,短期内转向 Spark SQL 有困难。
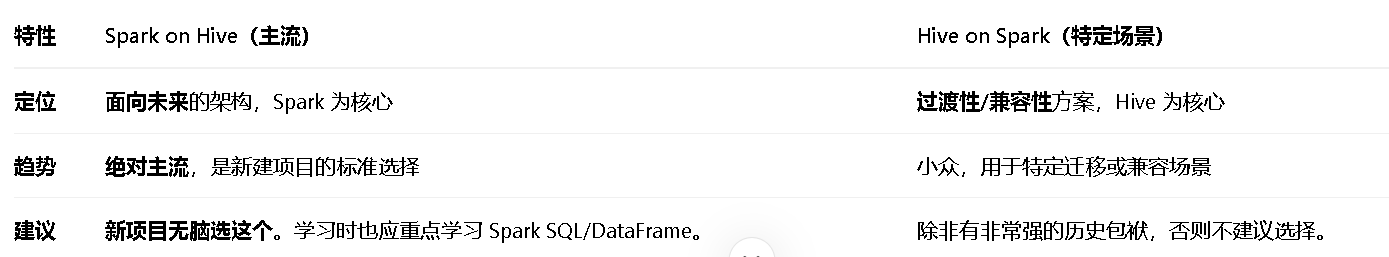
核心思想
-
Spark on Hive :配置 Spark 去连接 Hive 的元数据服务。
-
Hive on Spark :配置 Hive 去使用 Spark 作为其执行引擎。