Kubernetes 集群调度与PV和PVC详解
- 前言
- [一、Kubernetes 集群调度](#一、Kubernetes 集群调度)
-
-
- [1. List-Watch 组件与工作机制](#1. List-Watch 组件与工作机制)
- [2. Pod 创建与工作机制流程](#2. Pod 创建与工作机制流程)
- [3. 调度器(Scheduler)过程](#3. 调度器(Scheduler)过程)
- [4. 指定调度节点方式](#4. 指定调度节点方式)
-
- [4.1 nodeName(强制绑定)](#4.1 nodeName(强制绑定))
- [4.2 nodeSelector(基于标签匹配)](#4.2 nodeSelector(基于标签匹配))
- [5. 节点亲和性与 Pod 亲和性](#5. 节点亲和性与 Pod 亲和性)
-
- [5.1 节点亲和性(NodeAffinity)](#5.1 节点亲和性(NodeAffinity))
- [5.2 Pod 亲和性与反亲和性](#5.2 Pod 亲和性与反亲和性)
- [6. 污点(Taint) 和 容忍(Tolerations)](#6. 污点(Taint) 和 容忍(Tolerations))
-
- [6.1 污点(Taint)](#6.1 污点(Taint))
- [6.2 容忍 (Tolerations)](#6.2 容忍 (Tolerations))
- [7. 节点维护操作](#7. 节点维护操作)
- [8. Pod 生命周期(Phase)](#8. Pod 生命周期(Phase))
- [9. 故障排查命令](#9. 故障排查命令)
- [10. 总结图与思维导引](#10. 总结图与思维导引)
-
- [二、PV 与 PVC](#二、PV 与 PVC)
-
-
- [1. 容器存储的短暂性问题](#1. 容器存储的短暂性问题)
- [2. emptyDir 存储卷](#2. emptyDir 存储卷)
- [3. hostPath 存储卷](#3. hostPath 存储卷)
- [4. NFS 网络共享存储卷](#4. NFS 网络共享存储卷)
- [5. PV 与 PVC 持久化机制](#5. PV 与 PVC 持久化机制)
-
- [5.1 概念](#5.1 概念)
- [5.2 生命周期](#5.2 生命周期)
- [5.3 PV 的状态](#5.3 PV 的状态)
- [5.4 回收策略](#5.4 回收策略)
- [6. NFS + PV + PVC 实战](#6. NFS + PV + PVC 实战)
- [7. StorageClass + NFS 动态存储](#7. StorageClass + NFS 动态存储)
- [8. 总结](#8. 总结)
-
- 结语
前言
在当今云原生技术迅速发展的时代,Kubernetes(简称K8s)作为容器编排领域的佼佼者,已经成为企业构建和管理容器化应用的首选平台。Kubernetes 不仅提供了强大的容器编排能力,还通过其丰富的调度机制和存储解决方案,确保了应用的高可用性、可扩展性和灵活性。本文将深入探讨 Kubernetes 集群调度机制以及持久化存储卷(PV)和持久化存储声明(PVC)的相关知识,帮助读者全面理解并掌握这些关键技术。
一、Kubernetes 集群调度
1. List-Watch 组件与工作机制
Kubernetes 通过 List-Watch 机制实现各个组件之间的协作与数据同步,从而达到解耦与实时一致性的目的。关键组件包括:
- kubectl / API 客户端:向 APIServer 发起资源创建或管理请求。
- APIServer:负责 API 调用、权限校验、存储交互,是集群控制的核心入口。
- etcd:存储集群所有状态信息。
- Controller Manager:维持副本数、执行自愈逻辑(扩容、重建等)。
- Scheduler:将未分配节点的 Pod 分配到合适的 Node。
- kubelet:节点代理,负责 Pod 生命周期管理和容器运行状态上报。
这些组件通过监听(Watch)APIServer 发出的事件,实现数据的实时同步与协作。
2. Pod 创建与工作机制流程
Pod 的创建过程涉及多个组件的协同工作,主要包括以下步骤:
- 三大组件启动监听 :Controller Manager、Scheduler 和 kubelet 分别监听集群资源事件变化。
启动后会分别通过 Watch API Server(HTTPS 6443 端口)监听集群资源事件变化。
- Controller Manager:监听副本控制类对象(如 ReplicaSet、Deployment)
- Scheduler:监听未调度的 Pod
- kubelet:监听分配到本节点的 Po
- 用户创建 Pod 对象 :通过
kubectl或其他 API 客户端发送创建 Pod 的请求给 APIServer。
bash
kubectl apply -f pod.yaml- API Server 将 Pod 信息写入 etcd:经过校验和权限控制后,Pod 的元数据被存储在 etcd 中。
- etcd 通知事件:etcd 接收到 Pod 信息后,触发 Create 事件并发送给 APIServer。
- Controller Manager 监听到 Pod 创建事件:通过 Watch 机制收到事件后,确保副本数量满足需求。
- Replication Controller(RC)/ ReplicaSet 保证副本数 :Controller Manager 在接到 Create 事件以后,如果发现副本数量不足,则由 RC/ReplicaSet 创建所需副本。
- API Server 更新 etcd(记录详细信息):Controller Manager 创建完 Pod 副本后,API Server 会将 Pod 的详细信息更新写入 etcd(包括副本数量、副本模板、容器规格等。)。
- etcd 触发 Pod 信息更新事件:etcd 再次发送更新事件给 API Server。
- Scheduler 监听到待调度的 Pod:为未分配节点的 Pod 选择合适的 Node。
- Scheduler 更新调度结果 :Scheduler 将选定的 Node 信息写回到 API Server。API Server 更新 etcd 中该 Pod 的 Node 绑定信息。
- etcd 确认更新 & API Server 同步结果:etcd 更新成功后向 API Server 返回确认。API Server 同步 Pod 的最新状态(包括 Node 绑定结果)。
- kubelet 在 Node 上拉取并运行容器:根据调度结果,kubelet 负责容器的创建和运行,并上报状态给 APIServer。
- API Server 更新 Pod 状态 :API Server 将 kubelet 上报的状态写入 etcd。etcd 确认写入成功后,集群状态完成同步,Pod 正式进入 Running 状态
整个过程确保了 Pod 从创建到运行的每一个环节都得到有效管理和监控。
3. 调度器(Scheduler)过程
Scheduler 的核心任务是将未绑定 Node 的 Pod 分配到合适的节点,主要目标包括:
- 公平性:节点间资源分配均衡。
- 高效性:集群所有资源最大化被使用。
- 效率:调度的性能要好,能够尽快地对大批量的 Pod 完成调度工作。
- 灵活性:允许自定义策略(调度策略、插件)。
调度过程分为两个主要阶段:
-
过滤阶段(Predicate):过滤掉不满足条件的节点,常见算法包括:
- PodFitsResources:检查节点剩余资源是否满足 Pod 需求。
- PodFitsHost:检查 NodeName 是否匹配。
- PodFitsHostPorts:检查端口冲突。
- PodSelectorMatches:label 匹配。
- NoDiskConflict:Volume 挂载冲突检测。
-
优选阶段(Priorities):对可行节点进行打分排序,常见算法包括:
- LeastRequestedPriority:资源使用率越低,权重越高。
- BalancedResourceAllocation:CPU 与内存使用率越接近越好。
- ImageLocalityPriority:优先节点上已有目标镜像的节点。
最终,Scheduler 会选择权重最高的节点进行调度。
4. 指定调度节点方式
4.1 nodeName(强制绑定)
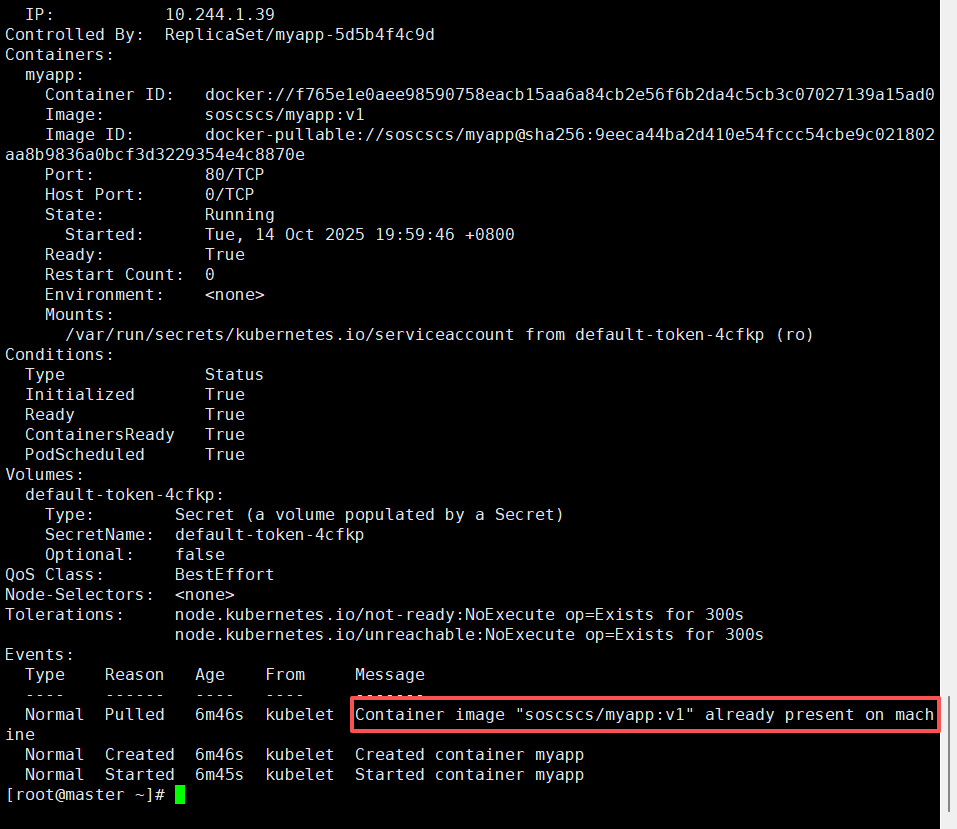
通过在 Pod 的 YAML 文件中指定 nodeName,可以直接将 Pod 调度到特定的 Node 节点上,跳过 Scheduler 的调度策略。
示例:
yaml
spec:
  nodeName: node01
----------
apiVersion: apps/v1
kind: Deployment
metadata:
  name: myapp
spec:
  replicas: 3
  selector:
    matchLabels:
      app: myapp
  template:
    metadata:
      labels:
        app: myapp
    spec:
      nodeName: node1
      containers:
      - name: myapp
        image: soscscs/myapp:v1
        ports:
        - containerPort: 80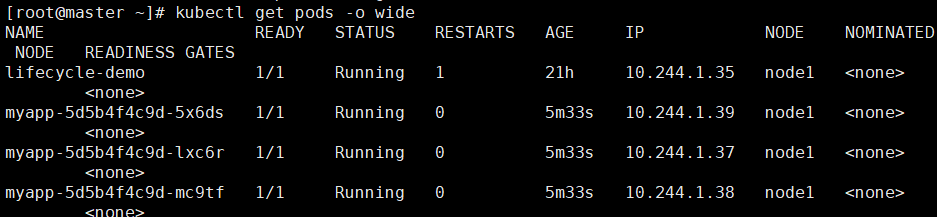
4.2 nodeSelector(基于标签匹配)
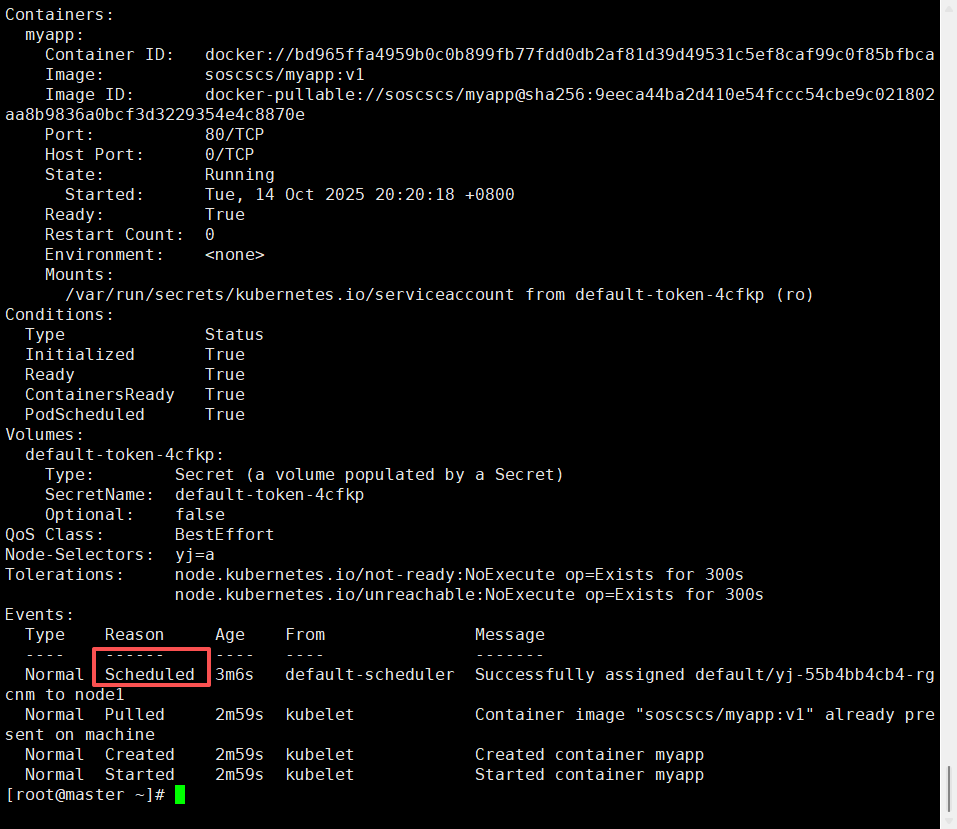
通过 nodeSelector,利用 Kubernetes 的 label-selector 机制选择节点,由调度器根据标签匹配调度 Pod 到目标节点。
示例:
yaml
spec:
  nodeSelector:
    yj: a
------------------------------------
    apiVersion: apps/v1
kind: Deployment
metadata:
  name: yj
spec:
  replicas: 3
  selector:
    matchLabels:
      app: yj
  template:
    metadata:
      labels:
        app: yj
    spec:
      nodeSelector:
        yj: a
      containers:
      - name: myapp
        image: soscscs/myapp:v1
        ports:
        - containerPort: 80
kubectl get nodes --show-labels
kubectl describe pod yj-55b4bb4cb4-rgcnm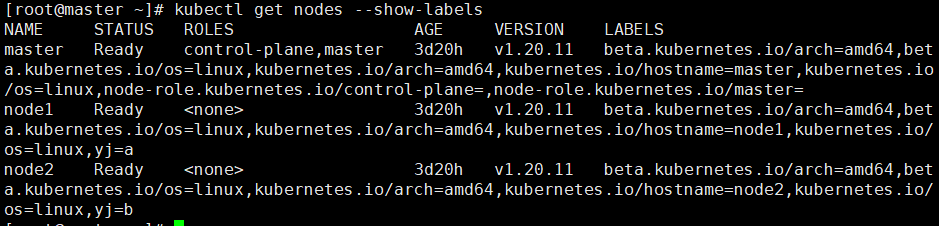
管理 Node 标签的常用命令包括 kubectl label nodes 以及相关的查询和修改命令。
bash
kubectl label nodes node01 yjs=a
kubectl get nodes --show-labels
#指定标签查询 node 节点
kubectl get node -l yjs=a
##修改一个 label 的值,需要加上 --overwrite 参数
kubectl label nodes node02 yjs=b --overwrite
###删除一个 label,只需在命令行最后指定 label 的 key 名并与一个减号相连即可:
kubectl label nodes node02 yjs-
5. 节点亲和性与 Pod 亲和性
5.1 节点亲和性(NodeAffinity)
节点亲和性允许 Pod 指定其偏好的节点或强制要求调度到特定节点,分为硬策略和软策略。
- 硬策略(requiredDuringSchedulingIgnoredDuringExecution):必须满足的条件,不满足则 Pod 处于 Pending 状态。
- 软策略(preferredDuringSchedulingIgnoredDuringExecution):优先考虑的条件,但不强制。
bash
affinity:
  nodeAffinity:
    requiredDuringSchedulingIgnoredDuringExecution:   # 硬策略
preferredDuringSchedulingIgnoredDuringExecution: # 软策略| 运算符 | 含义 | 通俗理解 | 示例 |
|---|---|---|---|
| In | label 的值在列表中 | "只要它的值在我列的名单里,就选上它" | env In (dev, test) → 选出 env=dev 或 env=test 的 Pod |
| NotIn | label 的值不在列表中 | "黑名单里的不要" | env NotIn (prod) → 除了生产环境都选上 |
| Gt | label 的值大于某个数 | "比这个数字大的才要" | version Gt 3 → 选出 version=4,5,6... 的 Pod |
| Lt | label 的值小于某个数 | "比这个数字小的才要" | version Lt 3 → 选出 version=1,2 的 Pod |
| Exists | label 存在即可 | "只要有这个标签就算数,不管值是啥" | Exists zone → 只要有 zone 这个标签 |
| DoesNotExist | label 不存在 | "没有这个标签的才要" | DoesNotExist debug → 没有 debug 标签的 Pod |
In / NotIn 看"名单",
Gt / Lt 看"数值",
Exists / DoesNotExist 看"有没有"。
示例:
- 硬策略案例:
yaml
apiVersion: v1
kind: Pod
metadata:
  name: affinity
  labels:
    app: node-affinity-pod
spec:
  containers:
  - name: with-node-affinity
    image: soscscs/myapp:v1
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
        - matchExpressions:
          - key: kubernetes.io/hostname
            operator: NotIn
            values:
            - node2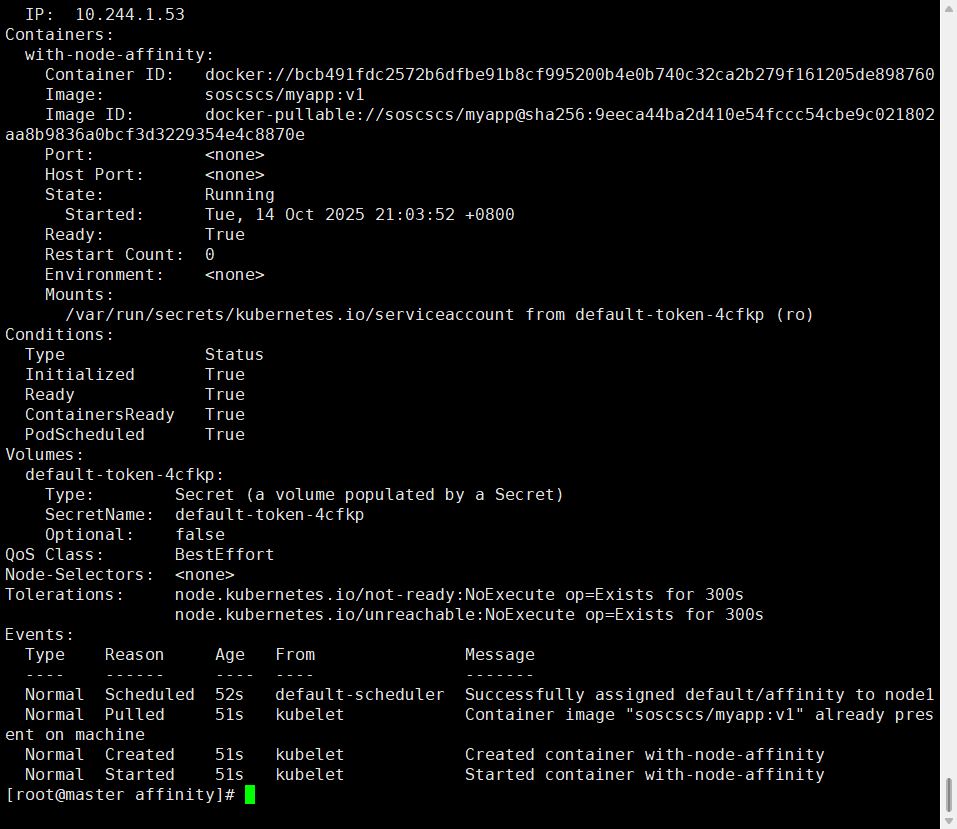
- 软策略案例:
yaml
apiVersion: v1
kind: Pod
metadata:
  name: affinity2
  labels:
    app: node-affinity-pod
spec:
  containers:
  - name: with-node-affinity
    image: soscscs/myapp:v1
  affinity:
    nodeAffinity:
      preferredDuringSchedulingIgnoredDuringExecution:
      - weight: 1
        preference:
          matchExpressions:
          - key: kubernetes.io/hostname
            operator: In
            values:
- node3 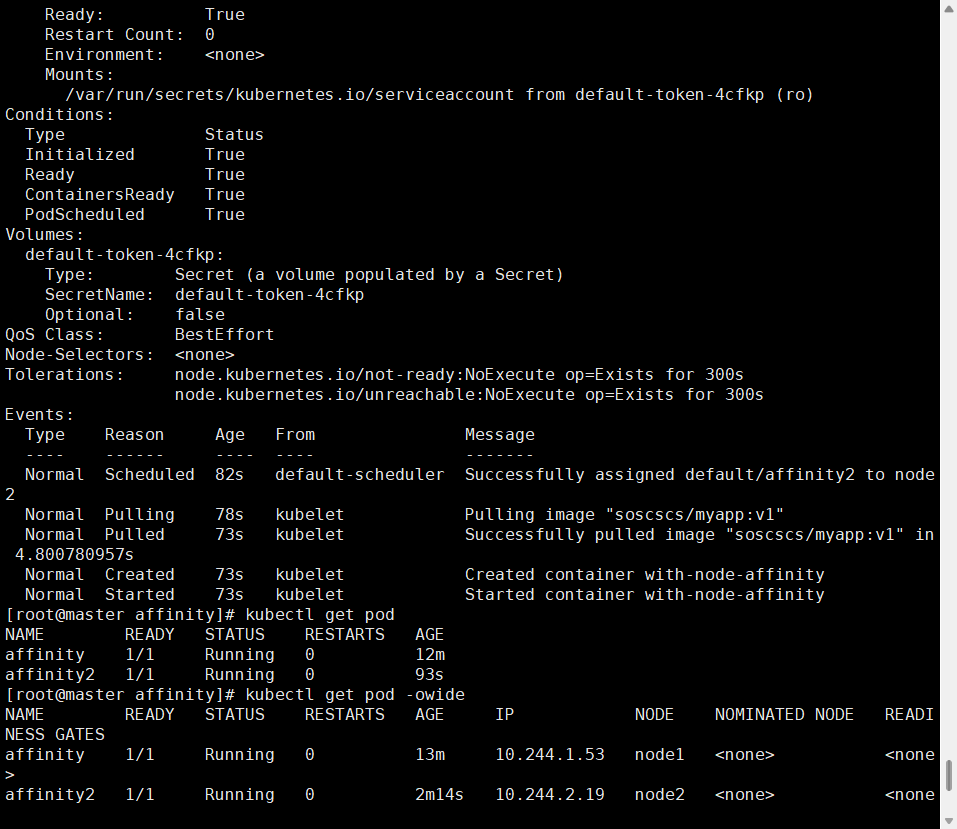
- 软硬策略案例:
yaml
apiVersion: v1
kind: Pod
metadata:
  name: affinity3
  labels:
    app: node-affinity-pod
spec:
  containers:
  - name: with-node-affinity
    image: soscscs/myapp:v1
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
        - matchExpressions:
          - key: kubernetes.io/hostname
            operator: NotIn
            values:
            - node2
      preferredDuringSchedulingIgnoredDuringExecution:
      - weight: 1
        preference:
          matchExpressions:
          - key: yj
            operator: In
            values:
            - a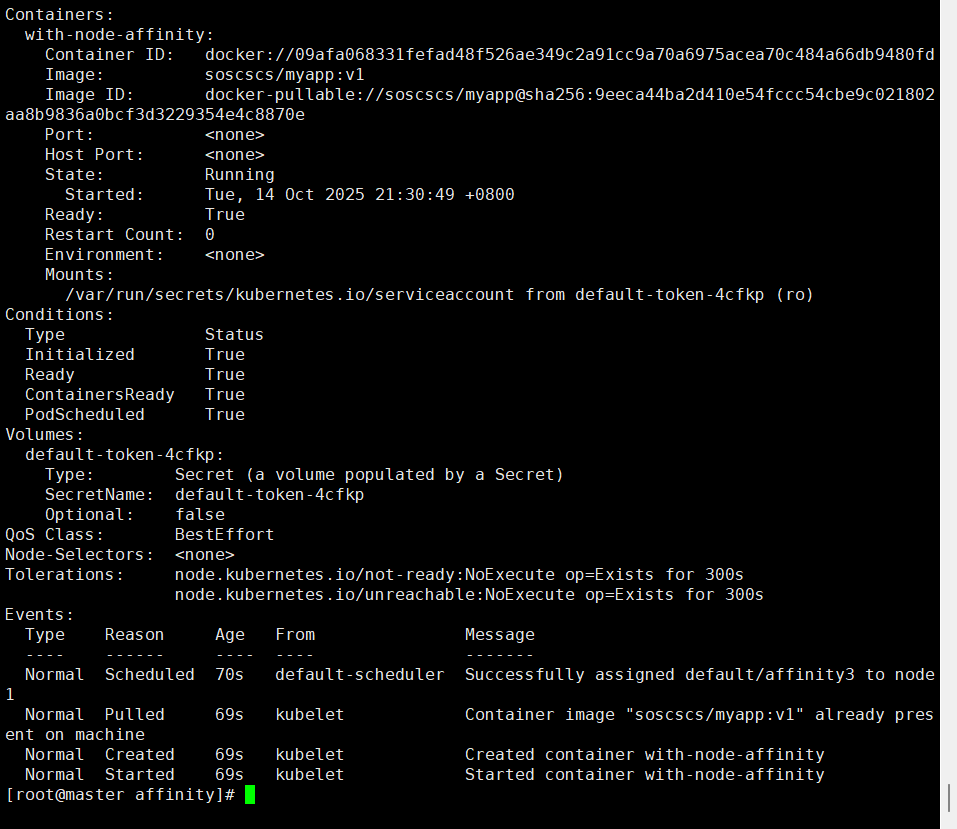
5.2 Pod 亲和性与反亲和性
| 调度策略 | 匹配标签 | 操作符 | 拓扑域支持 | 调度目标 |
|---|---|---|---|---|
| nodeAffinity | 主机 | IIn, NotIn, Exists,DoesNotExist, Gt, Lt | ❌ | 指定主机 |
| podAffinity | Pod | In, NotIn, Exists,DoesNotExist | ✅ | 与指定 Pod 同域 |
| podAntiAffinity | Pod | In, NotIn, Exists,DoesNotExist | ✅ | 与指定 Pod 不同域 |
- Pod 亲和性(podAffinity):将 Pod 调度到与指定 Pod 相同的拓扑域。
yaml
#分别创建,优先创建标签,或者 topologyKey 键值修改为 {kubernetes.io/hostname(同节点)|topology.kubernetes.io/zone(同可用域)}
#1
apiVersion: v1
kind: Pod
metadata:
  name: myapp1
  labels:
    app: myapp1
spec:
  containers:
  - name: with-node-affinity
    image: soscscs/myapp:v1
#2
apiVersion: v1
kind: Pod
metadata:
  name: myapp2
  labels:
    app: myapp2
spec:
  containers:
  - name: myapp2
    image: soscscs/myapp:v1
  affinity:
    podAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
      - labelSelector:
          matchExpressions:
          - key: app
            operator: In
            values:
            - myapp1
        topologyKey: yj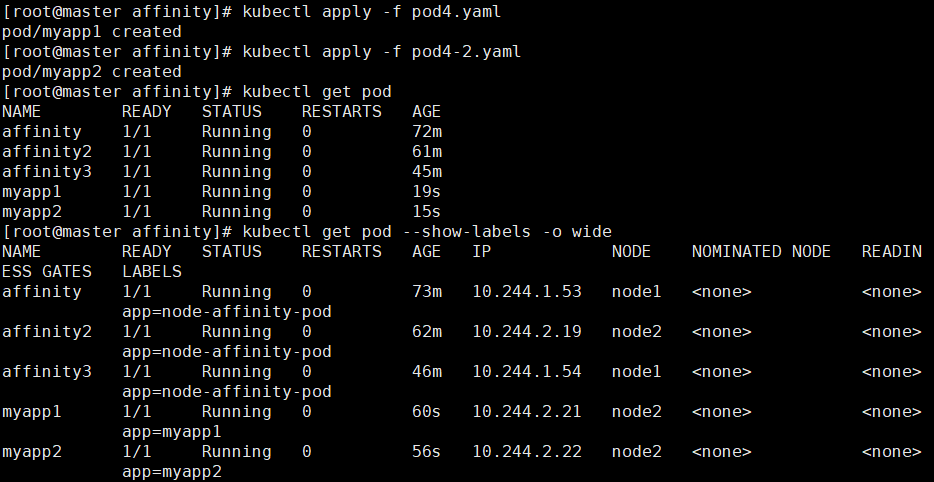
- Pod 反亲和性(podAntiAffinity):将 Pod 调度到与指定 Pod 不同的拓扑域。
yaml
apiVersion: v1
kind: Pod
metadata:
  name: myapp10
  labels:
    app: myapp10
spec:
  containers:
  - name: myapp10
    image: soscscs/myapp:v1
  affinity:
    podAntiAffinity:
      preferredDuringSchedulingIgnoredDuringExecution:
      - weight: 100
        podAffinityTerm:
          labelSelector:
            matchExpressions:
            - key: app
              operator: In
              values:
              - myapp1
          topologyKey: kubernetes.io/hostname
----------------------------------------------------
#pod
apiVersion: v1
kind: Pod
metadata:
  name: myapp20
  labels:
    app: myapp20
spec:
  containers:
  - name: myapp20
    image: soscscs/myapp:v1
  affinity:
    podAntiAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
      - labelSelector:
          matchExpressions:
          - key: app
            operator: In
            values:
            - myapp1
        topologyKey: yj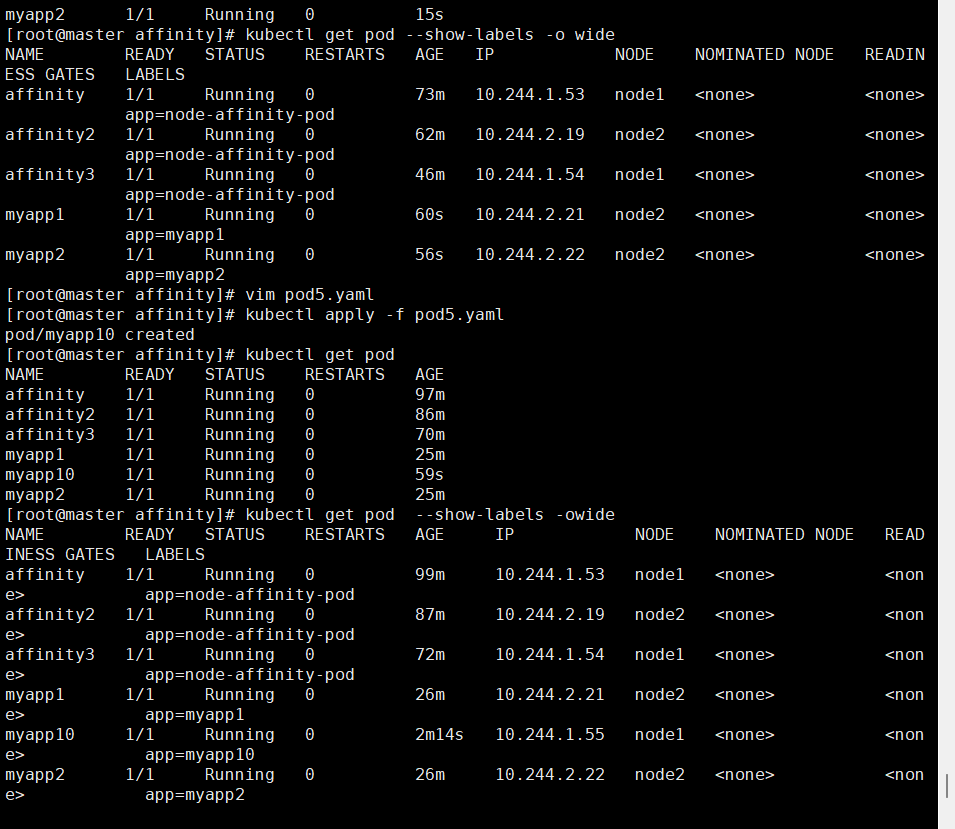
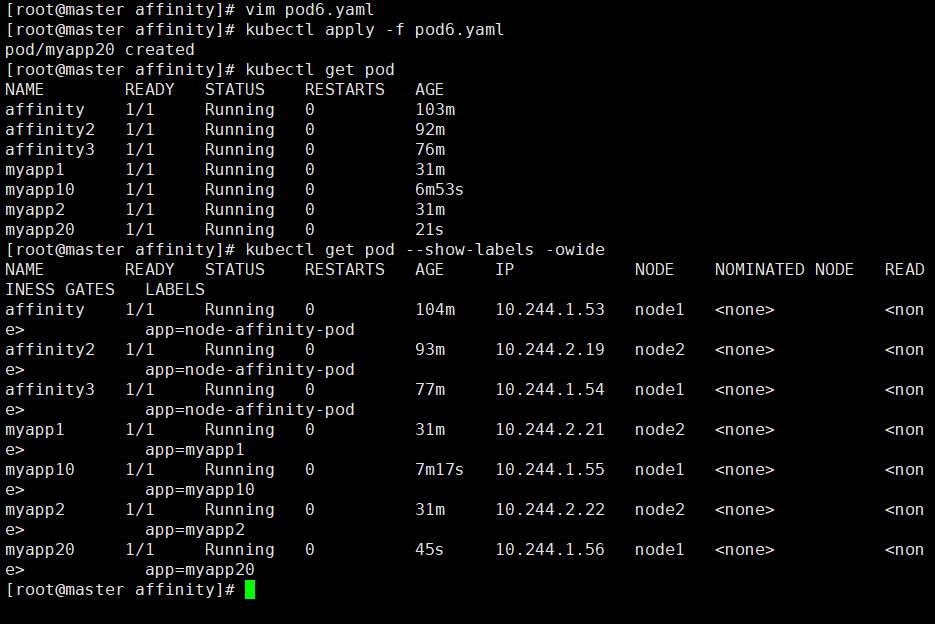
应用场景包括将相关服务的 Pod 部署在同一节点以提高性能,或将不同服务的 Pod 分散部署以提高可用性。
6. 污点(Taint) 和 容忍(Tolerations)
6.1 污点(Taint)
污点用于排斥某些 Pod 被调度到特定节点,节点通过设置污点来拒绝不兼容的 Pod。污点格式为 key=value:effect,支持三种效应:
- NoSchedule:不调度到此节点。
- PreferNoSchedule:尽量避免调度具有该污点的 Node 上。
- NoExecute:不调度 + 驱逐已存在 Pod。
示例:
bash
#设置污点
kubectl taint node node01 key1=value1:NoSchedule
#节点说明中,查找 Taints 字段
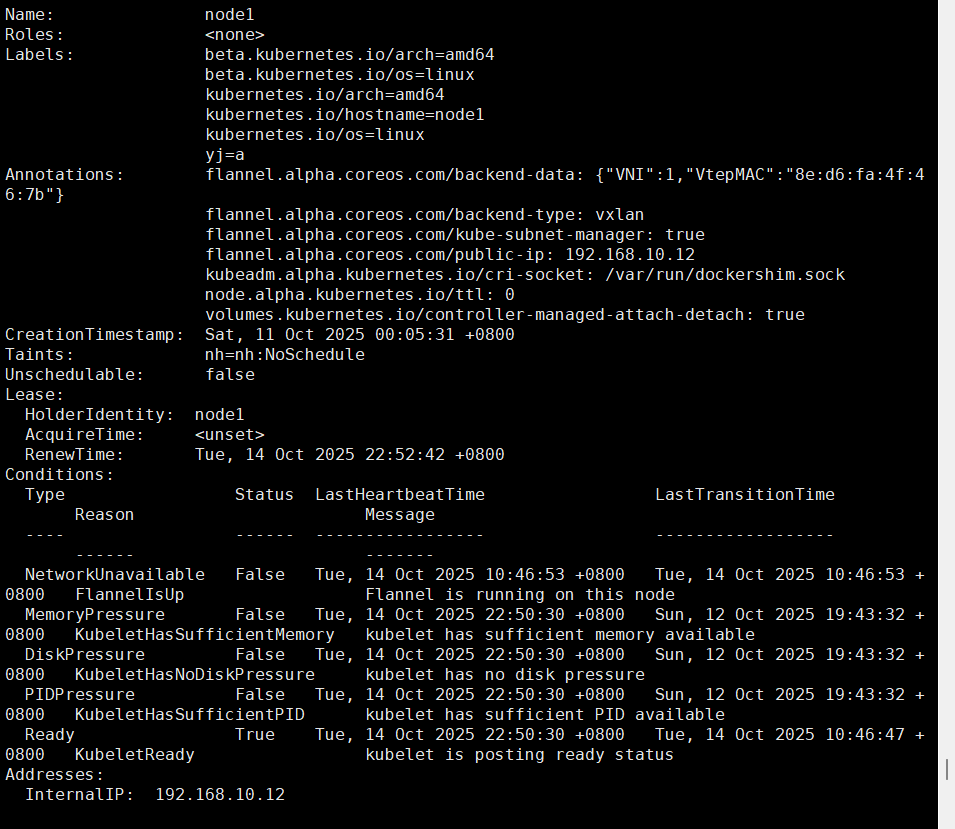
kubectl describe node node-name
#去除污点
kubectl taint node node01 key1:NoSchedule-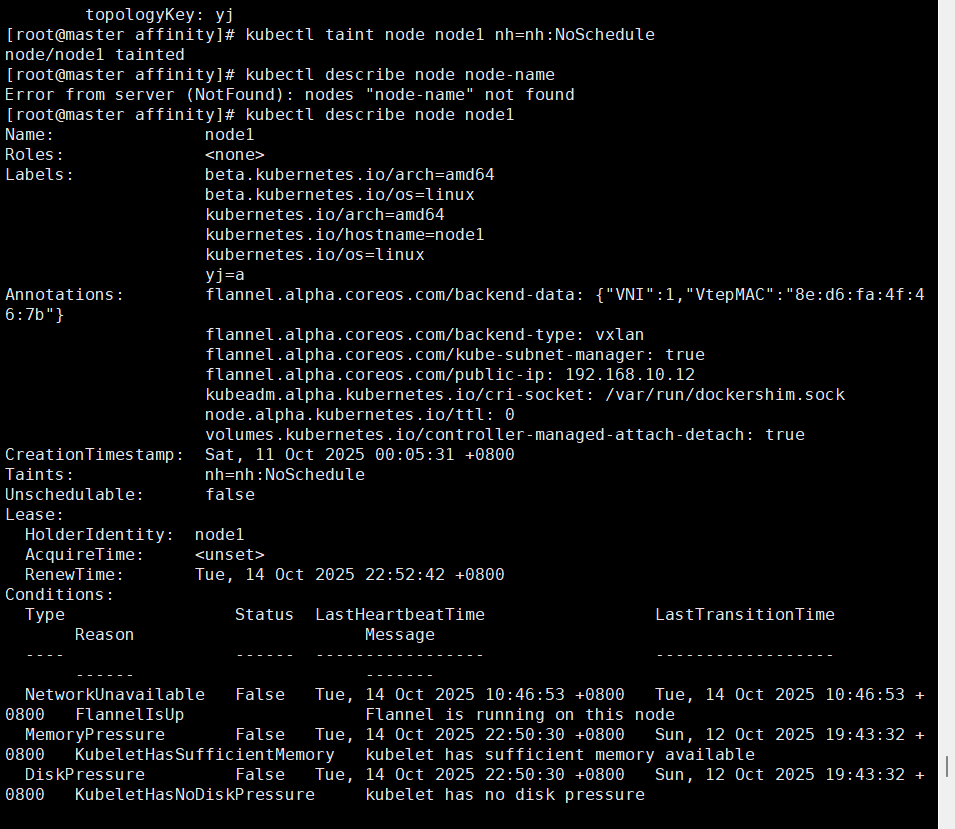
6.2 容忍 (Tolerations)
容忍允许 Pod 被调度到具有匹配污点的节点上,通过在 Pod 的 YAML 文件中定义容忍项。
示例:
yaml
apiVersion: v1
kind: Pod
metadata:
  name: myapp01
  labels:
    app: myapp01
spec:
  containers:
  - name: with-node-affinity
    image: soscscs/myapp:v1
  tolerations:
  - key: "check"
    operator: "Equal"  #operator: "Equal" #Equal意味着这个值等于value,如果是Exists,则不需要填写value,只要有这个key就容忍
    value: "mycheck"
    effect: "NoExecute"
    tolerationSeconds: 3600
7. 节点维护操作
Kubernetes 提供了 cordon 和 drain 命令,用于节点的维护和 Pod 的迁移。
- cordon:标记节点为不可调度。
- drain :驱逐节点上的 Pod,通常结合
cordon使用。 - uncordon:恢复节点的可调度状态。
示例:
bash
kubectl cordon <node>
kubectl drain <node> --ignore-daemonsets --delete-local-data --force
kubectl uncordon <node>
8. Pod 生命周期(Phase)
Pod 的生命周期包括多个阶段:
- Pending:已创建但未调度或拉取镜像中。
- Running:容器已启动运行中。
- Succeeded:所有容器成功终止(适用于 Job 类)。
- Failed:容器失败退出(非0或异常)。
- Unknown:无法获取状态(通信异常)。
9. 故障排查命令
常用的故障排查命令包括:
- 查看事件 :
kubectl describe pod <POD> - 查看日志 :
kubectl logs <POD> [-c 容器名] - 进入容器 :
kubectl exec -it <POD> bash - 查看集群状态 :
kubectl cluster-info - 查看节点状态 :
kubectl get nodes - 查看 kubelet 日志 :
journalctl -xefu kubelet
10. 总结图与思维导引
Kubernetes 的调度机制和存储解决方案通过一系列组件和策略协同工作,确保集群的高效运行和资源的合理分配。总结如下:
-
核心调度策略层次:
- nodeName(直接绑定)
- nodeSelector(Label 匹配)
- nodeAffinity / podAffinity(亲和性调度)
- Taint & Toleration(污点/容忍机制)
- cordon & drain(节点维护与Pod迁移)
-
思维总结 :"调度是吸引,污点是排斥,亲和性是偏好,容忍是例外。"
二、PV 与 PVC
1. 容器存储的短暂性问题
容器的文件系统是临时性的,容器崩溃重启后数据会丢失,且同一 Pod 内的多个容器难以直接共享文件。Kubernetes 通过 Volume 抽象解决了这些问题,利用 Pause 容器 让多个容器共享同一个 Volume,实现文件共享与持久化。
2. emptyDir 存储卷
特点:
- Pod 调度到节点时自动创建。
- Pod 删除后数据也随之销毁。
- 仅适合临时缓存或容器间数据共享。
示例 :通过 emptyDir 实现两个容器间的数据共享。
3. hostPath 存储卷
特点:
- 将节点(宿主机)上的目录挂载到容器。
- 可实现持久化,但节点故障会导致数据丢失。
示例 :通过 hostPath 实现容器数据的持久化存储,即使 Pod 重建也能访问相同内容。
4. NFS 网络共享存储卷
特点:
- 多节点共享数据。
- 数据集中存放于 NFS 服务端。
- 支持 RWX(多路读写)。
示例:通过 NFS 实现跨节点的存储共享,确保数据的持久化和多节点访问。
5. PV 与 PVC 持久化机制
5.1 概念
- PV(Persistent Volume):由运维工程师定义的持久化存储卷,描述底层存储资源。
- PVC(Persistent Volume Claim) :由应用开发者定义的存储需求,描述希望使用的 PV 存储。
关系:PVC 与 PV 绑定,PVC 根据需求申请 PV,PV 由存储资源创建。
5.2 生命周期
PV 和 PVC 的相互作用遵循以下生命周期:
- Provisioning(配置):PV 的创建,可以是静态或动态。
- Binding(绑定):将 PV 分配给 PVC。
- Using(使用):Pod 通过 PVC 使用 Volume。
- Releasing(释放):Pod 释放 Volume 并删除 PVC。
- Recycling(回收):回收 PV,可以选择保留、删除或清空数据。
5.3 PV 的状态
- Available(可用):未被任何 PVC 绑定。
- Bound(已绑定):已绑定到 PVC。
- Released(已释放):PVC 被删除,但资源尚未回收。
- Failed(失败):自动回收失败。
5.4 回收策略
- Retain:保留数据,需手动清理。
- Delete:自动删除存储资源。
- Recycle:清空数据重新可用(仅 NFS / HostPath 支持)。
6. NFS + PV + PVC 实战
步骤:
- 配置 NFS 存储:在 NFS 服务器上配置共享目录。
- 定义 PV:创建多个 PV,定义挂载路径、访问模式和容量。
- 定义 PVC + Pod:创建 PVC 申请 PV,并在 Pod 中使用 PVC。
- 测试访问 :通过访问 Pod 验证存储数据的持久性和共享性。
示例:通过 NFS 实现 PV 和 PVC 的绑定,确保 Pod 能够访问并持久化存储数据。
7. StorageClass + NFS 动态存储
Kubernetes 本身对 NFS 的动态 PV 创建支持有限,因此需要使用外部存储卷插件如 nfs-client-provisioner 实现自动 PV 创建。
步骤:
- 安装与配置 NFS:在 NFS 服务器上配置共享目录。
- 创建 Service Account:管理 NFS Provisioner 的权限。
- 部署 NFS Provisioner:部署负责创建 PV 的 Provisioner。
- 创建 StorageClass:定义 StorageClass,关联 NFS Provisioner。
- 测试 PVC + Pod :通过 StorageClass 自动申请 PV,并在 Pod 中使用。
示例:通过 StorageClass 实现 NFS 存储的动态 PV 创建,简化存储管理流程。
8. 总结
| 存储类型 | 生命周期 | 共享性 | 持久性 | 典型场景 |
|---|---|---|---|---|
| emptyDir | Pod 生命周期 | 同 Pod 内 | ❌ | 临时缓存 |
| hostPath | 节点生命周期 | 单节点 | ✅ | 节点级存储 |
| NFS | 独立服务 | 多节点 | ✅✅ | 集群共享存储 |
| PV + PVC | 集群级别 | 按需分配 | ✅✅✅ | 生产环境 |
| StorageClass | 自动创建 PV | 动态 | ✅✅✅✅ | 大规模部署 |
结语
Kubernetes 的集群调度机制和持久化存储解决方案(PV 与 PVC)是构建稳定、高效、可扩展容器化应用的基础。通过深入了解和掌握这些关键技术,开发者和运维人员能够更好地管理集群资源,优化应用部署,提高系统的可靠性和灵活性。
调度机制确保了 Pod 能够被合理地分配到最优的节点,满足应用的性能和可用性需求;而持久化存储解决方案则为有状态应用提供了数据持久化和共享的能力,保障了数据的安全与可靠。
随着云原生技术的不断发展,Kubernetes 将继续演化,提供更多强大的功能和更简化的管理体验。希望本文能够为您在 Kubernetes 的学习和实践中提供有价值的参考,助力您在云原生领域的进一步探索与创新。
"调度是吸引,污点是排斥,亲和性是偏好,容忍是例外。" 这句话不仅总结了 Kubernetes 调度的核心思想,也提醒我们在复杂的集群环境中,合理利用各种策略和机制,实现资源的最优配置与应用的高效运行。