基础模型 是一种有前景的发展,它们可以通过"提示"技术对新的数据集和任务进行零样本和少样本学习。Segment Anything 是 Meta AI 在 2023 年提出的。它主要用于解决图像分割中的核心挑战,即如何让机器理解并标注出图像中所有有意义的对象或区域,而不仅仅是预先定义的类别。+
传统的图像分割模型针对特定任务设计,需大量标注数据,且难以适应新场景,SAM 则试图超越这些限制,能够识别和分割图像中几乎任何东西,即可以在没有额外训练 的情况下,应用于各种不同的图像分布和任务,具有**"零样本" 泛化能力**。
可提示分割任务以及实际应用的目标对模型架构施加了限制。(1)模型必须支持灵活的提示,(2)需要能够以摊销的实时方式计算掩码以允许交互式使用,(3)必须具备处理歧义的能力。
一个简单的设计可以满足这三个约束条件:一个强大的图像编码器 计算图像嵌入,一个提示编码器 对提示进行嵌入,然后这两种信息源在一个轻量级掩码解码器 中结合,用于预测分割掩码。我们将该模型称为**"Segment Anything Model**",简称 SAM。该算法为每个训练样本模拟一系列提示(例如点、框、掩码),并将模型的掩码预测与真实标签进行比较。
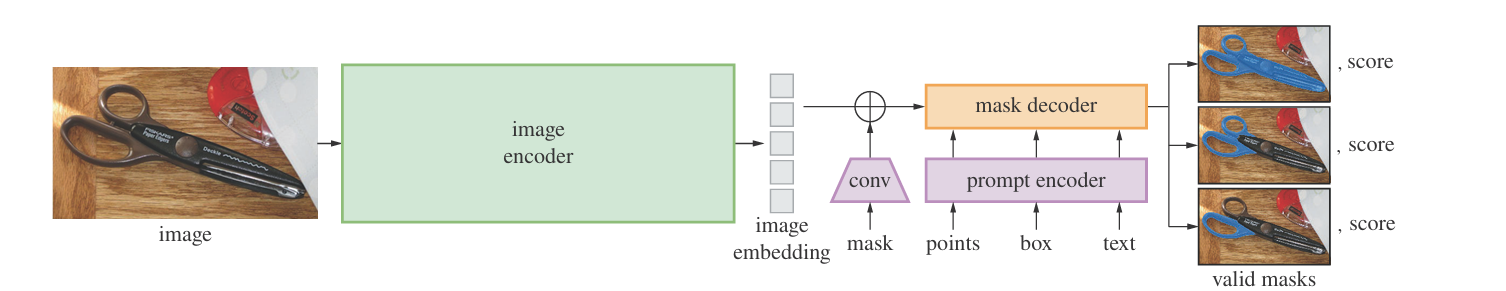
SAM有三个组件,图像编码器、灵活的提示编码器和快速的掩码解码器。
**图像编码器:**受可扩展性和强大预训练方法的启发,使用了预训练的 ViT 模型将图像编码得到图像嵌入。
提示编码器:将点、框、掩码、文本等提示信息进行编码,后续会和图像嵌入一起用于生成掩码。对于点和框等稀疏提示,输出稀疏嵌入(sparse_embeddings),对于掩码这种密集提示,输出密集嵌入(dense_embeddings)。通过将位置编码与针对每种提示类型学习的嵌入相加来表示点和框,并使用 CLIP 的现成文本编码器表示自由文本。密集提示(即掩码)使用卷积进行嵌入,并与图像嵌入按元素相加。
掩码解码器:将图像编码器得到的图像嵌入和提示编码器得到的提示嵌入整合,然后结合两个可学习的 tokens 生成不同层级的掩码和对应的置信度值。如果指定了 "multimask_output" 参数则会输出 3 个层级的掩码,否则只输出 1 个掩码。
SAM 的训练损失主要针对掩码预测精度 设计,采用交叉熵损失(Cross-Entropy Loss),具体分为:
-
掩码分类损失
-
掩码分割损失(二进制交叉熵损失(BCE Loss) 或Dice 损失)
-
多掩码损失加权(如 3 个不同精度的掩码)