最近在做老系统优化,正好遇到了需要使用字符串内部化的场景,所以今天就来说说字符串内部化这种优化技巧。
什么是字符串内部化
熟悉Java或者python的开发者应该对"内部化"这种技术不陌生。内部化指的是对于内容完全相同的字符串变量,内存中只保留一份数据,所有的变量都引用同一份数据,从而节约内存。
举个Java的例子:
java
public class StringInternDemo {
    public static void main(String[] args) {
        String s1 = new String("hello");
        String s2 = "hello";

        // 使用 intern 方法
        String s3 = s1.intern();

        System.out.println(s1 == s2); // false,因为 s1 是堆中新建的对象
        System.out.println(s2 == s3); // true,因为 s3 指向字符串常量池中的 "hello"
    }
}例子中s3和s1是不同的两个字符串变量,但它们共享同一份字符串数据。在python中可以用sys.intern(str)实现类似的功能,而且python更进一步------对于长度短且不包含特殊字符的字符串默认会自动进行内部化。
可以看到所谓内部化,其实相当于创建了一个"字符串缓存",我们可以把字符串放进缓存里,然后在需要的时候取出来复用,取的时候既可以用变量也可以用常量。不过这么做需要字符串类型本身是不可变的,因为所有相同内容的字符串变量共享同一份数据,如果其中一个变量意外修改了这份数据,其他和它共享的字符串变量都将受到"污染"。好在不管Java、python还是Golang,字符串类型都是不可变的。
那么字符串内部化的好处是什么呢?好处在于可以减少内存分配次数且节约内存用量,我们不必为了内容相同的字符串反复申请内存空间。不过和其他类型的缓存一样,如果命中率不够高那么这个缓存不仅不会带来任何提升反而还会浪费大量内存并加重gc负担。
字符串内部化在处理数据的反序列化时是一种很重要的优化手段。
举个例子,某个公司需要汇总处理每个员工的业绩数据,数据中包含员工所在部门和职位等信息。我们知道一个公司的员工可能有几千个几万个甚至几十万个,但公司里的部分数量往往不会超过三位数,职位分类也是如此,即使数据再多它们也只会有固定数量的取值不会增多,反过来员工的姓名就很少会有重复数据,你几乎可以总是预估姓名的数量小于等于员工总数且随着员工数量增加而增加。如果没有字符串内部化,每收到一条数据,我们就要重复创建部门名称和职务头衔这些字符串,数据量越大浪费的内存就越多;而如果我们能把这些名称头衔的字符串全部缓存起来,后续只要让新变量共享这些数据,就能带来非常可观的内存利用率提升和性能改善。
另外除了字符串,其他符合"低基数"(取值重量有限,但整体数量很大,比如上文的部门名称)特征的数据都可以利用内部化进行优化。
Golang中手动实现内部化
在了解了什么是内部化,并且看了Java的例子,现在我们可以讲讲在Golang里如何实现这一技术了。
最原始的实现是这样的:
golang
type StringIntern struct {
    m map[string]string
}

func (s *StringIntern) Intern(str string) string {
    ret, ok := s.m[str]
    if !ok {
        ret = strings.Clone(str)
        s.m[str] = ret
    }
    return ret
}

var si StringIntern
s1 := "hello"
s2 := si.Intern(s1)
用法上没有和Java有多少区别,代码也很简单,唯一需要解释的是在字符串存进map的时候我们需要clone一次,这是为了避免参数str是某个长字符串的子串,因为我们的map需要长期持有str,如果是上述情况,这个长字符串就会无法释放从而造成泄露。
如果是在反序列化场景使用,可能需要调用unsafe.String(bytes, length)来获取字符串避免不必要的内存分配。
这个方案足够应付大多数场景,但还有一个比较麻烦的问题------我们没有实现淘汰机制,这会导致内部化池的规模越来越大。
想要在用户代码层面解决这个问题往往会变得得不偿失------我们需要额外的空间记录内部化的字符是否需要淘汰,并在每次获取字符串时处理缓存淘汰或者周期性扫描并释放"过期"的字符串,这不仅增加实现复杂度还会降低性能。
但好在go有垃圾回收器,我们可以拜托垃圾回收器帮我们进行清理,只要没有引用继续指向字符串,它就会被回收。但这要求我们的map不能持有内部化的str,想实现这个效果需要费点功夫并且要用unsafe。
因为内部化的需求实在太常见,已经有人把代码帮我们写好了:go4.org/intern
这个包的原理和我们的StringIntern一样,不过map的值换成了一种可以让gc及时回收的类型,这个包我不过多解释,因为如果你能用go1.24或者更新版本,那么unique标准库会提供更快更安全的替代品,那就没必要再引入这个外部依赖了。
用法上也和我们自己实现的内部化差不多:
golang
import "go4.org/intern"

s1 := "hello"
s2 := intern.GetByString(s1)另外go4.org/intern不仅仅可以内部化字符串,它还可以内部化很多别的类型的数据,然而这一功能也被标准库的unique全面替代并超越了。
所以如果你能保证需要内部化的字符串数量很少并且不会变动,那么使用StringIntern足矣,否则就需要使用下面要讲解的unique包了。
unique包和内部化
unique包并不是为了字符串内部化而被引入的。
最早需要unique的地方是net/netip这个包,确切得说是里面的表示IPv6地址的类型需要它。
按照规范,TPv4地址可以以v6的形式进行表示,并且IPv6地址都有一个叫zone的东西来区分不同的网络。为了符合规范也方便进行操作,netip中的每个地址类型都需要包含isV4 bool和zone string这两个字段。
isV4是标准的"低基数"变量,zone不是。但问题出在目前没有多少人主动使用zone,而且也没多少人爱用IPv6形式表示v4的地址,这就导致了这两个变量的基数都很低,而且它们组合之后的基数还要更低。结构体里带上它们就会浪费至少20字节,因此开发者提出了一种存储开销和一个指针变量相同且能对低基数变量实现内部化的标准库功能。
这就是unique包。unique里核心的只有unique.Handle[T]和unique.Make。
unique.Handle[T]是前面说的只有一个指针大小的可以表示被内部化数据的东西。从类型名字上可以看出这是一个泛型类型,它可以表示任何可比较的类型的值。它有一个Value方法,可以返回被表示的类型为T的值。
unique.Make则用来创建unique.Handle[T],它的用法和我们的StringIntern.Intern是一样的。并且Make也和我们的实现一样,会clone自己的参数,以避免内存泄露或者其他的生命周期问题。
所以只要把上一节我们使用intern包的例子稍微修改就能使用unique了:
golang
import "unique"

s1 := unique.Make("hello")
s2 := unique.Make("hello")
fmt.Println(s1.Value(), s2.Value())
fmt.Println(s1 == s2) // true

s3 := unique.Make("hello1")
fmt.Println(s1 == s3) // false,快速比较api变得有些复杂我们不能之间获取value,需要通过Handle进行中介,但作为好处,一个Handle只有8字节,而string有至少16字节,另一个好处在于通过比较Handle我们可以快速判断两个被内部化的值是否相同------本来我们很可能需要进行长字符串的比较,但利用Handle,我们只要对比一下8字节的数据是否相同就行。
同时unique包还可以利用gc,只要没有Handle继续,这些内部化的数据就会在下一次垃圾回收的时候被释放,没有泄露的风险。和go4.org/intern相比unique在传参的时候利用的是泛型而不是interface,还可以避免一次额外的内存分配开销。
unique和intern都可以在并发场景下使用,unique内部使用无锁的hashtrie实现,而intern使用锁来保证map的并发安全,因此unique又胜一筹。
所以在新版本的go代码中如果有利用内部化的需求,应该优先考虑unique。
性能对比
最后做一下go4.org/intern和unique的性能对比。测试代码是我从文章开头说的老系统的数据解析逻辑里裁剪下来的,代码会解析一串二进制数据并生成对应的结构体。数据中很大字符串的内容是重复的,因此非常适合使用内部化进行优化:
golang
type Data struct {
	A, B, C, D string
}

type Data2 struct {
	A, B, C, D unique.Handle[string]
}

type Data3 struct {
	A, B, C, D *intern.Value
}

func main() {
	fmt.Println("Data size:", unsafe.Sizeof(Data{})) // 64
	fmt.Println("Data2 size:", unsafe.Sizeof(Data2{})) // 32
	fmt.Println("Data3 size:", unsafe.Sizeof(Data3{})) // 32
}
可以看到光是采用内部化之后结构体的存储成本就已经节约了50%。下面再看看利用内部化之后对解析速度的影响:
golang
var (
	pool1 = sync.Pool{
		New: func() any {
			return &Data{}
		},
	}
	pool2 = sync.Pool{
		New: func() any {
			return &Data2{}
		},
	}
	pool3 = sync.Pool{
		New: func() any {
			return &Data3{}
		},
	}
)

//go:noinline
func ParseString(b []byte) *Data {
	d := pool1.Get().(*Data)
	d.A = string(b[:16])
	d.B = string(b[16:32])
	d.C = string(b[32:48])
	d.D = string(b[48:64])
	return d
}

//go:noinline
func ParseUnique(b []byte) *Data2 {
	d := pool2.Get().(*Data2)
	s1 := unsafe.String(&b[0], 16)
	s2 := unsafe.String(&b[16], 16)
	s3 := unsafe.String(&b[32], 16)
	s4 := unsafe.String(&b[48], 16)
	d.A = unique.Make(s1)
	d.B = unique.Make(s2)
	d.C = unique.Make(s3)
	d.D = unique.Make(s4)
	return d
}

//go:noinline
func ParseIntern(b []byte) *Data3 {
	d := pool3.Get().(*Data3)
	s1 := unsafe.String(&b[0], 16)
	s2 := unsafe.String(&b[16], 16)
	s3 := unsafe.String(&b[32], 16)
	s4 := unsafe.String(&b[48], 16)
	d.A = intern.GetByString(s1)
	d.B = intern.GetByString(s2)
	d.C = intern.GetByString(s3)
	d.D = intern.GetByString(s4)
	return d
}

func BenchmarkParseString(b *testing.B) {
	data := []byte("aaaaaaaaaaaaaaaabbbbbbbbbbbbbbbbccccccccccccccccdddddddddddddddd")
	for range b.N {
		d := ParseString(data)
        pool1.Put(d)
	}
}

func BenchmarkParseUnique(b *testing.B) {
	data := []byte("aaaaaaaaaaaaaaaabbbbbbbbbbbbbbbbccccccccccccccccdddddddddddddddd")
	for range b.N {
		d := ParseUnique(data)
        pool2.Put(d)
	}
}

func BenchmarkParseIntern(b *testing.B) {
	data := []byte("aaaaaaaaaaaaaaaabbbbbbbbbbbbbbbbccccccccccccccccdddddddddddddddd")
	for range b.N {
		d := ParseIntern(data)
        pool3.Put(d)
	}
}给函数加上noinline是为了更加贴近项目中的实际代码,项目中的代码除了字符串之外还有很多整数和bool值需要解析,解析出来的值还需要经过简单的校验,因此编译器解析函数里东西太多没法内联,我们这里简化了逻辑只保留了字符串处理,但在内联上和实际的代码保持一致,因为内联或者不内联会大幅改变性能测试结果。数据对象我们也做了池化尽量减少任何环节上不必要的分配。
测试结果:
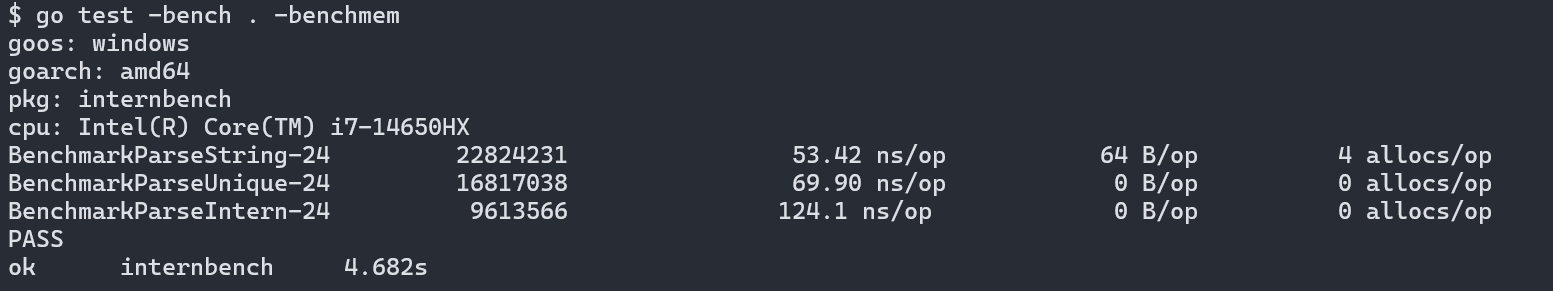
采用内部化的函数完全避免了内存分配,unique性能优于intern,但速度上比原先的版本慢了25%。这是因为unique需要计算字符串的hash然后去hashtrie里取数据,比起小块内存分配来说这个步骤会慢一些,另外性能测试运行时间比较短测试内容也比较简单,gc压力体现得没有生产环境上明显,因此看着有不小的速度差异,但实际生产环境上内部化因为几乎不额外分配内存,不仅内存占用少很多,速度上的差异也几乎没有监测到。
总结
内部化是一种专门针对"低基数"数据进行的优化方法。对于基数不低的数据使用则会收到明显的反效果。
同时也要记住,虽然内存分配的少了,但查找并返回被内部保存的数据也是需要额外花费时间的,因此对于非热点代码或者运行时间较短的程序来说这种优化也有些舍近求远了。