目录
[1. Collection (单值存储)](#1. Collection (单值存储))
[2. Map (键值对存储)](#2. Map (键值对存储))
二、Collection和Collections有什么区别?⭐⭐⭐⭐⭐
[1. Collection - 【运动员】](#1. Collection - 【运动员】)
[2. Collections - 【裁判/教练】](#2. Collections - 【裁判/教练】)
[1. 增强 for 循环 (最常用、最简洁)](#1. 增强 for 循环 (最常用、最简洁))
[2. 迭代器 (Iterator) - 安全删除元素的方式](#2. 迭代器 (Iterator) - 安全删除元素的方式)
[3. 普通 for 循环 (仅适用于 List)](#3. 普通 for 循环 (仅适用于 List))
[4. forEach() 方法 (Java 8+,函数式风格)](#4. forEach() 方法 (Java 8+,函数式风格))
五、什么是fail-fast?什么是fail-safe?⭐⭐⭐⭐⭐
[1. fail-fast 机制](#1. fail-fast 机制)
[2. fail-safe 机制](#2. fail-safe 机制)
[1. 使用 Iterator 的 remove() 方法(推荐⭐)](#1. 使用 Iterator 的 remove() 方法(推荐⭐))
[2. 使用 for 循环 + 索引(小心使用⚠️)](#2. 使用 for 循环 + 索引(小心使用⚠️))
[3. 使用 CopyOnWriteArrayList(并发场景推荐⭐)](#3. 使用 CopyOnWriteArrayList(并发场景推荐⭐))
[4. 使用 removeIf() 方法(Java 8+ 最简洁⭐)](#4. 使用 removeIf() 方法(Java 8+ 最简洁⭐))
八、ArrayList、LinkedList与Vector的区别?⭐⭐⭐⭐⭐
[1. ArrayList - 动态数组](#1. ArrayList - 动态数组)
[2. LinkedList - 双向链表](#2. LinkedList - 双向链表)
[3. Vector - 线程安全的动态数组](#3. Vector - 线程安全的动态数组)
九、ArrayList的subList方法有什么需要注意的地方吗?⭐⭐⭐
[1. 非独立性:子列表是原始列表的"窗口"](#1. 非独立性:子列表是原始列表的“窗口”)
[2. 结构性修改的相互影响与异常](#2. 结构性修改的相互影响与异常)
[3. 不支持序列化](#3. 不支持序列化)
[✅ 正确用法:短期只读视图](#✅ 正确用法:短期只读视图)
[✅ 正确用法:创建独立的副本](#✅ 正确用法:创建独立的副本)
[1. 序列化过程 (writeObject)](#1. 序列化过程 (writeObject))
[2. 反序列化过程 (readObject)](#2. 反序列化过程 (readObject))
[关键设计:transient 关键字](#关键设计:transient 关键字)
[1. 链地址法](#1. 链地址法)
[2. 开放定址法](#2. 开放定址法)
[3. 再哈希法](#3. 再哈希法)
[4. 建立公共溢出区](#4. 建立公共溢出区)
[HashMap 数据结构总结](#HashMap 数据结构总结)
十三、HashMap、Hashtable和ConcurrentHashMap的区别?⭐⭐⭐⭐⭐
[1. HashMap (线程不安全)](#1. HashMap (线程不安全))
[2. Hashtable (线程安全但性能差)](#2. Hashtable (线程安全但性能差))
[3. ConcurrentHashMap (线程安全且高性能)](#3. ConcurrentHashMap (线程安全且高性能))
[JDK 1.7 实现:分段锁](#JDK 1.7 实现:分段锁)
[JDK 1.8 实现:CAS + synchronized(更优)](#JDK 1.8 实现:CAS + synchronized(更优))
十四、HashMap在get和put时经过哪些步骤?⭐⭐⭐⭐
十六、为什么HashMap的默认负载因子设置成0.75⭐⭐⭐
[为什么是 0.75?------ 两种极端情况的折衷](#为什么是 0.75?—— 两种极端情况的折衷)
[情况一:负载因子过小(例如 0.5)](#情况一:负载因子过小(例如 0.5))
[情况二:负载因子过大(例如 1.0)](#情况二:负载因子过大(例如 1.0))
[0.75 的数学与统计学依据](#0.75 的数学与统计学依据)
[1. 触发条件](#1. 触发条件)
[2. 扩容核心方法 resize()](#2. 扩容核心方法 resize())
[JDK 1.8 扩容优化详解](#JDK 1.8 扩容优化详解)
[优化原理:(e.hash & oldCap) == 0](#优化原理:(e.hash & oldCap) == 0)
十九、为什么在JDK8中HashMap要转成红黑树⭐⭐⭐⭐⭐
[1. 解决链表过长导致的性能退化](#1. 解决链表过长导致的性能退化)
[2. 红黑树的性能优势](#2. 红黑树的性能优势)
[3. 树化阈值的设计](#3. 树化阈值的设计)
二十一、HashMap的remove方法是如何实现的?⭐⭐⭐⭐
二十二、ConcurrentHashMap是如何保证线程安全的?⭐⭐⭐⭐⭐
[JDK 版本演进对比](#JDK 版本演进对比)
二十三、ConcurrentHashMap在哪些地方做了并发控制⭐⭐⭐
二十四、ConcurrentHashMap是如何保证fail-safe的?⭐⭐⭐⭐
[与 ArrayList/HashMap 的 Fail-Fast 对比](#与 ArrayList/HashMap 的 Fail-Fast 对比)
[方案一:使用 java.util.concurrent 包 (推荐)](#方案一:使用 java.util.concurrent 包 (推荐))
[1.1 ConcurrentHashMap - 替代 HashMap/Hashtable](#1.1 ConcurrentHashMap - 替代 HashMap/Hashtable)
[1.2 CopyOnWriteArrayList - 替代 ArrayList/Vector](#1.2 CopyOnWriteArrayList - 替代 ArrayList/Vector)
[1.3 ConcurrentLinkedQueue - 并发队列](#1.3 ConcurrentLinkedQueue - 并发队列)
[方案二:使用 Collections.synchronizedXXX() 包装器](#方案二:使用 Collections.synchronizedXXX() 包装器)
[2.1 基本用法](#2.1 基本用法)
[2.2 重要注意事项:复合操作仍需同步](#2.2 重要注意事项:复合操作仍需同步)
[2.3 迭代器也需要同步](#2.3 迭代器也需要同步)
[方案三:使用 CopyOnWrite 集合](#方案三:使用 CopyOnWrite 集合)
[3.1 CopyOnWriteArrayList 实战](#3.1 CopyOnWriteArrayList 实战)
[3.2 CopyOnWriteArraySet 的使用](#3.2 CopyOnWriteArraySet 的使用)
[4.1 基本模式](#4.1 基本模式)
[4.2 使用 ReentrantLock 更灵活](#4.2 使用 ReentrantLock 更灵活)
[Copy-On-Write (COW) 总结](#Copy-On-Write (COW) 总结)
[二十七、Java 8中的Stream用过吗?都能干什么?⭐⭐⭐⭐](#二十七、Java 8中的Stream用过吗?都能干什么?⭐⭐⭐⭐)
[Stream 能做什么?------ 五大核心操作类型](#Stream 能做什么?—— 五大核心操作类型)
[1. filter(Predicate) - 条件过滤](#1. filter(Predicate) - 条件过滤)
[2. distinct() - 去重](#2. distinct() - 去重)
[3. limit(n) / skip(n) - 分页](#3. limit(n) / skip(n) - 分页)
[1. map(Function) - 元素转换](#1. map(Function) - 元素转换)
[2. flatMap(Function) - 扁平化转换(处理嵌套集合)](#2. flatMap(Function) - 扁平化转换(处理嵌套集合))
[1. sorted() - 排序](#1. sorted() - 排序)
[2. 查找与匹配](#2. 查找与匹配)
[1. reduce - 归约操作](#1. reduce - 归约操作)
[2. 数值流专门操作](#2. 数值流专门操作)
[1. Collectors.toList()/toSet() - 转换为集合](#1. Collectors.toList()/toSet() - 转换为集合)
[2. Collectors.toMap() - 转换为Map](#2. Collectors.toMap() - 转换为Map)
[3. Collectors.groupingBy() - 分组](#3. Collectors.groupingBy() - 分组)
[4. Collectors.partitioningBy() - 分区](#4. Collectors.partitioningBy() - 分区)
[总结:Stream 的核心价值](#总结:Stream 的核心价值)
二十八、为什么ConcurrentHashMap不允许null值?⭐⭐⭐⭐
[三十、ConcurrentHashMap为什么在JDK 1.8中废弃分段锁?⭐⭐⭐⭐](#三十、ConcurrentHashMap为什么在JDK 1.8中废弃分段锁?⭐⭐⭐⭐)
[1. JDK 1.7 的分段锁 (Segment Locking)](#1. JDK 1.7 的分段锁 (Segment Locking))
[2. JDK 1.8 的新机制 (Node Locking + CAS)](#2. JDK 1.8 的新机制 (Node Locking + CAS))
三十一、ConcurrentHashMap为什么在JDK1.8中使用synchronized而不是ReentrantLock⭐⭐⭐⭐
[1. 锁粒度变细,竞争概率降低(前提条件)](#1. 锁粒度变细,竞争概率降低(前提条件))
[2. synchronized 的显著优势](#2. synchronized 的显著优势)
一、Java中的集合类有哪些?如何分类的?⭐⭐⭐⭐
1、Java集合框架全景图
Java 集合框架主要分为两大接口派系:Collection 和 Map。
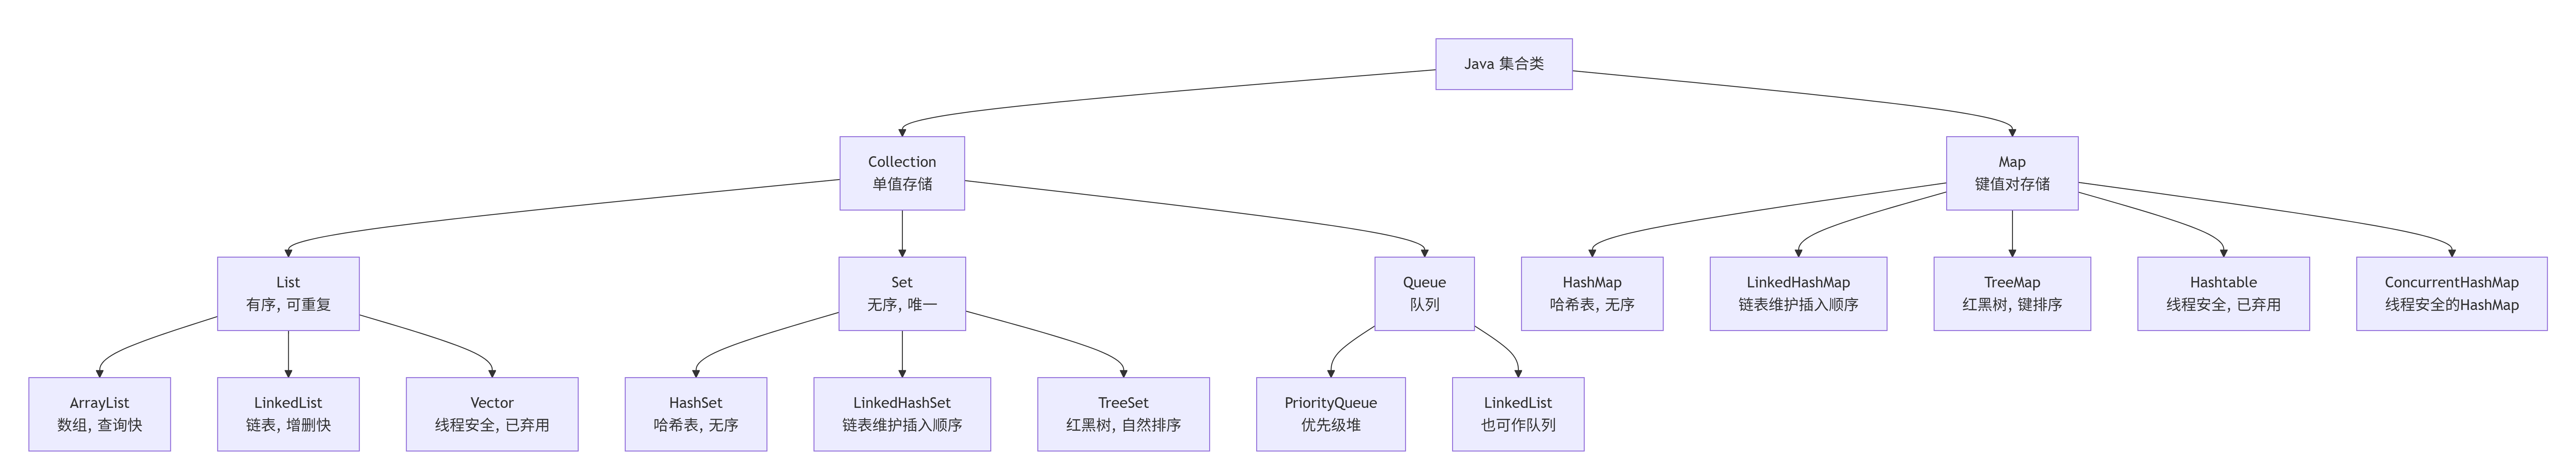
2、核心接口详解
1. Collection (单值存储)
| 接口 | 特点 | 主要实现类 |
|---|---|---|
List |
有序、可重复、有索引 | ArrayList, LinkedList, Vector |
Set |
无序、唯一 | HashSet, LinkedHashSet, TreeSet |
Queue |
队列,先进先出 | PriorityQueue, LinkedList |
2. Map (键值对存储)
| 接口/类 | 特点 | 线程安全 |
|---|---|---|
HashMap |
基于哈希表,无序 ,key唯一 | 否 |
LinkedHashMap |
保持插入顺序 或访问顺序 | 否 |
TreeMap |
基于红黑树,key自然排序 | 否 |
Hashtable |
古老的实现,线程安全但性能差 | 是 |
ConcurrentHashMap |
高效线程安全的 HashMap | 是 |
3、如何选择集合类?
记住这个决策流程:
-
需要存储键值对吗?
-
是 → 使用
Map接口下的类。-
不需要排序 →
HashMap -
需要插入/访问顺序 →
LinkedHashMap -
需要 key 排序 →
TreeMap -
需要线程安全 →
ConcurrentHashMap
-
-
-
否,存储单个元素。需要保证元素唯一吗?
-
是 → 使用
Set接口下的类。-
不需要排序 →
HashSet -
需要插入顺序 →
LinkedHashSet -
需要自然排序 →
TreeSet
-
-
-
否,元素可以重复。
-
使用
List接口下的类。-
查询多,增删少 →
ArrayList -
增删多,查询少 →
LinkedList -
需要线程安全 →
CopyOnWriteArrayList(不在基础图内,但很重要)
-
-
-
需要队列特性吗?
-
是 → 使用
Queue接口下的类。-
标准队列 →
LinkedList -
优先级队列 →
PriorityQueue
-
-
总结
-
Collection管单值 ,分 List(有序重复)、Set(无序唯一)、Queue(队列)。 -
Map管键值对 ,核心是 HashMap ,变体有 LinkedHashMap(有序)、TreeMap(排序)。 -
线程安全 不用
Hashtable/Vector,用ConcurrentHashMap/CopyOnWriteArrayList。
理解这张分类图和使用场景,你就掌握了 Java 集合框架的命脉。
二、Collection和Collections有什么区别?⭐⭐⭐⭐⭐
核心结论
Collection 是一个顶级的集合接口,而 Collections 是一个操作集合的工具类。 它们的关系,类似于"运动员"与"裁判/教练"的关系。
详细对比
| 方面 | Collection | Collections |
|---|---|---|
| 身份 | 接口 | 工具类 |
| 功能 | 定义了集合的基本操作(如 add, remove) | 提供了操作集合的静态工具方法(如排序、搜索) |
| 使用方式 | 被类实现(如 ArrayList, HashSet) | 通过类名直接调用静态方法 |
| 目的 | 规定集合"是什么" | 提供集合"怎么用"的辅助功能 |
核心角色解析
1. Collection - 【运动员】
它是所有单列集合的根接口,定义了运动员的基本规范。
-
子接口 :
List,Set,Queue -
实现类 :
ArrayList,LinkedList,HashSet等。
java
java
// Collection 是一个需要被实现的接口
Collection<String> list = new ArrayList<>(); // ArrayList 实现了 Collection 接口
list.add("Hello");
list.remove("World");
2. Collections - 【裁判/教练】
它是一个不可实例化的工具类 ,内部全是静态方法,用于服务和支持Collection框架。
常用方法举例:
java
java
List<Integer> numbers = Arrays.asList(3, 1, 4, 1, 5);

// 排序
Collections.sort(numbers); // [1, 1, 3, 4, 5]

// 反转
Collections.reverse(numbers); // [5, 4, 3, 1, 1]

// 获取最大/最小值
Integer max = Collections.max(numbers); // 5
Integer min = Collections.min(numbers); // 1

// 将线程不安全的集合转换为线程安全的(包装)
List<Integer> syncList = Collections.synchronizedList(numbers);

// 创建空集合,避免返回null
List<String> emptyList = Collections.emptyList();
总结记忆
-
Collection(单数) :代表集合本身 ,是接口。 -
Collections(复数) :代表集合的工具集 ,是工具类。
掌握 Collections 工具类可以极大地提升开发效率,避免重复造轮子。
三、Java中的Collection如何遍历迭代?⭐⭐⭐⭐
核心结论
主要有 4 种 遍历方式,其中 增强 for 循环 和 Iterator 是最常用的。
遍历方式详解
假设我们有一个集合进行演示:
java
java
List<String> list = Arrays.asList("A", "B", "C");1. 增强 for 循环 (最常用、最简洁)
java
java
for (String element : list) {
    System.out.println(element);
}-
优点:语法简洁,不易出错。
-
缺点 :不能在进行过程中删除元素 (会抛出
ConcurrentModificationException)。 -
场景:绝大多数只需读取元素的场景。
2. 迭代器 (Iterator) - 安全删除元素的方式
java
java
Iterator<String> iterator = list.iterator();
while (iterator.hasNext()) {
    String element = iterator.next();
    if ("B".equals(element)) {
        iterator.remove(); // ✅ 安全删除当前元素
    }
    System.out.println(element);
}-
优点 :可以在遍历中安全地删除元素 (使用
iterator.remove())。 -
场景:需要在遍历过程中删除元素的场景。
3. 普通 for 循环 (仅适用于 List)
java
java
for (int i = 0; i < list.size(); i++) {
    String element = list.get(i); // List 有索引,Set 没有此方法
    System.out.println(element);
}-
优点 :可以通过索引随机访问元素。
-
缺点 :仅适用于
List接口的实现(如ArrayList),不适用于Set(如HashSet没有get(i)方法)。对于LinkedList,性能较差(每次get(i)都是 O(n) 操作)。
4. forEach() 方法 (Java 8+,函数式风格)
java
java
// 方式1:Lambda 表达式
list.forEach(element -> System.out.println(element));

// 方式2:方法引用
list.forEach(System.out::println);-
优点:代码简洁,函数式风格。
-
缺点 :同样不能在遍历中删除元素,否则会抛出异常。
遍历过程中的删除操作对比
这是一个关键区别,务必牢记:
| 遍历方式 | 能否在遍历中删除元素? | 正确删除方法 |
|---|---|---|
| 增强 for 循环 | ❌ 不能 | 无。尝试删除会抛 ConcurrentModificationException |
| 迭代器 (Iterator) | ✅ 能 | iterator.remove() |
| 普通 for 循环 | ⚠️ 小心使用 | list.remove(i),但需注意索引变化,通常建议倒序遍历删除 |
| forEach() | ❌ 不能 | 无。尝试删除会抛 ConcurrentModificationException |
安全删除示例(倒序遍历):
java
java
List<String> list = new ArrayList<>(Arrays.asList("A", "B", "C", "D"));
// 要删除 "B" 和 "C"
for (int i = list.size() - 1; i >= 0; i--) { // 倒序!
    if ("B".equals(list.get(i)) || "C".equals(list.get(i))) {
        list.remove(i); // 从后往前删,索引不会错乱
    }
}
// 结果: [A, D]
总结与选择建议
| 场景 | 推荐方式 |
|---|---|
| 日常简单遍历 | 增强 for 循环 (最简洁) |
| 需要删除元素 | 迭代器 (Iterator) 和 iterator.remove() |
| 需要索引信息 | 普通 for 循环 (仅用于 List) |
| 函数式编程 | forEach() + Lambda |
最佳实践:
-
大多数情况用 增强 for 循环。
-
要安全删除元素,请使用 Iterator。
-
记住哪些方式会抛
ConcurrentModificationException。
四、你能说出几种集合的排序方式?⭐⭐⭐⭐
三种核心排序方式:
1. 实现Comparable接口(自然排序)
-
方式 :让实体类实现
Comparable<T>接口,重写compareTo方法 -
特点:定义对象的默认比较规则
-
使用场景:对象有固定的自然排序规则时
java
java
// 实体类实现Comparable
public class Student implements Comparable<Student> {
    @Override
    public int compareTo(Student o) {
        int flag = this.name.compareTo(o.name);
        if(flag == 0) flag = this.age - o.age;
        return flag;
    }
}
// 使用
Collections.sort(students);
2. 使用Comparator比较器(定制排序)
-
方式:创建Comparator实例,定义比较逻辑
-
特点:灵活,可定义多种排序规则,不修改原类
-
使用场景:需要多种排序方式或无法修改原类时
java
java
// 传统写法
Collections.sort(students, (o1, o2) -> {
    int flag = o1.getName().compareTo(o2.getName());
    if(flag == 0) flag = o1.getAge() - o2.getAge();
    return flag;
});

// Java 8+ 优雅写法(推荐)
Collections.sort(students,
    Comparator.comparing(Student::getName)
              .thenComparingInt(Student::getAge));
3. 使用Stream API(函数式排序)
-
方式 :通过Stream的
sorted方法进行排序 -
特点:不改变原集合,返回新集合,支持链式操作
-
使用场景:函数式编程风格,需要保持原集合不变时
java
java
// 如果Student实现了Comparable
List<Student> sorted = students.stream()
                              .sorted()
                              .collect(Collectors.toList());

// 自定义比较器
List<Student> sorted = students.stream()
                              .sorted(Comparator.comparing(Student::getName)
                                                .thenComparingInt(Student::getAge))
                              .collect(Collectors.toList());
对比总结:
| 方式 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| Comparable | 定义默认排序规则,使用简单 | 只能定义一种排序规则 | 对象有自然顺序时 |
| Comparator | 灵活,支持多种排序规则 | 需要额外创建比较器 | 需要多种排序方式时 |
| Stream API | 函数式风格,不修改原集合 | 性能稍有开销 | 现代Java开发,链式操作 |
最佳实践:
-
优先使用
Comparator.comparing().thenComparing()链式语法,代码更简洁 -
如果需要默认排序,实现
Comparable;如果需要多种排序,使用Comparator -
Stream API适合处理数据流水线操作
五、什么是fail-fast?什么是fail-safe?⭐⭐⭐⭐⭐
核心结论
-
fail-fast (快速失败) :发现并发修改时,立即抛出异常,避免数据不一致。
-
fail-safe (安全失败) :允许并发修改,通过复制数据 或弱一致性保证遍历不中断。
详细对比
| 特性 | fail-fast (快速失败) | fail-safe (安全失败) |
|---|---|---|
| 机制 | 遍历时直接操作原始集合 | 遍历时基于原集合的副本 或快照 |
| 并发修改 | 立即抛出 ConcurrentModificationException |
允许,不会抛出异常 |
| 一致性 | 强一致性,期望遍历期间集合不变 | 弱一致性,遍历不反映遍历后的修改 |
| 性能 | 无复制开销 | 有复制开销,占用额外内存 |
| 实现类 | ArrayList, HashMap, Vector (非并发集合) |
CopyOnWriteArrayList, ConcurrentHashMap (JUC并发集合) |
代码示例与原理分析
1. fail-fast 机制
触发场景:在使用迭代器遍历时,如果集合被直接修改(非通过迭代器自身的方法)。
java
java
public class FailFastExample {
    public static void main(String[] args) {
        List<String> list = new ArrayList<>();
        list.add("A");
        list.add("B");
        list.add("C");

        Iterator<String> iterator = list.iterator();
        while (iterator.hasNext()) {
            String element = iterator.next();
            System.out.println(element);

            if ("B".equals(element)) {
                list.remove("B"); // ❌ 直接修改原集合,在下一轮 next() 调用时抛出异常
                // list.add("D"); // 同样会抛出异常
            }
        }
    }
}
// 输出:
// A
// B
// Exception in thread "main" java.util.ConcurrentModificationException
原理 :
集合内部维护一个 modCount(修改计数器)。当创建迭代器时,会记录当前的 modCount 为 expectedModCount。每次调用迭代器的 next()、remove() 等方法时,都会检查 modCount == expectedModCount,如果不相等,说明集合在遍历期间被外部修改,立即抛出 ConcurrentModificationException。
2. fail-safe 机制
实现方式:在遍历时创建集合副本,或使用支持并发修改的数据结构。
示例1:CopyOnWriteArrayList
java
java
public static void main(String[] args) {
    List<String> userNames = new CopyOnWriteArrayList<String>() {{
        add("1");
        add("2");
        add("3");
        add("4");
    }};

    Iterator it = userNames.iterator();

    for (String userName : userNames) {
        if (userName.equals("2")) {
            userNames.remove(userName);
        }
    }

    System.out.println(userNames);

    while(it.hasNext()){
        System.out.println(it.next());
    }
    // 输出结果: 1 2 3 4

    System.out.println("----------------------");
    Iterator it2 = userNames.iterator();
    while(it2.hasNext()){
        System.out.println(it2.next());
    }
    // 输出结果: 1   3 4
}
原理 :以上代码,使用CopyOnWriteArrayList代替了ArrayList,就不会发生异常。fail-safe集合的所有对集合的修改都是先拷贝一份副本,然后在副本集合上进行的,并不是直接对原集合进行修改。并且这些修改方法,如add/remove都是通过加锁来控制并发的。所以,CopyOnWriteArrayList中的迭代器在迭代的过程中不需要做fail-fast的并发检测。(因为fail-fast的主要目的就是识别并发,然后通过异常的方式通知用户)但是,虽然基于拷贝内容的优点是避免了ConcurrentModificationException,但同样地,迭代器并不能访问到修改后的内容。如以下代码:
迭代器遍历的是开始遍历那一刻拿到的集合拷贝,在遍历期间原集合发生的修改迭代器是不知道的。
示例2:ConcurrentHashMap
java
java
public class FailSafeExample2 {
    public static void main(String[] args) {
        Map<String, Integer> map = new ConcurrentHashMap<>();
        map.put("A", 1);
        map.put("B", 2);
        map.put("C", 3);

        Iterator<String> iterator = map.keySet().iterator();
        while (iterator.hasNext()) {
            String key = iterator.next();
            System.out.println(key + "=" + map.get(key));

            if ("B".equals(key)) {
                map.remove("B"); // ✅ 允许并发修改
                map.put("D", 4);
            }
        }
    }
}
// 输出可能为(由于弱一致性,顺序和内容可能不同):
// A=1
// B=2
// C=3
// D=4
原理 :ConcurrentHashMap 使用分段锁或 CAS 操作,支持高并发。它的迭代器是弱一致性的,可能反映也可能不反映迭代过程中的修改,但保证不会抛出异常。
总结与选择
| 场景 | 推荐选择 | 原因 |
|---|---|---|
| 单线程环境 | ArrayList, HashMap (fail-fast) |
性能好,及早发现编程错误 |
| 高并发读,少写 | CopyOnWriteArrayList |
读操作无锁,性能极高 |
| 高并发读写 | ConcurrentHashMap |
读写性能平衡,线程安全 |
| 需要强一致性 | 使用锁同步 + fail-fast 集合 | 保证数据实时一致性 |
核心记忆点:
-
fail-fast → "发现问题立马崩溃",用于快速定位并发错误。
-
fail-safe → "你改你的,我遍历我的",用于需要高可用性的并发场景。
六、遍历的同时修改一个List有几种方式?⭐⭐⭐⭐
核心结论
安全的方式只有两种:
-
使用 迭代器(Iterator) 自身的
remove方法。 -
使用
CopyOnWriteArrayList。
其他方式(如普通的 for 循环)需要非常小心,否则极易出错。
方式对比与代码示例
假设我们有一个需求:遍历一个 List,删除其中的 "B" 元素。
1. 使用 Iterator 的 remove() 方法(推荐⭐)
这是 最标准、最安全 的方式。
java
java
List<String> list = new ArrayList<>(Arrays.asList("A", "B", "C", "D"));
Iterator<String> iterator = list.iterator();

while (iterator.hasNext()) {
    String item = iterator.next();
    if ("B".equals(item)) {
        iterator.remove(); // ✅ 关键:使用迭代器自己的 remove 方法
    }
}
System.out.println(list); // 输出: [A, C, D]-
优点:绝对安全,专为遍历时删除设计。
-
原理 :
iterator.remove()会在删除元素后同步内部的modCount和expectedModCount,避免抛出ConcurrentModificationException。
2. 使用 for 循环 + 索引(小心使用⚠️)
通过索引倒序遍历可以安全删除,但正序遍历会出问题。
✅ 正确做法(倒序删除):
java
java
List<String> list = new ArrayList<>(Arrays.asList("A", "B", "C", "D"));

for (int i = list.size() - 1; i >= 0; i--) { // 从后往前
    if ("B".equals(list.get(i))) {
        list.remove(i); // 删除后,前面的元素索引不会变
    }
}
System.out.println(list); // 输出: [A, C, D]
❌ 错误做法(正序删除):
java
java
List<String> list = new ArrayList<>(Arrays.asList("A", "B", "C", "D"));

for (int i = 0; i < list.size(); i++) {
    if ("B".equals(list.get(i))) {
        list.remove(i); // 删除后,后面所有元素的索引都减1,会导致漏检或越界
        // i--; // 如果非要正序,删除后必须 i--,但不推荐,容易忘记
    }
}
// 可能产生非预期结果
3. 使用 CopyOnWriteArrayList(并发场景推荐⭐)
这是 fail-safe 的集合,特别适合读多写少的并发场景。
java
java
List<String> list = new CopyOnWriteArrayList<>(Arrays.asList("A", "B", "C", "D"));

// 在增强 for 循环或 Iterator 中都可以安全删除
for (String item : list) {
    if ("B".equals(item)) {
        list.remove(item); // ✅ 安全,不会抛异常
    }
}
System.out.println(list); // 输出: [A, C, D]-
优点:遍历和修改完全互不干扰,绝对安全。
-
缺点 :每次修改(add/remove)都会复制整个底层数组 ,性能开销大。迭代器遍历的是创建时的快照,看不到遍历过程中发生的修改。
4. 使用 removeIf() 方法(Java 8+ 最简洁⭐)
这是 最现代、最简洁 的方式,底层也是通过 Iterator 实现。
java
java
List<String> list = new ArrayList<>(Arrays.asList("A", "B", "C", "D"));

list.removeIf(item -> "B".equals(item)); // ✅ 一行代码搞定
System.out.println(list); // 输出: [A, C, D]-
优点:代码极其简洁,内部已优化,安全高效。
-
场景 :这是条件删除的首选方式。
总结与决策指南
| 方式 | 安全性 | 特点 | 适用场景 |
|---|---|---|---|
Iterator.remove() |
✅ 安全 | 标准做法,可控性强 | 需要在遍历中进行复杂逻辑判断后删除 |
removeIf() |
✅ 安全 | 代码最简洁 | Java 8+, 条件删除(首选) |
CopyOnWriteArrayList |
✅ 安全 | 并发安全,读写分离 | 多线程 环境,且读多写少 |
| for循环倒序 | ⚠️ 需谨慎 | 性能好,但易出错 | 确定要倒序且单线程的场景 |
| 增强for循环直接删 | ❌ 不安全 | 抛出ConcurrentModificationException |
禁止使用 |
最佳实践建议:
-
单线程条件删除 → 优先使用
list.removeIf(Predicate)。 -
单线程遍历中复杂操作 → 使用
Iterator遍历和删除。 -
多线程环境 → 使用
CopyOnWriteArrayList。 -
绝对避免 :在增强 for 循环 中直接调用
list.remove()。
七、Set是如何保证元素不重复的⭐⭐⭐⭐
一、两大实现类的核心机制
1. HashSet(哈希表实现)
-
数据结构:基于 HashMap 实现,使用哈希表存储数据
-
排序特性:数据无序,允许放入一个 null 值
-
重复判断机制:
-
首先计算元素的 hashCode 值
-
通过哈希运算确定存储位置
-
如果位置为空,直接存入
-
如果位置不为空,用 equals 方法比较元素是否相等
-
相等则不添加,不等则寻找空位添加
-
2. TreeSet(红黑树实现)
-
数据结构:基于 TreeMap 实现,使用红黑树(平衡二叉查找树)
-
排序特性:数据自动排序,不允许放入 null 值
-
重复判断机制:
-
元素必须实现 Comparable 接口
-
插入时调用 compareTo() 方法进行比较
-
如果 compareTo() 返回 0,视为重复元素,不予添加
-
二、关键技术对比
| 特性 | HashSet | TreeSet |
|---|---|---|
| 底层实现 | HashMap | TreeMap |
| 数据结构 | 哈希表 | 红黑树 |
| 排序方式 | 无序 | 自动排序 |
| Null值 | 允许一个null | 不允许null |
| 重复判断 | hashCode() + equals() | compareTo() |
| 性能 | O(1) 平均时间复杂度 | O(log n) 时间复杂度 |
三、总结
Set 通过不同的数据结构和技术手段保证元素唯一性:
-
HashSet 依赖 hashCode() 和 equals() 方法,通过哈希算法快速定位和精确比较
-
TreeSet 依赖 Comparable 接口和 compareTo() 方法,利用红黑树的排序特性去重
两者都遵循"唯一约束"原则,如同数据库中的唯一索引,确保集合中不会存在重复元素,只是实现的技术路径不同。
八、ArrayList、LinkedList与Vector的区别?⭐⭐⭐⭐⭐
核心结论
-
ArrayList:查询快,增删慢 的动态数组。线程不安全,但性能高。 -
LinkedList:增删快,查询慢 的双向链表。线程不安全。 -
Vector:一个古老的、线程安全 但性能低下的动态数组。
在现代开发中,Vector 基本已被弃用。
详细对比
| 特性 | ArrayList | LinkedList | Vector |
|---|---|---|---|
| 底层数据结构 | 动态数组 | 双向链表 | 动态数组 |
| 线程安全 | 否 | 否 | 是 (使用 synchronized 实现) |
| 性能特点 | 查询快 (O(1)) 增删慢 (O(n)) | 增删快 (O(1)) 查询慢 (O(n)) | 查询快 (O(1)) 增删慢 (O(n)) 整体性能最低 |
| 扩容机制 | 增长 50% (如: 10 -> 15) | 无扩容概念 | 增长 100% (如: 10 -> 20) |
| 内存占用 | 较小 (仅存储数据) | 较大 (额外存储前后节点的引用) | 与 ArrayList 类似 |
| 适用场景 | 大量随机访问 (如:根据索引查询) | 频繁的插入/删除 (如:队列、栈) | 遗留系统 需要线程安全 (但已被 CopyOnWriteArrayList 取代) |
原理与代码示例
1. ArrayList - 动态数组
原理 :底层是一个 Object[] elementData。查询通过索引直接定位,速度极快;但插入或删除需要移动后续所有元素。
java
java
// 查询极快 - O(1)
ArrayList<String> list = new ArrayList<>();
list.add("A");
list.add("B");
list.add("C");
String element = list.get(1); // 直接通过数组索引访问 elementData[1]

// 插入/删除较慢 - O(n)
list.add(1, "X"); // 插入,需要将 B、C 向后移动
list.remove(1);   // 删除,需要将 C 向前移动
2. LinkedList - 双向链表
原理 :由一系列节点 (Node<E>) 组成,每个节点包含数据、前驱和后继指针。插入/删除只需修改指针,但查询需要从头遍历。
java
java
// 插入/删除极快 (如果在头尾) - O(1)
LinkedList<String> list = new LinkedList<>();
list.add("A");
list.add("B");
list.add("C");

list.addFirst("X"); // 在头部插入,极快
list.removeLast();  // 在尾部删除,极快

// 查询较慢 - O(n)
String element = list.get(2); // 需要从头部开始,遍历两个节点
3. Vector - 线程安全的动态数组
原理 :与 ArrayList 类似,但所有公共方法都加了 synchronized 关键字以保证线程安全,这导致了巨大的性能开销。
java
java
Vector<String> vector = new Vector<>();
vector.add("A"); // 方法内部有 synchronized 锁
vector.get(0);   // 方法内部有 synchronized 锁
如何选择?
| 场景 | 推荐选择 | 理由 |
|---|---|---|
| 频繁按索引搜索 | ArrayList |
数组结构支持随机访问,时间复杂度 O(1) |
| 频繁在头/尾增删 | LinkedList |
链表结构修改指针即可,时间复杂度 O(1) |
| 多线程环境 | CopyOnWriteArrayList |
现代、高效的线程安全 List,取代 Vector |
| 实现栈/队列 | LinkedList |
天然支持头尾操作,实现了 Deque 接口 |
总结与记忆
-
ArrayList像 "电影院座位":找座位(查询)快,但中间来人(插入)麻烦。 -
LinkedList像 "火车车厢":挂接新车厢(插入)方便,但找第 N 节车厢(查询)得一节节数。 -
Vector像 "带锁的 ArrayList":安全但笨重,已被更先进的并发集合取代。
一句话总结:单线程用 ArrayList,多线程用 CopyOnWriteArrayList,需要频繁在两端操作用 LinkedList,忘记 Vector。
九、ArrayList的subList方法有什么需要注意的地方吗?⭐⭐⭐
核心结论
subList 返回的是原始列表的一个"视图",而非独立的新列表。对子列表或原始列表的结构性修改会相互影响,可能导致未预期的结果或直接抛出异常。
主要注意事项与代码示例
1. 非独立性:子列表是原始列表的"窗口"
java
java
ArrayList<String> originalList = new ArrayList<>(Arrays.asList("A", "B", "C", "D", "E"));
List<String> subList = originalList.subList(1, 4); // 获取 [B, C, D]

System.out.println("原始列表: " + originalList); // [A, B, C, D, E]
System.out.println("子列表: " + subList);       // [B, C, D]

// 修改子列表会影响原始列表
subList.set(0, "B-REPLACED");
System.out.println("修改子列表后:");
System.out.println("原始列表: " + originalList); // [A, B-REPLACED, C, D, E] ❗被影响了
System.out.println("子列表: " + subList);       // [B-REPLACED, C, D]

// 修改原始列表也会影响子列表(可能导致不可预测行为)
originalList.add(2, "NEW-ELEMENT"); // 在索引2处插入元素
// 现在再访问 subList 可能会抛出异常或得到错误数据
// System.out.println(subList.get(0)); // 可能抛出 ConcurrentModificationException
2. 结构性修改的相互影响与异常
结构性修改 (改变大小的操作,如 add, remove)会相互影响,并且在某些状态下会抛出 ConcurrentModificationException。
java
java
ArrayList<Integer> original = new ArrayList<>(Arrays.asList(1, 2, 3, 4, 5));
List<Integer> sub = original.subList(1, 3); // [2, 3]

// 通过子列表进行结构性修改
sub.add(99); // 在子列表末尾添加,相当于在原始列表索引3处插入
System.out.println("子列表添加后 - 原始列表: " + original); // [1, 2, 3, 99, 4, 5]

// 先修改原始列表,再操作子列表 → 危险!
original.add(0, 0); // 在头部插入,改变了整个列表的结构
System.out.println("原始列表修改后: " + original); // [0, 1, 2, 3, 99, 4, 5]

// 现在任何对子列表的操作都可能抛出异常
try {
    System.out.println(sub.get(0));
} catch (ConcurrentModificationException e) {
    System.out.println("捕获到 ConcurrentModificationException!");
}
3. 不支持序列化
subList 返回的列表通常不支持序列化 。如果你需要序列化一个子列表,必须先将其转换为一个独立的 ArrayList。
java
java
ArrayList<String> original = new ArrayList<>(Arrays.asList("A", "B", "C"));
List<String> sub = original.subList(0, 2);

// 如果需要序列化 sub,应该这样做:
List<String> serializableSubList = new ArrayList<>(original.subList(0, 2));
最佳实践与解决方案
✅ 正确用法:短期只读视图
java
java
// 如果只是短期读取,不修改,这是安全的
ArrayList<String> list = new ArrayList<>(...);
List<String> view = list.subList(1, 4);
for (String item : view) {
    System.out.println(item); // 安全的只读操作
}
// 尽快用完,避免在 view 存在期间修改原始 list
✅ 正确用法:创建独立的副本
如果你需要一个完全独立的、与原始列表无关的子列表:
java
java
ArrayList<String> original = new ArrayList<>(Arrays.asList("A", "B", "C", "D"));

// 方法1:使用构造函数(推荐)
List<String> independentSubList1 = new ArrayList<>(original.subList(1, 3));

// 方法2:使用 Stream API (Java 8+)
List<String> independentSubList2 = original.stream()
                                          .skip(1)
                                          .limit(2)
                                          .collect(Collectors.toList());

// 方法3:使用 Apache Commons Collections (如已引入)
// List<String> independentSubList3 = ListUtils.emptyIfNull(original).subList(1, 3);

// 现在修改 independentSubList 不会影响 original
independentSubList1.add("X");
System.out.println(original); // [A, B, C, D] (未受影响)
System.out.println(independentSubList1); // [B, C, X]
总结
| 操作 | 结果 | 建议 |
|---|---|---|
修改子列表元素 (set) |
影响原始列表 | 明确知晓后果时使用 |
修改子列表结构 (add/remove) |
影响原始列表 | 明确知晓后果时使用 |
| 修改原始列表结构 | 可能使子列表失效,抛出异常 | 绝对避免 |
| 将子列表用于序列化 | 不支持 | 先转换为 new ArrayList<>(subList) |
| 需要独立子列表 | 创建副本 | new ArrayList<>(original.subList(...)) |
一句话总结:把 subList 当作一个临时的、非独立的"视图"来使用。如果需要独立的子列表,务必创建副本。
十、ArrayList的序列化是怎么实现的?⭐⭐⭐⭐
核心结论
ArrayList 为了优化存储和性能,没有使用 Java 默认的序列化机制 ,而是通过自定义 writeObject 和 readObject 方法,只序列化实际包含元素的数组部分 ,而不会序列化整个底层数组 (elementData)。
为什么要自定义序列化?
ArrayList 的底层是一个 Object[] elementData 数组。为了提供动态扩容的能力,这个数组的长度(capacity)通常大于当前集合的实际元素数量(size)。
例如:一个 ArrayList 的 size 是 5,但 elementData 数组的长度可能是 10。
如果使用默认序列化,会序列化整个长度为 10 的数组,其中后 5 个是 null。这会造成:
-
空间浪费:序列化后的数据大小远大于实际需要。
-
时间浪费 :传输和序列化/反序列化这些
null值带来不必要的开销。
源码分析
1. 序列化过程 (writeObject)
ArrayList 实现了 writeObject 方法,它只序列化有用的数据。
java
java
// ArrayList 的 writeObject 方法 (概念简化版)
private void writeObject(java.io.ObjectOutputStream s)
    throws java.io.IOException {
    // 1. 写出默认的序列化头信息和非transient字段(例如 size)
    s.defaultWriteObject();

    // 2. 写出数组的当前容量(为了反序列化时优化)
    s.writeInt(elementData.length);

    // 3. 【关键】只写出 size 个有效元素,而不是整个 elementData 数组
    for (int i = 0; i < size; i++) {
        s.writeObject(elementData[i]);
    }
}
2. 反序列化过程 (readObject)
反序列化时,ArrayList 根据序列化信息重建一个大小刚好的数组。
java
java
// ArrayList 的 readObject 方法 (概念简化版)
private void readObject(java.io.ObjectInputStream s)
    throws java.io.IOException, ClassNotFoundException {
    // 1. 读入默认的序列化头信息和非transient字段(例如 size)
    s.defaultReadObject();

    // 2. 读入数组的容量
    int capacity = s.readInt();

    // 3. 检查容量是否合理,然后创建一个大小合适的数组
    if (capacity < size) {
        throw new InvalidObjectException("Capacity cannot be less than size");
    }

    // 根据 size 创建一个"刚好"的数组,避免浪费
    // 如果 capacity 接近 size,就直接用 capacity
    Object[] a = elementData = new Object[capacity];

    // 4. 【关键】从流中逐个读入对象,填充数组
    for (int i = 0; i < size; i++) {
        a[i] = s.readObject();
    }
}关键设计:transient 关键字
如果你查看 ArrayList 的源码,会发现存储数据的核心数组被 transient 修饰:
java
java
public class ArrayList<E> extends AbstractList<E>
    implements List<E>, RandomAccess, Cloneable, java.io.Serializable
{
    // 这个数组不会被默认的序列化机制处理!
    transient Object[] elementData;

    // 实际元素的数量
    private int size;

    // ... 自定义的 writeObject 和 readObject 方法
}-
transient关键字的作用是:阻止该字段被默认的序列化机制序列化。 -
这正是
ArrayList能够"偷梁换柱",实现自定义序列化的基础。它告诉 JVM:"别管这个字段,我自己来处理它的序列化。"
代码示例:验证序列化效果
java
java
import java.io.*;
import java.util.ArrayList;
import java.util.Arrays;

public class ArrayListSerializationDemo {
    public static void main(String[] args) throws Exception {
        ArrayList<String> originalList = new ArrayList<>();
        originalList.add("A");
        originalList.add("B");
        originalList.add("C");

        // 此时 elementData 的长度可能为 10 (默认容量),但 size 是 3

        // 序列化到字节数组
        ByteArrayOutputStream baos = new ByteArrayOutputStream();
        ObjectOutputStream oos = new ObjectOutputStream(baos);
        oos.writeObject(originalList);
        oos.close();

        byte[] serializedData = baos.toByteArray();
        System.out.println("序列化后的数据大小: " + serializedData.length + " 字节");
        // 这个大小只与 "A", "B", "C" 这三个元素有关,与底层数组的容量无关。

        // 反序列化
        ByteArrayInputStream bais = new ByteArrayInputStream(serializedData);
        ObjectInputStream ois = new ObjectInputStream(bais);
        ArrayList<String> deserializedList = (ArrayList<String>) ois.readObject();

        System.out.println("反序列化后的列表: " + deserializedList); // [A, B, C]
        // 反序列化后的 ArrayList 的 elementData 长度很可能就是 3,非常紧凑。
    }
}
总结
| 方面 | ArrayList 的序列化策略 |
|---|---|
| 核心机制 | 自定义 writeObject / readObject,绕过默认机制 |
| 关键字段 | transient Object[] elementData (拒绝默认序列化) |
| 序列化内容 | 只写出有效元素 (size 个),而非整个数组 |
| 优化目标 | 节省空间和提高效率 ,避免序列化 null 值 |
| 反序列化结果 | 得到一个容量与元素数量匹配 的高效 ArrayList |
这种设计体现了 Java 集合框架在性能优化上的深思熟虑,既保证了功能的正确性,又最大限度地提升了效率。
十一、hash冲突通常怎么解决?⭐⭐⭐⭐
哈希冲突主要解决方案
1. 链地址法
-
方法:将哈希到同一位置的所有元素存储在同一个链表中
-
特点:最常用,Java HashMap 采用
-
优化:链表过长时转为红黑树(Java 8+)
2. 开放定址法
-
方法:冲突时寻找下一个空槽位
-
探测方式:
-
线性探测:顺序查找
-
平方探测:避免聚集
-
双重哈希:使用第二个哈希函数
-
3. 再哈希法
-
方法:使用第二个哈希函数重新计算位置
-
特点:冲突分布更均匀
4. 建立公共溢出区
- 方法:冲突元素统一放入独立溢出区
实际应用
-
Java HashMap:链地址法 + 红黑树优化
-
Python Dict:开放定址法
-
推荐 :链地址法最实用稳定,适合大多数场景
十二、HashMap的数据结构是怎样的?⭐⭐⭐⭐⭐
HashMap 数据结构总结
核心结构演进
-
JDK 1.8 之前 :数组 + 链表
-
JDK 1.8 之后 :数组 + 链表 + 红黑树
各组件作用
1. 数组(主干)
-
作为哈希表的主体结构
-
每个数组元素称为一个"桶"(bucket)
-
提供 O(1) 时间复杂度的快速寻址能力
2. 链表(冲突解决)
-
解决哈希冲突(不同key映射到同一数组位置)
-
采用链地址法,将冲突元素以链表形式存储
-
提供相对高效的插入和删除操作
3. 红黑树(性能优化)
-
JDK 1.8 新增的优化结构
-
当链表长度超过阈值(默认8)时转换为红黑树
-
将最差情况下的时间复杂度从 O(n) 优化为 O(log n)
设计优势
-
数组优势:利用内存连续性,寻址容易
-
链表优势:动态扩容,插入删除容易
-
红黑树优势:防止哈希碰撞攻击,保证最坏情况性能
工作方式
通过哈希函数计算键的哈希值,确定数组位置:
-
无冲突:直接存储在数组位置
-
有冲突:以链表形式链接在同一位置
-
链表过长:转换为红黑树保持性能
这种复合结构在空间效率、常规性能和极端情况性能之间取得了最佳平衡。
十三、HashMap、Hashtable和ConcurrentHashMap的区别?⭐⭐⭐⭐⭐
核心结论
-
HashMap:线程不安全 ,但性能最高。 -
Hashtable:线程安全 ,但实现方式(全表锁)导致性能最差 ,已过时。 -
ConcurrentHashMap:线程安全 ,且通过分段锁(JDK 1.7)或 CAS + synchronized(JDK 1.8)实现了高并发性能。
在现代多线程开发中,需要线程安全的 Map 时,应首选 ConcurrentHashMap,完全避免使用 Hashtable。
详细对比
| 特性 | HashMap | Hashtable | ConcurrentHashMap |
|---|---|---|---|
| 线程安全 | 否 | 是 | 是 |
| 性能 | 最高 | 最低 | 很高(接近 HashMap) |
| 锁机制 | 无锁 | 全表锁(操作整个集合) | 分段锁 (JDK 1.7) 桶级别锁 (JDK 1.8:CAS + synchronized) |
| Null 键/值 | 允许一个 null 键,多个 null 值 | 不允许 | 不允许 |
| 迭代器 | Fail-Fast | Fail-Fast | Weakly Consistent(弱一致性) |
| 继承体系 | 继承 AbstractMap |
继承 Dictionary(已过时) |
继承 AbstractMap |
| 推荐场景 | 单线程环境 | 遗留系统(不应在新项目中使用) | 高并发多线程环境 |
原理深度解析
1. HashMap (线程不安全)
-
原理:数组 + 链表 + 红黑树(JDK 1.8+)。
-
问题 :多线程并发修改时,可能导致无限循环 (在扩容时)、数据丢失或
ConcurrentModificationException。
java
java
// 多线程下不安全的示例
Map<String, Integer> map = new HashMap<>();

// 线程A
new Thread(() -> {
    for (int i = 0; i < 1000; i++) {
        map.put("A" + i, i);
    }
}).start();

// 线程B
new Thread(() -> {
    for (int i = 0; i < 1000; i++) {
        map.put("B" + i, i);
    }
}).start();

// 可能导致数据不一致、死循环或运行时异常
2. Hashtable (线程安全但性能差)
-
原理 :在所有公共方法上添加
synchronized关键字,锁住整个对象实例。 -
问题 :锁粒度太粗,多个线程不能同时进行任何操作,严重制约性能。
java
java
// Hashtable 的 put 方法源码(简化)
public synchronized V put(K key, V value) {
    // ...
}

// 使用示例 - 线程安全但性能低下
Map<String, Integer> table = new Hashtable<>();
// 即使一个线程调用 put("A", 1),另一个线程调用 get("B") 也会被阻塞!
3. ConcurrentHashMap (线程安全且高性能)
JDK 1.7 实现:分段锁
-
原理 :将整个哈希表分成多个
Segment(段),每个段独立加锁。 -
效果 :不同段的操作可以并发执行,大大提升了吞吐量。
java
java
// 概念上的分段锁
public V put(K key, V value) {
    int segmentIndex = hash(key) & (SEGMENTS_COUNT - 1); // 计算属于哪个段
    Segment segment = segments[segmentIndex];
    segment.lock(); // 只锁住这个段,其他段仍然可访问
    try {
        // 在段内执行put操作
    } finally {
        segment.unlock();
    }
}
JDK 1.8 实现:CAS + synchronized(更优)
-
原理:
-
使用 CAS 进行无锁化快速尝试。
-
对单个桶(链表头/树根) 使用
synchronized加锁。
-
-
效果:锁粒度更细,并发度更高。
java
java
// JDK 1.8 ConcurrentHashMap.putVal 方法(简化概念)
final V putVal(K key, V value, boolean onlyIfAbsent) {
    // 1. 使用 CAS 尝试无锁化操作
    // 2. 如果桶为空,CAS 插入新节点
    // 3. 如果桶不为空,对桶的头节点加 synchronized 锁
    synchronized (bucketHead) {
        // 在链表或红黑树中插入/更新
    }
}
代码示例对比
java
java
public class MapComparison {
    public static void main(String[] args) throws InterruptedException {
        // 测试 HashMap (线程不安全)
        testMap(new HashMap<>(), "HashMap");

        // 测试 Hashtable (线程安全,但慢)
        testMap(new Hashtable<>(), "Hashtable");

        // 测试 ConcurrentHashMap (线程安全,且快)
        testMap(new ConcurrentHashMap<>(), "ConcurrentHashMap");
    }

    static void testMap(Map<String, Integer> map, String name) throws InterruptedException {
        long start = System.currentTimeMillis();

        Thread t1 = new Thread(() -> { for (int i = 0; i < 50000; i++) map.put("k" + i, i); });
        Thread t2 = new Thread(() -> { for (int i = 50000; i < 100000; i++) map.put("k" + i, i); });

        t1.start(); t2.start();
        t1.join(); t2.join();

        long end = System.currentTimeMillis();
        System.out.println(name + " 大小: " + map.size() + ", 耗时: " + (end - start) + "ms");
    }
}
// 可能的输出:
// HashMap 大小: 99998 (数据丢失!), 耗时: 50ms
// Hashtable 大小: 100000, 耗时: 150ms
// ConcurrentHashMap 大小: 100000, 耗时: 60ms
总结与选择指南
| 场景 | 推荐选择 | 理由 |
|---|---|---|
| 单线程应用 | HashMap |
性能最佳,无需线程安全开销 |
| 简单的多线程 | Collections.synchronizedMap(new HashMap()) |
简单的线程安全包装 |
| 高并发企业应用 | ConcurrentHashMap |
高吞吐量,真正的并发安全 |
| 兼容老系统 | Hashtable |
不应在新代码中使用 |
关键演进:
-
Hashtable→ 粗粒度锁,性能差 -
ConcurrentHashMap(JDK 1.7) → 分段锁,中等粒度 -
ConcurrentHashMap(JDK 1.8) → 桶级别锁,细粒度,性能接近HashMap
记住这个选择:要性能选 HashMap,要并发安全选 ConcurrentHashMap,永远不要选 Hashtable。
十四、HashMap在get和put时经过哪些步骤?⭐⭐⭐⭐
get方法
下面是JDK1.8中HashMap的get方法的简要实现过程:
-
计算哈希与定位
-
调用
key.hashCode()计算哈希码 -
通过扰动函数优化哈希分布
-
使用
(n-1) & hash计算数组索引
-
-
查找处理
-
桶为空 :直接返回
null -
桶不为空:遍历该位置的链表或红黑树
-
-
键值匹配
-
比较哈希值是否相等
-
比较 key 是否相等(
==或equals) -
找到匹配:返回对应的 value
-
未找到匹配:返回
null
-
java
final Node<K, V> getNode(int hash, Object key) {
    //当前HashMap的散列表的引用
    Node<K, V>[] tab;
    //first:桶头元素
    //e:用于存放临时元素
    Node<K, V> first, e;
    //n:table 数组的长度
    int n;
    //元素中的 k
    K k;
    // 将 table 赋值为 tab,不等于null 说明有数据,(n = tab.length) > 0 同理说明 table 中有数据
    //同时将 该位置的元素 赋值为 first
    if ((tab = table) != null && (n = tab.length) > 0 && (first = tab[(n - 1) & hash]) != null) {
        //定位到了桶的到的位置的元素就是想要获取的 key 对应的,直接返回该元素
        if (first.hash == hash && ((k = first.key) == key || (key != null && key.equals(k)))) {
            return first;
        }
        //到这一步说明定位到的元素不是想要的,且该位置不仅仅有一个元素,需要判断是链表还是树
        if ((e = first.next) != null) {
            //是否已经树化
            if (first instanceof TreeNode) {
                return ((TreeNode<K, V>) first).getTreeNode(hash, key);
            }
            //处理链表的情况
            do {
                //如果遍历到了就直接返回该元素
                if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) {
                    return e;
                }
            } while ((e = e.next) != null);
        }
    }
    //遍历不到返回null
    return null;
}
put方法
-
计算哈希与定位
-
调用
key.hashCode()计算哈希码 -
通过扰动函数优化哈希分布
-
使用
(n-1) & hash计算数组索引
-
-
处理桶位情况
-
桶为空:直接创建新节点放入
-
桶不为空:遍历该位置的链表或红黑树
-
-
键值对处理
-
Key已存在:更新value,返回旧值
-
Key不存在:插入新节点到链表或红黑树
-
-
结构优化检查
-
链表长度 ≥ 8 时转为红黑树
-
元素数量超过阈值时进行扩容
-
-
返回结果
-
键已存在:返回被替换的旧值
-
键不存在:返回null
-
java
/**
     * Implements Map.put and related methods.
     *
     * @param hash         key 的 hash 值
     * @param key          key 值
     * @param value        value 值
     * @param onlyIfAbsent true:如果某个 key 已经存在那么就不插了;false 存在则替换,没有则新增。这里为 false
     * @param evict        不用管了,我也不认识
     * @return previous value, or null if none
     */
final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
               boolean evict) {
    // tab 表示当前 hash 散列表的引用
    Node<K, V>[] tab;
    // 表示具体的散列表中的元素
    Node<K, V> p;
    // n:表示散列表数组的长度
    // i:表示路由寻址的结果
    int n, i;
    // 将 table 赋值发给 tab ;如果 tab == null,说明 table 还没有被初始化。则此时是需要去创建 table 的
    // 为什么这个时候才去创建散列表?因为可能创建了 HashMap 时候可能并没有存放数据,如果在初始化 HashMap 的时候就创建散列表,势必会造成空间的浪费
    // 这里也就是延迟初始化的逻辑
    if ((tab = table) == null || (n = tab.length) == 0) {
        n = (tab = resize()).length;
    }
    // 如果 p == null,说明寻址到的桶的位置没有元素。那么就将 key-value 封装到 Node 中,并放到寻址到的下标为 i 的位置
    if ((p = tab[i = (n - 1) & hash]) == null) {
        tab[i] = newNode(hash, key, value, null);
    }
        // 到这里说明 该位置已经有数据了,且此时可能是链表结构,也可能是树结构
    else {
        // e 表示找到了一个与当前要插入的key value 一致的元素
        Node<K, V> e;
        // 临时的 key
        K k;
        // p 的值就是上一步 if 中的结果即:此时的 (p = tab[i = (n - 1) & hash]) 不等于 null
        // p 是原来的已经在 i 位置的元素,且新插入的 key 是等于 p中的key
        //说明找到了和当前需要插入的元素相同的元素(其实就是需要替换而已)
        if (p.hash == hash && ((k = p.key) == key || (key != null && key.equals(k))))
            //将 p 的值赋值给 e
            e = p;
            //说明已经树化,红黑树会有单独的文章介绍,本文不再赘述
        else if (p instanceof TreeNode) {
            e = ((TreeNode<K, V>) p).putTreeVal(this, tab, hash, key, value);
        } else {
            //到这里说明不是树结构,也不相等,那说明不是同一个元素,那就是链表了
            for (int binCount = 0; ; ++binCount) {
                //如果 p.next == null 说明 p 是最后一个元素,说明,该元素在链表中也没有重复的,那么就需要添加到链表的尾部
                if ((e = p.next) == null) {
                    //直接将 key-value 封装到 Node 中并且添加到 p的后面
                    p.next = newNode(hash, key, value, null);
                    // 当元素已经是 7了,再来一个就是 8 个了,那么就需要进行树化
                    if (binCount >= TREEIFY_THRESHOLD - 1) {
                        treeifyBin(tab, hash);
                    }
                    break;
                }
                //在链表中找到了某个和当前元素一样的元素,即需要做替换操作了。
                if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) {
                    break;
                }
                //将e(即p.next)赋值为e,这就是为了继续遍历链表的下一个元素(没啥好说的)下面有张图帮助大家理解。
                p = e;
            }
        }
        //如果条件成立,说明找到了需要替换的数据,
        if (e != null) {
            //这里不就是使用新的值赋值为旧的值嘛
            V oldValue = e.value;
            if (!onlyIfAbsent || oldValue == null) {
                e.value = value;
            }
                //这个方法没用,里面啥也没有
                afterNodeAccess(e);
                //HashMap put 方法的返回值是原来位置的元素值
                return oldValue;
            }
        }
        // 上面说过,对于散列表的 结构修改次数,那么就修改 modCount 的次数
        ++modCount;
        //size 即散列表中的元素的个数,添加后需要自增,如果自增后的值大于扩容的阈值,那么就触发扩容操作
        if (++size > threshold) {
            resize();
        }
        //啥也没干
        afterNodeInsertion(evict);
        //原来位置没有值,那么就返回 null 呗
        return null;
    }
十五、为什么HashMap的Cap是2^n,如何保证?⭐
核心目的:性能优化
-
将取模运算
hash % n转换为位与运算hash & (n-1) -
位运算速度比取模运算快一个数量级
转换原理
-
当
n = 2^k时,n-1的二进制是00...011...1(k个1) -
hash & (n-1)等价于hash % n,且效率极高
如何保证
-
构造器转换 :通过
tableSizeFor(int cap)方法-
输入任意容量,返回 ≥ 该值的最小 2 的幂
-
例:输入10→返回16,输入17→返回32
-
-
扩容机制 :每次扩容
newCap = oldCap << 1- 保持容量始终为 2 的 n 次方
优势
-
计算极快:位运算替代取模
-
分布均匀:充分利用哈希值所有位
-
空间高效:避免无效桶位
十六、为什么HashMap的默认负载因子设置成0.75⭐⭐⭐
核心结论
HashMap 的默认负载因子设置为 0.75 ,是官方在经过大量测试和数学分析后,在时间成本(查询性能) 和空间成本(内存使用) 之间取得的一个经验上的最优平衡点。
什么是负载因子?
负载因子 = 元素数量 / 哈希表容量
-
作用:决定了 HashMap 在多少容量被使用时进行扩容。
-
示例 :容量为 16,负载因子 0.75,则当元素数量达到
16 * 0.75 = 12时,触发扩容。
为什么是 0.75?------ 两种极端情况的折衷
情况一:负载因子过小(例如 0.5)
-
优点:哈希冲突概率低,查询速度很快(链表短)。
-
缺点 :空间浪费严重,频繁扩容。
-
后果:内存利用率低,扩容操作本身也有性能开销。
就像一个能坐100人的会议室,只允许坐50人就锁门换地方,虽然不拥挤,但太浪费场地。
情况二:负载因子过大(例如 1.0)
-
优点:空间利用率高,直到满了才扩容。
-
缺点 :哈希冲突概率急剧增加,查询性能恶化(链表变得很长)。
-
后果:虽然减少了扩容次数,但大部分操作都退化为 O(n) 或 O(log n) 的链表/树遍历。
就像一个会议室硬塞了100人,虽然场地用满了,但进出、找人都非常困难。
0.75 的数学与统计学依据
这个值在统计学上有一个有力的支撑------泊松分布。
在 HashMap 的源码注释中明确提到,负载因子 0.75 时,桶中元素个数达到 8(即链表树化的阈值)的概率非常低(约 0.00000006)。这意味着:
-
在 0.75 的负载因子下,出现长链表(需要树化)的概率极小。
-
大部分桶中只有 0 个或 1 个元素,保证了 HashMap 能以 O(1) 的时间复杂度高效运行。
总结
| 负载因子 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| 小 (如 0.5) | 查询性能极高 | 内存浪费,扩容频繁 | 对查询速度要求极致,不计内存成本 |
| 0.75 (默认) | 时间与空间的完美平衡 | - | 通用场景 |
| 大 (如 1.0) | 内存利用率高 | 查询性能严重下降 | 对内存敏感,可接受性能损失 |
简单来说,0.75 就像一个"黄金分割点",它使得 HashMap 在保持较高查询性能的同时,又没有造成太大的内存浪费。 这是一个经过实践检验的、在绝大多数场景下都表现优异的经验值。如果你没有特别的性能需求,使用默认的 0.75 就是最佳选择。
十七、HashMap的容量设置多少合适?⭐⭐⭐
核心原则
在能够预估元素数量的情况下,通过构造函数设置合适的初始容量,避免或减少扩容操作,提升性能。
计算公式
java
初始容量 = (预计存储的元素个数 / 负载因子) + 缓冲值-
负载因子 :默认
0.75 -
缓冲值 :建议加
1到10,为意外添加的元素预留空间
快速估算(负载因子0.75)
java
初始容量 ≈ 预计元素个数 × 1.34常用场景推荐值
| 预计存储元素个数 | 推荐的初始容量 |
|---|---|
| 10 | 14 |
| 50 | 67 |
| 100 | 134 |
| 1000 | 1334 |
实际应用示例
java
// 已知要存储100个元素
Map<String, Object> optimalMap = new HashMap<>(134);
重要说明
-
核心目的 :避免达到 容量 × 负载因子 的扩容阈值,从而避免耗时的扩容(
resize)和数据迁移(rehash)操作。 -
无法预估时 :若完全无法预估元素数量,使用无参构造函数
new HashMap<>()即可。 -
内存敏感场景 :可适当调高负载因子(如
0.9),以空间换时间。
十八、HashMap是如何扩容的?⭐⭐⭐
核心结论
当 HashMap 中的元素数量超过 【当前容量 × 负载因子】 这个阈值时,就会触发扩容。扩容会创建一个容量为原来2倍 的新数组,然后将所有键值对重新计算哈希值并迁移到新数组中。这是一个相对耗时的操作。
详细扩容流程
1. 触发条件
java
java
// 在putVal方法中,添加元素后会检查
if (++size > threshold) { // threshold = capacity * loadFactor
    resize(); // 触发扩容
}- 默认情况 :容量16,负载因子0.75,当元素数量达到 12 时触发扩容。
2. 扩容核心方法 resize()
扩容过程主要包含以下步骤:
步骤一:计算新容量和新阈值
java
java
final Node<K,V>[] resize() {
    // 1. 计算新容量(旧容量的2倍)
    newCap = oldCap << 1;
    // 2. 计算新阈值(旧阈值的2倍)
    newThr = oldThr << 1;
}
步骤二:创建新数组
java
java
// 创建新的Node数组,容量是原来的2倍
Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap];
table = newTab; // 将内部table引用指向新数组
步骤三:迁移数据(最核心、最耗时的部分)
JDK 1.8 对数据迁移进行了优化,不再简单地重新计算每个元素的哈希值,而是通过巧妙的位运算来重新分配位置。
java
java
// 遍历旧数组的每个桶
for (int j = 0; j < oldCap; ++j) {
    Node<K,V> e;
    if ((e = oldTab[j]) != null) {
        oldTab[j] = null; // 清空旧桶,帮助GC

        if (e.next == null) {
            // 情况1:桶中只有一个元素
            // 直接计算在新数组中的位置
            newTab[e.hash & (newCap - 1)] = e;
        }
        else if (e instanceof TreeNode) {
            // 情况2:桶中是红黑树
            ((TreeNode<K,V>)e).split(this, newTab, j, oldCap);
        }
        else {
            // 情况3:桶中是链表(JDK 1.8 的优化重点)
            // 使用"高低位"链表来优化迁移
            Node<K,V> loHead = null, loTail = null; // 低位链表
            Node<K,V> hiHead = null, hiTail = null; // 高位链表

            do {
                Node<K,V> next = e.next;
                // 关键判断:判断元素应该留在原位置还是移动到新位置
                if ((e.hash & oldCap) == 0) {
                    // 留在原位置(低位)
                    if (loTail == null)
                        loHead = e;
                    else
                        loTail.next = e;
                    loTail = e;
                }
                else {
                    // 移动到新位置(高位 = 原位置 + 旧容量)
                    if (hiTail == null)
                        hiHead = e;
                    else
                        hiTail.next = e;
                    hiTail = e;
                }
            } while ((e = next) != null);

            // 将高低位链表放入新数组
            if (loTail != null) {
                loTail.next = null;
                newTab[j] = loHead; // 低位链表:原索引位置
            }
            if (hiTail != null) {
                hiTail.next = null;
                newTab[j + oldCap] = hiHead; // 高位链表:原索引 + 旧容量
            }
        }
    }
}
JDK 1.8 扩容优化详解
优化原理:(e.hash & oldCap) == 0
由于容量总是 2 的 n 次方,扩容时的新容量 newCap = oldCap << 1(相当于在二进制表示后面加一个 0)。
关键洞察 :元素在新数组中的位置要么保持不变,要么是原位置 + 旧容量。
示例:
java
java
// 假设旧容量 oldCap = 16 (10000b), oldCap-1 = 15 (01111b)
// 新容量 newCap = 32 (100000b), newCap-1 = 31 (011111b)

// 元素A: hash = 25 (11001b)
// 旧位置: 25 & 15 = 11001 & 01111 = 01001b = 9
// 新位置: 25 & 31 = 11001 & 11111 = 11001b = 25
// 判断: 25 & 16 = 11001 & 10000 = 10000b ≠ 0 → 高位链表

// 元素B: hash = 9 (01001b)
// 旧位置: 9 & 15 = 01001 & 01111 = 01001b = 9
// 新位置: 9 & 31 = 01001 & 11111 = 01001b = 9
// 判断: 9 & 16 = 01001 & 10000 = 00000b = 0 → 低位链表
优化效果
-
避免重新计算哈希:直接通过位运算判断位置变化
-
链表保持顺序:JDK 1.8 保持链表元素的相对顺序,避免并发环境下可能出现的死循环问题(JDK 1.7 存在此问题)
-
均匀分布:将链表拆分为两个,有助于维持哈希分布的均匀性
完整扩容示例
java
java
public class HashMapResizeExample {
    public static void main(String[] args) {
        // 创建一个初始容量为8的HashMap,插入5个元素触发扩容
        Map<String, Integer> map = new HashMap<>(8, 0.75f);

        // 添加元素,当 size > 8*0.75=6 时触发扩容
        map.put("A", 1);
        map.put("B", 2);
        map.put("C", 3);
        map.put("D", 4);
        map.put("E", 5); // 第5个元素,未触发
        map.put("F", 6); // 第6个元素,达到阈值 8*0.75=6,触发扩容

        System.out.println("扩容完成,新容量为16");
    }
}
总结
| 方面 | JDK 1.8 扩容机制 |
|---|---|
| 触发条件 | size > capacity * loadFactor |
| 新容量 | 旧容量 × 2(保持 2 的 n 次方) |
| 数据迁移 | 高低位链表拆分,避免重新哈希 |
| 性能优化 | 位运算 (hash & oldCap) 判断新位置 |
| 线程安全 | 非线程安全,多线程扩容可能导致死循环或数据丢失 |
最佳实践:在构造 HashMap 时如果能够预估元素数量,应该设置合适的初始容量以避免或减少扩容操作,因为扩容是一个相对昂贵的操作。
十九、为什么在JDK8中HashMap要转成红黑树⭐⭐⭐⭐⭐
核心结论
当 HashMap 中某个桶的链表过长时,查询时间复杂度会从 O(1) 退化为 O(n) 。引入红黑树后,即使发生严重的哈希碰撞,最坏情况下的查询时间复杂度也能保持在 O(log n),从而保证了性能下限。
详细原因分析
1. 解决链表过长导致的性能退化
在 JDK 7 及之前,HashMap 完全使用数组 + 链表的结构。当多个键的哈希值映射到同一个桶时,它们会形成一个链表。
问题场景:
java
java
// 恶意攻击或糟糕的哈希函数可能导致所有元素都映射到同一个桶
// 此时 HashMap 退化为一个链表,性能急剧下降
for (int i = 0; i < 10000; i++) {
    map.put(poorHashKey(i), value); // 所有key的哈希值相同
}

// 查询时间复杂度从 O(1) 退化为 O(n)
String value = map.get(someKey); // 需要遍历10000个节点的链表!
2. 红黑树的性能优势
| 数据结构 | 平均时间复杂度 | 最坏情况时间复杂度 | 适用场景 |
|---|---|---|---|
| 链表 | O(1) | O(n) | 哈希冲突较少时 |
| 红黑树 | O(1) | O(log n) | 哈希冲突严重时 |
效果对比:
-
链表查询 10000 个元素:需要 10000 次比较
-
红黑树查询 10000 个元素:需要 约 14 次比较 (
log₂(10000) ≈ 13.3)
3. 树化阈值的设计
HashMap 并不是立即将链表转为红黑树,而是设置了合理的阈值:
java
java
// HashMap 中的相关常量
static final int TREEIFY_THRESHOLD = 8;    // 链表长度 > 8 时转为树
static final int UNTREEIFY_THRESHOLD = 6;  // 树节点数 < 6 时退化为链表
static final int MIN_TREEIFY_CAPACITY = 64; // 最小树化容量
为什么阈值是 8?
根据泊松分布 统计,在理想的哈希函数下,单个桶中元素个数达到 8 的概率极低(约千万分之六)。这个阈值是在空间成本 和时间成本之间的权衡:
-
链表节点占用空间更小
-
红黑树节点占用空间更大,但查询稳定
总结
| 方面 | JDK 7 及之前 | JDK 8 及之后 |
|---|---|---|
| 数据结构 | 数组 + 链表 | 数组 + 链表 + 红黑树 |
| 最坏情况性能 | O(n) | O(log n) |
| 抗攻击能力 | 弱,容易遭受哈希碰撞攻击 | 强,保证性能下限 |
| 空间开销 | 较小 | 稍大(树节点需要更多指针) |
引入红黑树的核心价值 :在极端情况下(无论是恶意攻击还是意外的哈希碰撞),HashMap 仍能保持可接受的性能水平,这体现了工程设计中保证最坏情况性能的重要性。
二十、HashMap的hash方法是如何实现的?⭐⭐⭐
核心结论
HashMap 的 hash 方法通过将键的原始哈希码 高16位与低16位进行异或运算,来混合原始哈希码的高位和低位特征,从而在表格大小较小时,也能让哈希值的高位参与索引计算,减少哈希冲突。
二十一、HashMap的remove方法是如何实现的?⭐⭐⭐⭐
核心结论
HashMap 的 remove 方法主要步骤:
-
计算哈希 并定位桶位置
-
在桶中查找匹配的键值对
-
执行删除操作(区分链表和红黑树情况)
-
进行后续维护(树退化检查、size更新等)
二十二、ConcurrentHashMap是如何保证线程安全的?⭐⭐⭐⭐⭐
核心结论
ConcurrentHashMap 通过 细粒度锁 + 无锁读 + 原子操作 来保证线程安全,其核心思想是:只锁住正在操作的那部分数据,而不是锁住整个集合,从而允许多个线程同时进行读写操作。
JDK 版本演进对比
| 特性 | JDK 1.7 | JDK 1.8+ (现代实现) |
|---|---|---|
| 锁机制 | 分段锁 | 桶级别锁 |
| 数据结构 | Segment 数组 + HashEntry 链表 | Node 数组 + 链表 + 红黑树 |
| 锁粒度 | Segment (包含多个桶) | 单个桶的头节点 |
| 读操作 | 需要遍历两次,但无需加锁 | 完全无锁,直接 volatile 读 |
总结
ConcurrentHashMap 的线程安全通过以下机制保证:
-
volatile变量:保证内存可见性
-
CAS操作:实现无锁化的原子更新
-
synchronized锁:细粒度的桶级别锁,冲突时使用
-
线程安全的内部操作 :如
compute(),putIfAbsent()等原子方法
这种 "无锁读 + CAS尝试 + 细粒度锁" 的三层策略,使得 ConcurrentHashMap 在保证线程安全的同时,能够支持高并发的读写访问,是现代Java并发编程的典范之作。
二十三、ConcurrentHashMap在哪些地方做了并发控制⭐⭐⭐
核心结论
ConcurrentHashMap 的并发控制主要体现在以下几个关键部位,其设计哲学是:只在绝对必要的地方进行最小范围的同步。
-
初始化阶段:使用 CAS 控制数组的创建。
-
插入阶段:
-
空桶插入 :使用 CAS 进行无锁化操作。
-
非空桶操作 :对 桶的头节点 加
synchronized锁。
-
-
读取阶段 :完全无锁 ,依赖
volatile语义。 -
扩容阶段 :多线程协作完成,使用 ForwardingNode 和
synchronized协调。 -
计数阶段 :使用分段的
LongAdder思想。
总结:并发控制策略全景图
| 操作/场景 | 并发控制机制 | 优点 |
|---|---|---|
| 初始化 | CAS 争抢初始化权 | 保证只初始化一次,避免重复 |
| 读操作 | 完全无锁 + volatile 读 |
极致性能,全并发 |
| 写空桶 | CAS 设置头节点 | 无锁化,高性能 |
| 写冲突桶 | synchronized 锁桶头节点 |
细粒度锁,不影响其他桶 |
| 扩容 | 多线程协作 + ForwardingNode |
高效,避免服务长时间停顿 |
| 计数 | 分段计数 (CounterCell[]) |
减少CAS冲突,高并发更新 |
设计哲学:
-
能无锁,不加锁(如读操作、空桶插入)
-
必须加锁时,锁粒度最小化(如锁单个桶而非整个表)
-
化整为零,分而治之(如分段计数、多线程协作扩容)
这种精细到每个操作、每种场景的差异化并发控制策略,是 ConcurrentHashMap 能够在高并发环境下依然保持卓越性能的根本原因。
二十四、ConcurrentHashMap是如何保证fail-safe的?⭐⭐⭐⭐
核心结论
ConcurrentHashMap 通过以下机制实现 fail-safe:
-
弱一致性迭代器 :迭代器在创建时不捕获集合的快照,而是遍历当前的实时数据。
-
无
modCount检查 :迭代过程中不检查结构性修改,因此不会抛出ConcurrentModificationException。 -
容忍并发修改 :允许在迭代期间被其他线程修改,迭代器会尽力 反映创建后的修改,但不保证。
与 ArrayList/HashMap 的 Fail-Fast 对比
| 特性 | Fail-Fast (HashMap) | Fail-Safe (ConcurrentHashMap) |
|---|---|---|
| 迭代器基础 | 创建时隐式 或显式 依赖 modCount |
遍历当前 的 table 数组 |
| 并发修改 | 立即抛出 ConcurrentModificationException |
允许,继续迭代 |
| 数据一致性 | 强一致性:看到迭代开始时的集合状态 | 弱一致性:可能看到部分修改 |
| 性能开销 | 无额外开销 | 极低 |
总结
ConcurrentHashMap 的 fail-safe/弱一致性迭代器通过以下方式实现:
-
无快照复制 :不像
CopyOnWriteArrayList那样复制整个数据集,开销极小。 -
实时遍历 :直接遍历当前的内存状态,使用
volatile读保证可见性。 -
容忍修改 :没有
modCount检查,允许并发修改。 -
处理扩容 :通过
ForwardingNode和状态栈安全处理并发扩容。 -
尽力而为:不保证看到所有修改,也不保证看不到任何修改。
这种设计的权衡:
-
优点:极低的迭代开销,不会阻塞写操作。
-
缺点:迭代结果具有不确定性,不适合需要强一致性快照的场景。
对于需要强一致性迭代的场景,可以考虑:
-
对 ConcurrentHashMap 加锁(不推荐,失去并发优势)
-
使用
Collections.synchronizedMap(性能较差) -
在业务层通过版本控制实现一致性
ConcurrentHashMap 的弱一致性迭代器是其高并发设计的自然结果,也是在性能和一致性之间做出的合理权衡。
二十五、如何将集合变成线程安全的?⭐⭐⭐⭐
核心方案概览
| 方案 | 原理 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
1. 使用 java.util.concurrent 包 |
专为高并发设计 | 高性能,细粒度锁 | 无 | 新项目首选 |
2. 使用 Collections.synchronizedXXX() |
包装器 + 互斥锁 | 简单,兼容性好 | 性能较差 | 简单的线程安全需求 |
3. 使用 CopyOnWrite 集合 |
写时复制 | 读性能极高,完全无锁 | 写性能差,内存占用大 | 读多写少 |
| 4. 手动同步(客户端加锁) | 外部同步控制 | 灵活控制 | 容易出错 | 需要定制同步策略 |
方案一:使用 java.util.concurrent 包 (推荐)
这是现代Java应用的首选方案,这些集合专为高并发场景设计。
1.1 ConcurrentHashMap - 替代 HashMap/Hashtable
java
// ✅ 推荐:高性能的并发Map
Map<String, Integer> concurrentMap = new ConcurrentHashMap<>();

// 使用示例 - 多线程安全
ExecutorService executor = Executors.newFixedThreadPool(10);
for (int i = 0; i < 1000; i++) {
    final int taskId = i;
    executor.submit(() -> {
        concurrentMap.put("key" + taskId, taskId); // 线程安全
    });
}
1.2 CopyOnWriteArrayList - 替代 ArrayList/Vector
java
// ✅ 推荐:读多写少的List
List<String> copyOnWriteList = new CopyOnWriteArrayList<>();

// 适合频繁遍历,很少修改的场景
copyOnWriteList.add("item1");
copyOnWriteList.add("item2");

// 多线程遍历是安全的,即使有修改
for (String item : copyOnWriteList) { // 迭代器基于创建时的快照
    System.out.println(item);
}
1.3 ConcurrentLinkedQueue - 并发队列
java
// ✅ 无界线程安全队列
Queue<String> concurrentQueue = new ConcurrentLinkedQueue<>();

// 生产者-消费者模式
concurrentQueue.offer("task1"); // 生产者
String task = concurrentQueue.poll(); // 消费者
方案二:使用 Collections.synchronizedXXX() 包装器
这是将现有非线程安全集合快速转换为线程安全的传统方法。
2.1 基本用法
java
// 包装各种集合
List<String> syncList = Collections.synchronizedList(new ArrayList<>());
Set<String> syncSet = Collections.synchronizedSet(new HashSet<>());
Map<String, Integer> syncMap = Collections.synchronizedMap(new HashMap<>());

// 现在这些集合是线程安全的
syncList.add("thread-safe");
syncMap.put("key", 1);
2.2 重要注意事项:复合操作仍需同步
java
List<String> syncList = Collections.synchronizedList(new ArrayList<>());

// ❌ 不安全:复合操作
if (!syncList.contains("item")) {
    syncList.add("item"); // 可能被其他线程中断
}

// ✅ 安全:手动同步复合操作
synchronized (syncList) {
    if (!syncList.contains("item")) {
        syncList.add("item");
    }
}
2.3 迭代器也需要同步
java
List<String> syncList = Collections.synchronizedList(new ArrayList<>());

// ❌ 不安全:迭代过程中可能并发修改
for (String item : syncList) {
    System.out.println(item);
}

// ✅ 安全:同步迭代
synchronized (syncList) {
    for (String item : syncList) {
        System.out.println(item);
    }
}
方案三:使用 CopyOnWrite 集合
特别适合读操作远远多于写操作的场景。
3.1 CopyOnWriteArrayList 实战
java
public class ConfigurationManager {
    // 配置信息,读多写少
    private final CopyOnWriteArrayList<String> configList =
        new CopyOnWriteArrayList<>();

    // 频繁调用 - 完全无锁,性能极好
    public boolean isFeatureEnabled(String feature) {
        return configList.contains(feature);
    }

    // 很少调用 - 写时复制,有性能开销
    public void updateConfiguration(List<String> newConfig) {
        configList.clear();
        configList.addAll(newConfig); // 内部会复制整个数组
    }

    // 遍历也完全安全
    public void displayAllConfigs() {
        for (String config : configList) { // 基于快照迭代
            System.out.println(config);
        }
    }
}
3.2 CopyOnWriteArraySet 的使用
java
// 基于 CopyOnWriteArrayList 实现的线程安全Set
Set<String> copyOnWriteSet = new CopyOnWriteArraySet<>();
copyOnWriteSet.add("unique1");
copyOnWriteSet.add("unique2");
方案四:手动同步(客户端加锁)
当你需要更精细的控制时,可以在使用普通集合时手动管理同步。
4.1 基本模式
java
public class ManualSynchronizedCollection {
    private final List<String> list = new ArrayList<>();
    private final Object lock = new Object(); // 专门的锁对象

    public void addItem(String item) {
        synchronized (lock) {
            list.add(item);
        }
    }

    public boolean containsItem(String item) {
        synchronized (lock) {
            return list.contains(item);
        }
    }

    // 安全的复合操作
    public boolean addIfAbsent(String item) {
        synchronized (lock) {
            if (!list.contains(item)) {
                list.add(item);
                return true;
            }
            return false;
        }
    }
}
4.2 使用 ReentrantLock 更灵活
java
public class AdvancedSynchronizedCollection {
    private final List<String> list = new ArrayList<>();
    private final ReentrantLock lock = new ReentrantLock();

    public void performComplexOperation() {
        lock.lock();
        try {
            // 复杂的复合操作
            if (list.size() > 0) {
                String item = list.get(0);
                list.remove(0);
                list.add(processedItem);
            }
        } finally {
            lock.unlock(); // 确保锁被释放
        }
    }
}
实战选择指南
| 场景 | 推荐方案 | 代码示例 |
|---|---|---|
| 高并发Map | ConcurrentHashMap |
new ConcurrentHashMap<>() |
| 读多写少的List | CopyOnWriteArrayList |
new CopyOnWriteArrayList<>() |
| 简单的线程安全 | Collections.synchronizedList() |
Collections.synchronizedList(new ArrayList<>()) |
| 生产者-消费者 | ConcurrentLinkedQueue |
new ConcurrentLinkedQueue<>() |
| 需要精确控制 | 手动同步 | synchronized (lock) { ... } |
总结
-
新项目首选
java.util.concurrent- 性能最好,专门为并发设计 -
快速改造用
Collections.synchronizedXXX()- 简单但要注意复合操作 -
读多写少用
CopyOnWrite- 读性能无敌,写性能需容忍 -
特殊需求用手动同步 - 最灵活但也最容易出错
黄金法则:根据你的具体使用模式(读写比例、一致性要求、性能需求)来选择合适的线程安全方案,而不是盲目使用同一种方法。
二十六、什么是COW,如何保证的线程安全?⭐⭐⭐
Copy-On-Write (COW) 总结
一、核心概念
Copy-On-Write(写时复制) 是一种优化策略,采用延时懒惰机制:
-
初始状态:所有调用者共享同一资源
-
修改时:真正复制资源副本,在副本上修改,然后替换原资源
二、Java中的COW实现
-
核心类 :
CopyOnWriteArrayList、CopyOnWriteArraySet -
定位:线程安全的ArrayList和Set实现
三、线程安全保证机制
-
写时复制:修改时先复制整个数组,在新数组上操作,最后替换引用
-
读写分离:读操作与写操作使用不同的数据容器
-
加锁保护:add等写操作在锁内完成,保证原子性
-
无锁读取:读操作不需要加锁,直接访问当前数组
四、工作流程
text
写操作:加锁 → 复制新数组 → 修改新数组 → 替换引用 → 释放锁
读操作:直接访问当前数组(完全无锁)
五、特性与适用场景
| 特性 | 说明 |
|---|---|
| 优点 | 读性能极高,完全并发读取 |
| 缺点 | 写开销大,需要复制整个数组 |
| 内存 | 占用较大,存在旧副本 |
| 迭代器 | 基于快照,不支持可变操作 |
| 适用场景 | 读多写少:白名单、黑名单、商品类目等 |
六、注意事项
-
适合遍历、查询远多于添加、删除的场景
-
写操作性能较差,数据量大时慎用
-
迭代器反映的是创建时的快照状态
二十七、Java 8中的Stream用过吗?都能干什么?⭐⭐⭐⭐
核心概念
Stream(流) 不是数据结构,它更像是一个高级的迭代器,它:
-
不存储数据:它通过管道从数据源(如集合、数组)传导数据。
-
不修改源数据:所有操作都会产生一个新的流。
-
惰性执行:中间操作是"懒"的,只有遇到终止操作时才会开始执行。
-
可并行化 :只需调用
.parallel()就能让处理并行化,非常简单。
Stream 能做什么?------ 五大核心操作类型
Stream 的操作分为两大类:中间操作 和 终止操作。
| 类型 | 说明 | 示例 |
|---|---|---|
| 中间操作 | 返回一个新流,可链式调用 | filter, map, sorted, distinct |
| 终止操作 | 产生最终结果或副作用,流被消耗 | collect, forEach, count, reduce |
一、数据过滤与切片
从一个集合中筛选出需要的元素。
1. filter(Predicate) - 条件过滤
java
java
List<String> names = Arrays.asList("Alice", "Bob", "Charlie", "David");
List<String> result = names.stream()
    .filter(name -> name.length() > 4) // 过滤出长度>4的名字
    .collect(Collectors.toList());
// 结果: ["Alice", "Charlie", "David"]
2. distinct() - 去重
java
java
List<Integer> numbers = Arrays.asList(1, 2, 2, 3, 3, 3, 4);
List<Integer> result = numbers.stream()
    .distinct() // 去除重复元素
    .collect(Collectors.toList());
// 结果: [1, 2, 3, 4]
3. limit(n) / skip(n) - 分页
java
java
List<Integer> numbers = Arrays.asList(1, 2, 3, 4, 5, 6, 7, 8, 9, 10);
List<Integer> result = numbers.stream()
    .skip(2)  // 跳过前2个元素
    .limit(5) // 只取5个元素
    .collect(Collectors.toList());
// 结果: [3, 4, 5, 6, 7] - 相当于数据库的 LIMIT 2, 5
二、数据转换与映射
将一种类型的元素转换为另一种类型。
1. map(Function) - 元素转换
java
java
List<String> names = Arrays.asList("Alice", "Bob", "Charlie");
List<Integer> nameLengths = names.stream()
    .map(String::length) // 将每个字符串转换为其长度
    .collect(Collectors.toList());
// 结果: [5, 3, 7]
2. flatMap(Function) - 扁平化转换(处理嵌套集合)
java
java
List<List<String>> nestedList = Arrays.asList(
    Arrays.asList("Apple", "Banana"),
    Arrays.asList("Carrot", "Daikon")
);
List<String> flatList = nestedList.stream()
    .flatMap(List::stream) // 将多个流合并为一个流
    .collect(Collectors.toList());
// 结果: ["Apple", "Banana", "Carrot", "Daikon"]
三、排序与查找
1. sorted() - 排序
java
java
List<String> names = Arrays.asList("Charlie", "Alice", "Bob");
List<String> sortedNames = names.stream()
    .sorted() // 自然排序
    .collect(Collectors.toList());
// 结果: ["Alice", "Bob", "Charlie"]

// 自定义排序
List<String> customSorted = names.stream()
    .sorted((a, b) -> b.length() - a.length()) // 按长度降序
    .collect(Collectors.toList());
// 结果: ["Charlie", "Alice", "Bob"]
2. 查找与匹配
java
java
List<Integer> numbers = Arrays.asList(1, 2, 3, 4, 5);

boolean allEven = numbers.stream().allMatch(n -> n % 2 == 0); // false
boolean anyEven = numbers.stream().anyMatch(n -> n % 2 == 0); // true
boolean noneNegative = numbers.stream().noneMatch(n -> n < 0); // true

Optional<Integer> firstEven = numbers.stream()
    .filter(n -> n % 2 == 0)
    .findFirst(); // Optional[2]
四、归约与统计
将流中的元素组合起来,得到一个汇总结果。
1. reduce - 归约操作
java
java
List<Integer> numbers = Arrays.asList(1, 2, 3, 4, 5);

// 求和
int sum = numbers.stream().reduce(0, Integer::sum); // 15

// 求最大值
Optional<Integer> max = numbers.stream().reduce(Integer::max); // Optional[5]

// 字符串连接
List<String> words = Arrays.asList("Hello", "World");
String sentence = words.stream().reduce("", (a, b) -> a + " " + b).trim();
// 结果: "Hello World"
2. 数值流专门操作
java
java
IntStream intStream = IntStream.of(1, 2, 3, 4, 5);

int sum = intStream.sum();           // 15
double average = intStream.average(); // 3.0
int max = intStream.max();           // 5
IntSummaryStatistics stats = intStream.summaryStatistics();
// 可以得到 count, sum, min, max, average 所有统计信息
五、数据收集
将流转换为其他形式,这是最强大的功能之一。
1. Collectors.toList()/toSet() - 转换为集合
java
java
List<String> list = stream.collect(Collectors.toList());
Set<String> set = stream.collect(Collectors.toSet());
2. Collectors.toMap() - 转换为Map
java
java
List<Person> people = Arrays.asList(
    new Person("Alice", 25),
    new Person("Bob", 30)
);

Map<String, Integer> nameToAge = people.stream()
    .collect(Collectors.toMap(
        Person::getName, // Key映射器
        Person::getAge   // Value映射器
    ));
// 结果: {Alice=25, Bob=30}
3. Collectors.groupingBy() - 分组
java
java
List<Person> people = Arrays.asList(
    new Person("Alice", "London"),
    new Person("Bob", "London"),
    new Person("Charlie", "Paris")
);

Map<String, List<Person>> peopleByCity = people.stream()
    .collect(Collectors.groupingBy(Person::getCity));
// 结果: {London=[Alice, Bob], Paris=[Charlie]}
4. Collectors.partitioningBy() - 分区
java
java
List<Integer> numbers = Arrays.asList(1, 2, 3, 4, 5, 6);

Map<Boolean, List<Integer>> partitioned = numbers.stream()
    .collect(Collectors.partitioningBy(n -> n % 2 == 0));
// 结果: {false=[1, 3, 5], true=[2, 4, 6]}
六、并行处理
只需一个方法调用,就能让处理并行化。
java
java
List<String> names = Arrays.asList("Alice", "Bob", "Charlie", "David");

// 串行流
long start = System.currentTimeMillis();
List<String> result1 = names.stream()
    .map(String::toUpperCase)
    .collect(Collectors.toList());
long serialTime = System.currentTimeMillis() - start;

// 并行流(自动利用多核CPU)
start = System.currentTimeMillis();
List<String> result2 = names.parallelStream() // 只需改为parallelStream
    .map(String::toUpperCase)
    .collect(Collectors.toList());
long parallelTime = System.currentTimeMillis() - start;
总结:Stream 的核心价值
| 方面 | 传统方式 | Stream 方式 |
|---|---|---|
| 代码风格 | 命令式(怎么做) | 声明式(做什么) |
| 可读性 | 多层循环+条件,复杂 | 链式调用,清晰表达业务逻辑 |
| 并行化 | 手动管理线程,复杂 | 自动并行,一行代码搞定 |
| 性能 | 需要手动优化 | 内置优化,惰性求值 |
适用场景:
-
集合的过滤、转换、排序、分组、统计
-
需要并行处理大量数据
-
希望写出更简洁、更易读的代码
Stream 让 Java 进入了函数式编程的时代,是现代 Java 开发必须掌握的技能!
二十八、为什么ConcurrentHashMap不允许null值?⭐⭐⭐⭐
核心原因:为了避免在并发场景下出现"二义性"或"模糊性"问题。
详细解释:
-
问题的根源: 当
map.get(key)返回null时,这个null可以代表两种含义:-
值不存在: 这个 key 在 Map 中不存在。
-
值就是 null: 这个 key 在 Map 中存在,并且其对应的 value 被显式地设置为了
null。
-
-
HashMap(单线程)的解决方案:
-
在单线程环境下,可以通过
map.containsKey(key)方法来明确区分上述两种情况。 -
因为不会有其他线程干扰,所以这个检查结果是可靠的。
-
-
ConcurrentHashMap(并发)的困境:
-
在并发环境下,无法可靠地使用
containsKey来区分。 -
在你调用
get(key)拿到null之后,正准备调用containsKey(key)进行检查时,其他线程可能已经修改了 Map(比如添加或删除了该 key),导致检查结果瞬间变得不可靠、不准确。
-
结论:
为了消除这种不确定性,保证并发操作时语义的清晰和准确,ConcurrentHashMap 直接在设计上就禁止了 null 作为键和值。这是一种通过牺牲一个不明确的特性,来换取更清晰的并发语义和更高可靠性的设计决策。
二十九、JDK1.8中HashMap有哪些改变?⭐⭐⭐⭐⭐
总结表格
| 特性 | JDK 1.7 及以前 | JDK 1.8 | 改变带来的好处 |
|---|---|---|---|
| 数据结构 | 数组 + 链表 | 数组 + 链表 / 红黑树 | 解决严重哈希冲突时的性能瓶颈 |
| 插入方式 | 头插法 | 尾插法 | 避免多线程扩容时出现循环链表 |
| 扩容机制 | 重新计算哈希,统一插入头部 | 优化位置计算,原链表拆分成两个 | 提升了扩容时的效率 |
| 哈希算法 | 4次位运算,5次异或 | 1次位运算,1次异或 | 计算更高效,且不影响散列效果 |
| API | 基础方法 | 支持 getOrDefault , putIfAbsent 等 |
编程更便捷,支持函数式风格 |
总而言之,JDK 1.8 对 HashMap 的优化是全方位的 ,主要集中在性能提升 (引入红黑树、优化扩容和哈希计算)和修复极端情况下的问题(改为尾插法)上。
三十、ConcurrentHashMap为什么在JDK 1.8中废弃分段锁?⭐⭐⭐⭐
核心原因总结
JDK 1.8 废弃分段锁,是为了进一步提升并发性能、降低资源消耗 。新的实现方式在锁的粒度更细、灵活性更高。
新旧版本对比与原因分析
1. JDK 1.7 的分段锁 (Segment Locking)
-
机制 :将整个数据桶数组分成多个段(Segment),每个段自带一把锁。
-
优点 :相比
Hashtable的全局锁,锁粒度更细,允许不同段的操作并发进行,提升了性能。 -
缺点:
-
并发度固定 :一旦创建,段的数量就固定了。在高并发场景下,即使有大量线程,也无法突破段数的限制,容易在某个热点段上形成性能瓶颈。
-
内存占用大:每个段都是一个独立的哈希表结构,导致额外的内存开销。
-
2. JDK 1.8 的新机制 (Node Locking + CAS)
-
机制 :摒弃了段的概念,直接使用
synchronized锁单个链表/红黑树的头节点 ,并结合大量的 CAS(比较并交换) 无锁算法来管理状态。 -
优点:
-
锁粒度更细 :锁的粒度从 "一个段" 缩小到 "一个桶(链表头节点/树根节点)",发生锁冲突的概率大大降低。
-
并发度更高:理论上,并发度与桶的数量一致,可以支持更多线程同时访问。
-
内存开销更小:去除了复杂的段结构,内存利用更高效。
-
设计更简化:代码实现比分段锁模型更清晰、易于维护。
-
结论
JDK 1.8 的改进是锁技术的一次重要演进:从相对粗粒度的分段锁,升级为更细粒度的桶级别锁,并引入无锁操作的CAS ,从而在高并发性能 和内存效率上都得到了显著提升。
三十一、ConcurrentHashMap为什么在JDK1.8中使用synchronized而不是ReentrantLock⭐⭐⭐⭐
核心原因总结
JDK 1.8 的 ConcurrentHashMap 使用 synchronized 而非 ReentrantLock,是在锁粒度大幅缩小(从段到单个桶节点)的新设计下,对性能、内存开销和开发维护难度进行综合权衡后的最优选择。
具体原因分析
1. 锁粒度变细,竞争概率降低(前提条件)
-
JDK 1.8 将锁的粒度从 "一个段(Segment)" 细化到 "一个桶的头节点(Node)"。
-
在这种设计中,多个线程同时竞争同一个锁(同一个桶)的概率变得非常低。
-
在低竞争场景 下,
synchronized与ReentrantLock的性能差距微乎其微,因为synchronized的偏向锁 和轻量级锁足以高效处理。
2. synchronized 的显著优势
在锁竞争不激烈的背景下,synchronized 的优势得以凸显:
-
内存开销更小:
-
synchronized是 JVM 内置的锁机制,通过对象头中的标记位实现,无需创建额外的锁对象。 -
ReentrantLock是一个独立的类,每个实例都包含一个 AQS(AbstractQueuedSynchronizer)同步器 及其队列节点,内存占用更大 。对于拥有海量节点的ConcurrentHashMap来说,使用ReentrantLock会带来显著的内存浪费。
-
-
性能优化由 JVM 负责:
synchronized作为 Java 原语,能够享受 JVM 在运行时的深度优化 ,如锁粗化、锁消除 等,这些是ReentrantLock无法自动获得的。
-
避免线程挂起,减少上下文切换:
- 在获取锁失败时,
synchronized会先进行自旋尝试 ,而非立即将线程挂起。这在高并发但低竞争的场景下,能有效减少线程上下文切换的开销 ,从而提升性能。而ReentrantLock更容易导致线程直接挂起。
- 在获取锁失败时,
-
编程模型更简单,不易出错:
synchronized无需手动获取和释放锁,由编译器自动插入锁管理指令,从根本上避免了因程序员疏忽而导致死锁的风险。代码也更加简洁。
结论
总而言之,这是一个经典的工程权衡:当 JDK 1.8 通过细粒度的桶锁将并发冲突降至很低时,ReentrantLock 提供的高级功能(如可中断、公平锁、条件变量)变得不再必要 ,而其内存开销大 的缺点则被放大。相反,经过大幅优化的 synchronized 在性能上不落下风 ,同时具备内存开销小、由JVM自动优化、编程简单等巨大优势,因此成为了更合适的选择。