在 Python 编程中,与文件系统打交道是家常便饭。比如,你可能经常遇到过这样的场景:
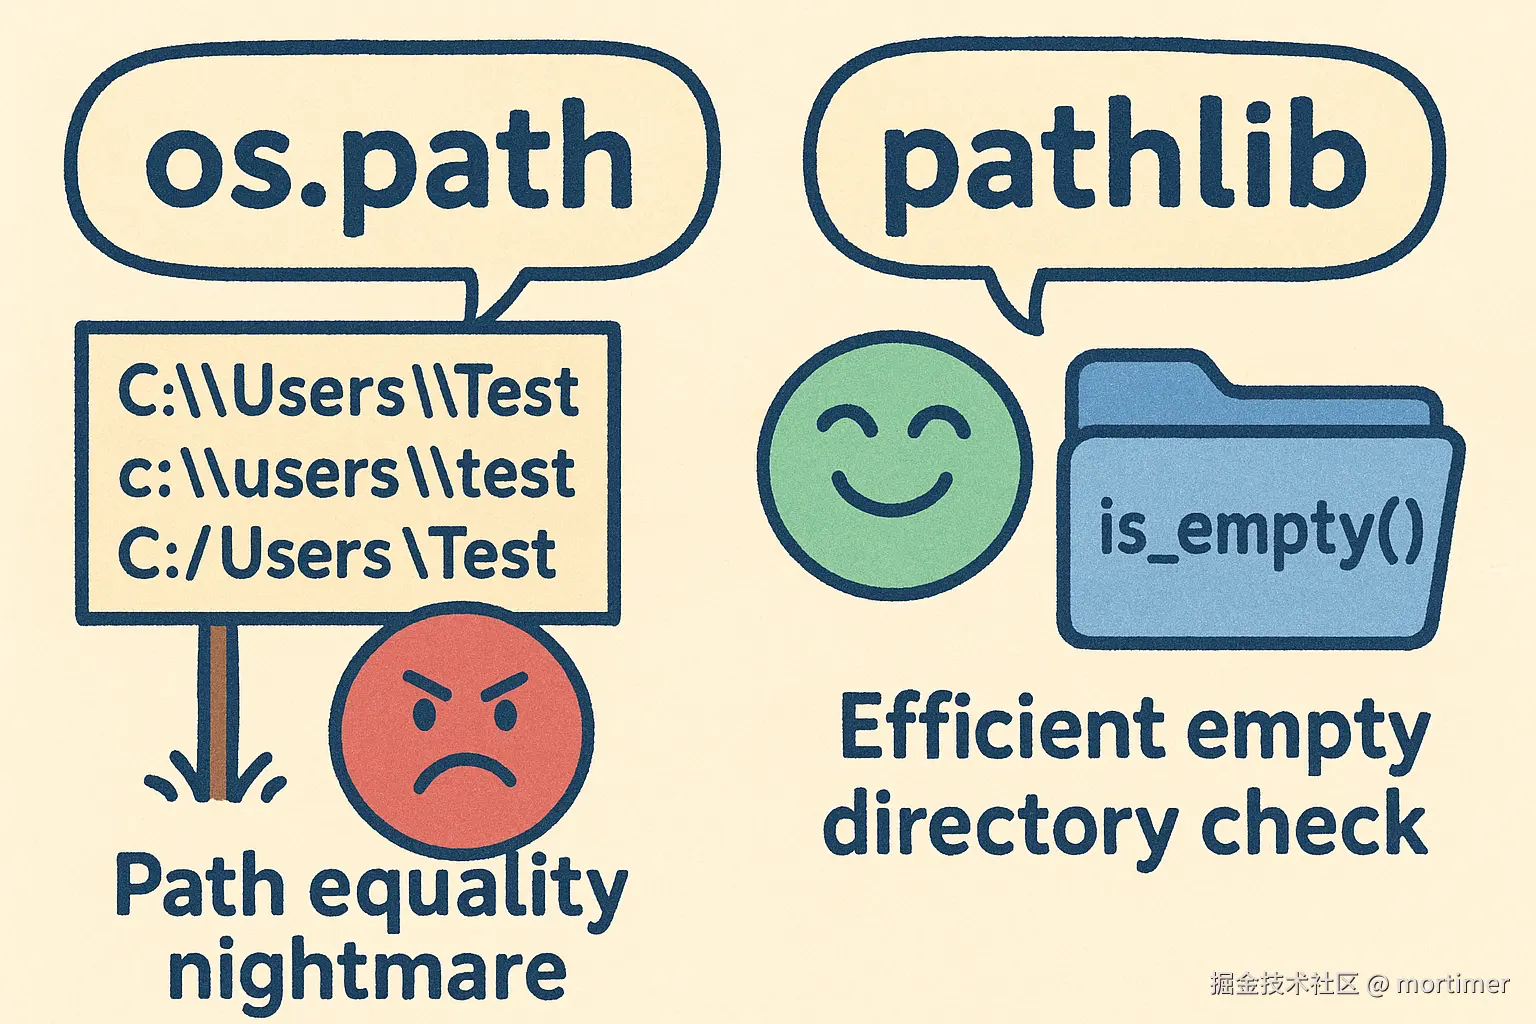
- 判断路径同一性的噩梦 :在 Windows 上,路径
C:\Users\Test、c:\users\test和C:/Users/Test实际上指向同一个地方。但如果你用简单的字符串比较,它们却"形同陌路"。这让本该简单的逻辑判断,变得异常繁琐和脆弱。
- 判断空目录的性能陷阱 :当你需要检查一个可能包含数万个文件的目录是否为空时,一行看似无害的
len(os.listdir(path))可能会让你的程序陷入不必要的等待,消耗大量内存。
这些问题根植于 os.path 基于字符串的操作模式------它只把路径看作一串字符,而忽略了其在文件系统中的实际意义。
幸运的是,Python 3.4 之后增加了 pathlib 模块。它将路径视为一个拥有属性和方法的"对象",用一种现代、直观且健壮的方式,彻底解决了上述难题。
难题一:如何准确判断 C:\Users 和 c:/users 及 c:\userS是同一个目录?
传统方式的困境
面对 path_a = "C:\\Users\\Test" 和 path_b = "c:/users/test",我们束手无策。直接比较 path_a == path_b 显然是 False。我们可能需要祭出 os.path.normcase()、os.path.normpath() 等一系列函数组合,代码不仅丑陋,而且一不小心就会出错。
Pathlib 的黄金标准:.samefile()
pathlib 提供了一个专门为此设计的方法。它不比较字符串,而是直接询问操作系统:"这两个路径是否指向文件系统中的同一个物理对象?"
python
from pathlib import Path

# 假设 C:\Users\Test 目录真实存在
p1 = Path("C:\\Users\\Test")
p2 = Path("c:\\users\\test")  # 大小写不同
p3 = Path("C:/Users/Test")    # 斜杠不同

# .samefile() 直击本质,轻松解决问题
print(f"p1 和 p2 是同一个目录吗? {p1.samefile(p2)}") # -> True
print(f"p1 和 p3 是同一个目录吗? {p1.samefile(p3)}") # -> True
samefile() 彻底绕开了字符串的表象,直接查询底层文件系统信息(如 Windows 上的文件索引),因此它能正确处理大小写、斜杠、相对路径、绝对路径甚至是符号链接。
难题二:如何高效判断一个目录是否为空?
传统方式:os.listdir 的性能陷阱
len(os.listdir(dir_path)) == 0 的问题在于 os.listdir() 会一次性读取目录下所有文件名,并加载到内存中。如果目录为空,一切安好;但如果目录里有十万个文件,程序会花费大量时间构建一个巨大的列表,而我们仅仅想知道它"是不是空的"。
Pathlib 的智慧解法:iterdir
pathlib 提供了一种更智能、更高效的"懒加载"方式。
python
from pathlib import Path

def is_dir_empty_pathlib(dir_path):
    p = Path(dir_path)
    # 1. p.iterdir() 返回一个迭代器,它不会立即加载任何东西
    # 2. any() 尝试从迭代器中取第一个元素,一旦取到就立即返回 True
    # 3. not any(...) 完美实现了我们的判断
    return not any(p.iterdir())
这里的关键是 p.iterdir() 返回的是一个迭代器 。你可以把它想象成一个"随用随取"的管道。any() 函数向这个管道请求第一个项目,只要能拿到(哪怕只有一个文件),它就立刻停止并返回 True,判断结束。整个过程几乎是瞬时的,无论目录中有多少文件。
Pathlib 是时候立即使用了
解决了这两个核心痛点后,你会发现 pathlib 的魅力远不止于此。它是一个设计精良的完整工具集。
1. 基础:创建与拼接
-
创建对象 :一切都从创建一个
Path对象开始。pythonfrom pathlib import Path p = Path("project/data/report.csv") # 获取特殊目录 cwd = Path.cwd() # 当前工作目录 home = Path.home() # 用户家目录 -
优雅拼接 :使用
/运算符拼接路径,代码清晰直观,完美替代os.path.join()。python# 传统方式: os.path.join(Path.home(), ".config", "app") config_dir = Path.home() / ".config" / "app" # -> PosixPath('/home/user/.config/app') 或 WindowsPath('C:/Users/user/.config/app')
2. 路径解析
Path 对象让你能轻松拆解路径的每一个部分。
python
p = Path("/home/user/data/report.csv")

p.parent    # -> Path('/home/user/data')  (父目录,返回一个 Path 对象)
p.name      # -> 'report.csv'              (完整文件名,字符串)
p.stem      # -> 'report'                  (文件名,不含后缀,字符串)
p.suffix    # -> '.csv'                     (文件后缀,字符串)
p.parts     # -> ('/', 'home', 'user', 'data', 'report.csv') (路径元组)
p.anchor    # -> '/'                       (路径锚点,如'/'或'C:\\')
3. 路径变换与修改
无需进行复杂的字符串操作,Path 对象提供了强大的"变形"能力。
p.with_name("data.json"): 替换文件名,保留目录。Path('/home/user/report.csv')->Path('/home/user/data.json')p.with_suffix(".json"): 仅替换后缀。Path('/home/user/report.csv')->Path('/home/user/report.json')p.with_stem("annual_report"): 仅替换文件名主体。Path('/home/user/report.csv')->Path('/home/user/annual_report.csv')p.relative_to('/home/user'): 计算相对路径。Path('/home/user/data/report.csv')->Path('data/report.csv')
4. 状态检查与路径解析
-
状态检查 :
pythonp.exists() # 是否存在? p.is_dir() # 是否是目录? p.is_file() # 是否是文件? p.is_absolute() # 是否是绝对路径? -
绝对路径解析 :
p.resolve(): 最常用。返回一个唯一的、规范化的绝对路径,并解析所有符号链接。是进行路径比较或存储前的最佳选择。p.absolute(): 仅将路径转换为绝对形式,但不解析符号链接。
5. 文件与目录操作
pathlib 封装了许多基本的文件系统操作,让代码更紧凑。
- 创建 :
p.mkdir(parents=True, exist_ok=True): 创建目录。parents=True会自动创建不存在的父目录;exist_ok=True则在目录已存在时不报错,这是健壮脚本的必备参数。p.touch(exist_ok=True): 创建一个空文件,或更新已存在文件的时间戳。
- 移动与重命名 :
p.rename("new/path/new_name.csv"): 移动或重命名文件/目录。
- 删除 :
p.unlink(missing_ok=False): 删除文件。missing_ok=True在文件不存在时不报错。p.rmdir(): 删除一个空目录。- 注意 :要删除非空目录,仍需使用
shutil.rmtree()。
6. 文件读写 I/O:告别繁琐的 with open(...)
对于简单的文件读写,pathlib 提供了无与伦比的便利性。
-
文本文件 :
pythonp = Path("my_note.txt") # 一行代码完成"打开-写入-关闭" p.write_text("This is a line of text.", encoding="utf-8") # 一行代码完成"打开-读取-关闭" content = p.read_text(encoding="utf-8") -
二进制文件 :同样简单。
data = p.read_bytes()和p.write_bytes(data) -
复杂操作 :如果需要更精细的控制(如逐行读写),
.open()方法依然可用,用法与内置open()完全相同:pythonwith p.open("a", encoding="utf-8") as f: f.write("\nAppend a new line.")
7. 遍历与搜索:glob 的威力
p.iterdir(): 遍历目录下的直接子项(非递归)。p.glob(pattern): 使用通配符在当前目录查找,返回一个迭代器。p.rglob(pattern): 递归地在所有子目录中查找,功能强大。
python
project_dir = Path(".")
# 查找所有一级子目录中的 .py 文件
for f in project_dir.glob("*/*.py"):
    print(f)
# 递归查找项目中的所有 requirements.txt 文件
for f in project_dir.rglob("requirements.txt"):
    print(f)
你应该立即拥抱 Pathlib?
pathlib 并非 os.path 的简单替代,它将路径从脆弱的字符串,转变为功能丰富的对象:
- 极高的可读性 :代码
Path.home() / "data"如同自然语言,清晰易懂。 - 卓越的健壮性:自动处理平台差异(如斜杠),内置方法让你远离底层陷阱。
- 无与伦比的便利性:将路径解析、状态检查、文件操作等功能集于一身,大幅提升开发效率。
它就在 Python 标准库中,无需安装,直接 from pathlib import Path 引入即可。