扫描件 PDF 本质是 "图像集合"(每一页都是一张图片),无法直接复制或编辑文本。要提取其中的内容,需借助OCR(光学字符识别)技术。本文将介绍如何通过 Python 结合 OCR 技术实现从扫描件 PDF 中提取文本,涵盖环境搭建及示例代码。
一、核心原理
提取 PDF 扫描件的文本的流程可拆解为 3 步:
- PDF 转图像:将扫描件 PDF 的每一页拆分为独立图像(如 PNG/JPG);
- OCR 识别:用 OCR 工具分析图像,将其中的文字转换为可编辑文本;
- 结果保存:将识别后的文本汇总到文件中(如 TXT)。
二、所需工具
要完成OCR PDF 的任务,需安装以下两个核心库,分工明确:
- Spire.PDF for Python: 将 PDF 页面转换为图像(轻量、兼容性好)
- Spire.OCR for Python:对转换后的图像执行OCR文本识别 (支持多语言)
安装命令:
打开终端/命令提示符,输入以下pip命令,依次安装两个库:
bash
# 安装PDF转图像库
pip install Spire.PDF
# 安装OCR识别库
pip install Spire.OCR
背景知识 :Spire.OCR的用法之前已经详细讲解过,可参考前文:
Python 从图片中提取文本及坐标
二、PDF文字识别提取步骤
下面我们以 "提取扫描 (图片型)PDF 中的中文文本" 为例,步骤如下。
步骤1:导入核心模块
首先导入两个库的核心类,后续所有操作都基于这些模块:
python
# 导入Spire.PDF的核心类(用于PDF加载和转图像)
from spire.pdf import *
# 导入Spire.OCR的核心类(用于OCR引擎初始化和文本识别)
from spire.ocr import *
步骤2:初始化 OCR 引擎(关键配置)
OCR识别的准确率,很大程度取决于引擎的配置---尤其是模型路径 和识别语言,这两步错了会直接导致识别失败。
python
# 初始化 OcrScanner
ocr_scanner = OcrScanner()

# 配置 OCR 依赖
config = ConfigureOptions()
# 设置OCR模型路径 (模型需提前下载,链接在另一篇文章)
config.ModelPath = "F:\\OCR Model\\win-x64"
# 设置识别语言(支持多语言,如"Chinese""Japanese""French")
config.Language = "Chinese"

# 将配置应用到 OCR 引擎
ocr_scanner.ConfigureDependencies(config)
步骤3:加载 PDF 并转换为图像
扫描PDF的本质是"一页页的图像",所以需要先把PDF的每一页拆成独立图像(建议用PNG格式,无损压缩不影响识别):
python
# 加载目标 PDF 文件
pdf_doc = PdfDocument()
pdf_doc.LoadFromFile("示例.pdf")  # 替换为你的PDF实际路径

# 循环遍历PDF的每一页,转换为图像并保存
for page_index in range(pdf_doc.Pages.Count):
    with pdf_doc.SaveAsImage(page_index) as page_image:
        page_image.Save(f"Pdf图片_{page_index}.png")  # 保存为PNG格式,文件名按页码命名
                # 扫描图像
        ocr_scanner.Scan(f"Pdf图片_{page_index}.png")
步骤4:OCR识别图像并保存文本
最后一步,对每个图像执行OCR识别,再将结果汇总到文本文件中(支持追加写入,避免覆盖):
python
        # 从图像中提取文本
        scan_result = ocr_scanner.Text.ToString()

        # 将提取的文本追加写入文件
        with open("PDF文本.txt", 'a', encoding='utf-8') as file:
            file.write(scan_result + '\n')
输出结果:
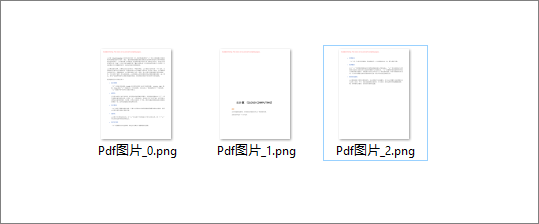
运行代码后,你会得到两个类型的文件:
-
图像文件 :如
Pdf图片_1.png、Pdf图片_2.png,对应PDF的每一页;
-
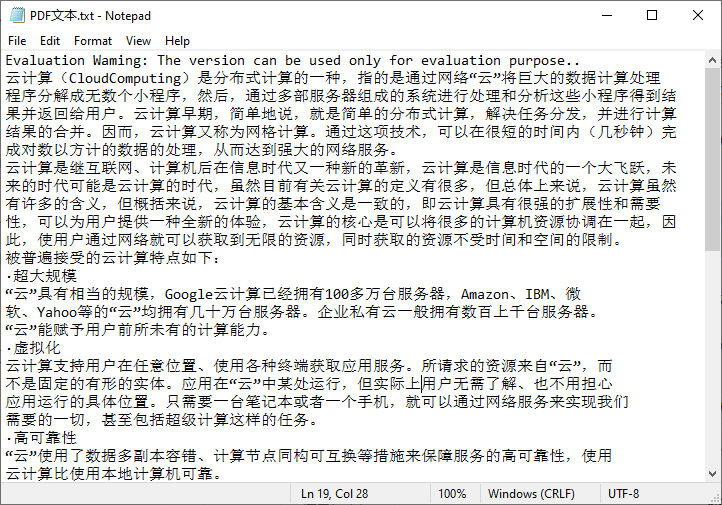
文本文件 :
PDF文本.txt,里面包含每一页的识别文本,示例如下:
四、常见问题&解决方案
| 常见问题 | 可能原因 | 解决方案 |
|---|---|---|
| OCR识别结果乱码/错字多 | 1. 图像分辨率低、模糊;2. 语言设置错误;3. 对比度低 | 1. 确保PDF扫描分辨率≥300DPI;2. 核对Language参数(如中文设为"Chinese");3. 用图像工具提升对比度 |
| OCR引擎初始化失败 | 1. 模型路径错误;2. 模型文件缺失 | 1. 用绝对路径+原始字符串r"";2. 重新下载完整模型包 |
| PDF加载失败 | 1. 文件路径错误;2. PDF文件损坏;3. 无读取权限 | 1. 检查路径是否有空格/特殊字符;2. 用Adobe打开验证文件完整性;3. 赋予文件"读取"权限 |