1. Megatron(NVIDIA Megatron-Core / Megatron-LM)
- 是什么 :NVIDIA 的 开源框架 ,专为 大规模语言模型 (LLM) 训练 设计。它是 NeMo 框架的核心,支持 分布式训练(如 3D 并行:数据、流水线、专家并行),从单 GPU 扩展到千节点集群。
- 核心功能 :
- 高效 GEMM(矩阵乘法)和 Transformer 优化。
- 与 PyTorch/Hugging Face 集成,支持 Llama、GPT 等模型。
- 为什么重要:训练万亿参数模型的标配,推动 AI 工厂(如数据中心级 LLM 训练)。
- 现状:2025 版(0.8.0)集成 cuDNN 9 和 CUTLASS,提升训练速度 2--5x。
- 资源 :GitHub: NVIDIA/Megatron-LM。
2. Dynamo (NVIDIA Dynamo) + NIXL(NVIDIA Inference Xfer Library)
- Dynamo 是什么 :NVIDIA 的 开源推理服务平台 (2025 GTC 发布),Triton Inference Server 的继任者。专为 分布式 AI 推理 设计,支持 LLM(如 GPT-OSS 120B)在数千 GPU 上的高吞吐、低延迟部署。
- 核心功能 :
- 分离预填充(prefill)和解码(decode)阶段,动态调度 GPU 资源。
- KV 缓存(Key-Value Cache)优化:跨内存层(GPU/CPU/SSD/对象存储)卸载,提升 TTFT(Time-to-First-Token) 4x。
- 支持 TensorRT-LLM 等后端,Rust/Python 混合开发。
- 优势:在 B200 Blackwell GPU 上,交互性 ↑4x,无吞吐损失。适用于 AI 工厂、云部署(AWS EKS、Oracle OCI)。
- 现状:0.4 版支持多节点 KV 共享,已开源(GitHub: ai-dynamo/dynamo)。
- 核心功能 :
- NIXL 是什么 (Dynamo 的子组件,常写为 DynamoNIX):高吞吐、低延迟通信库 ,Dynamo 的"数据传输引擎"。抽象异构内存/存储(如 NVLink、InfiniBand、S3),提供统一异步 API,支持 RDMA 读写。
- 核心功能:点对点数据移动(tensor/bytes),自动选最优路径(GPUDirect Storage/UCX),减少同步开销。
- 优势:加速多节点推理,批处理数据转移,提升整体系统吞吐 2--3x。
- 现状 :集成 ETCD 元数据协调,支持 UCX 1.19.0 和 GDRCopy。GitHub: ai-dynamo/nixl。
Dynamo + NIXL 总结:Dynamo 是"AI 推理操作系统",NIXL 是其"高速数据高速公路",解决分布式部署的瓶颈。
3. cuDNN(CUDA Deep Neural Network)
- 是什么 :NVIDIA 的 GPU 加速深度学习原语库,提供卷积、注意力、矩阵乘法等高性能实现。cuDNN 是 CUDA 生态的基础,几乎所有 DL 框架(如 PyTorch、TensorFlow)都依赖它。
- 核心功能 :
- 前向/后向传播优化,支持 Blackwell 的微缩放格式。
- Frontend API(C++/Python):简化图构建和执行。
- 为什么重要:加速训练/推理 10--50x,低延迟云/边缘部署(如自动驾驶)。
- 现状:v9(2025)支持 CUDA 12.8,新增 API 日志和错误报告。下载:NVIDIA Developer。
- 资源 :Docs: docs.nvidia.com/cudnn。
4. CUTLASS(CUDA Templates for Linear Algebra Subroutines)
- 是什么 :NVIDIA 的 开源 CUDA C++ 模板库,用于编写高性能 GPU 内核,特别是 GEMM(矩阵乘法)和卷积------深度学习的"骨干"操作。
- 核心功能 :
- 模板化实现,支持自定义数据类型/精度(如 FP8、INT8)。
- 与 cuDNN 集成,加速 Transformer 和 CNN。
- 为什么重要:开发者可轻松构建自定义内核,推动开源 AI(如 Llama、Gemma)优化。
- 现状:2025 版集成 Megatron-Core,支持 Hopper/Blackwell 架构,提升 GEMM 性能 20%。
- 资源 :GitHub: NVIDIA/cutlass。
这些组件如何协同?(在 NVIDIA AI 栈中)
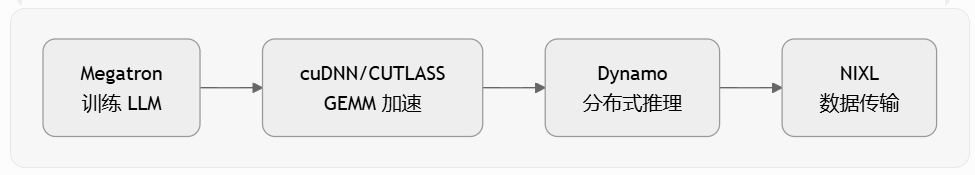
这些不是孤立的,而是 Megatron 训练管道 → Dynamo 推理部署 的核心构建块:
| 阶段 | 组件角色 | 示例协同 |
|---|---|---|
| 训练 | Megatron + cuDNN + CUTLASS | Megatron 用 cuDNN/CUTLASS 加速 GEMM,训练 Llama 模型(NeMo 框架)。 |
| 推理 | Dynamo + NIXL + cuDNN | Dynamo 用 NIXL 跨节点传输 KV 缓存,cuDNN 执行低延迟 matmul。 |
| 优化 | 全栈 | CUTLASS 自定义内核 → cuDNN 集成 → Dynamo 部署,支持 100k+ GPU 规模。 |
- 应用案例(2025):BMW 用 Dynamo + NIXL 优化 Omniverse 模拟;Ansys 用 cuDNN/CUTLASS 加速电磁 AI。
- 开源优先:Dynamo/NIXL/CUTLASS/Megatron 均 GitHub 开源,推动社区(如 Hugging Face)创新。
结论:这些是 NVIDIA "AI 工厂"的基石,从训练到推理全链路 GPU 优化。预计 2026+ 将深度集成 LLM NIM,推动万亿参数模型的实时服务。