把浅色的pdf文件加深
从网上下载的pdf文件,有一些是浅色的。
看起来 十分费劲。
用ps一页一页的,加深处理十分 费劲。
所以考虑用python来 批量处理。
用 PyMuPDF 来 读取pdf文件 的 一页 图片内容。
用 pillow 来 加深 读出的 图片。
以下 附 python 代码。
python 用到 的 PyMuPDF 库 需要python 的3.9版本 以上。
bash
pip install PyMuPDF
bash
pip install pillow以下 用 PyMuPDF 来 读取pdf文件 的 一页 图片内容。
python
import fitz  # PyMuPDF
#qu zhi ding pdf ye mian
#取 指定 pdf 的页面 内容...

file_path='ll.pdf'

doc = fitz.open(file_path)

for i in range(14,15):
	page = doc[i - 1]

	text = page.get_text()
	print (text)
	print ('======'+str(i))

	image_list=page.get_images()

	for img_info in image_list:
		xref = img_info[0] # 图片的引用ID
		pix = fitz.Pixmap(doc, xref) # 创建图片对象

		#xref = img_info[0] # 图片的引用ID
		print (img_info)

		pix.save("page-%i.png" % page.number)  # 将图片保存为PNG


# 关闭文档
doc.close()
以下 用 pillow 来 加深 读出的 图片。
python
from PIL import Image

# 打开图片
img = Image.open("a3.png").convert("RGB")
pixels = img.load()  # 获取像素访问对象

width, height = img.size


# 示例:
for x in range(width):
	for y in range(height):
		r, g, b = pixels[x, y]  #
		#r, g, b = img.split()
		#r=pixels[x,y]
		#r=0
		#g=0
		#b=0
		if r<200 and g<200 and b<200:
			r=0
			g=0
			b=0
		pixels[x, y] = (r, g, b)

		#if (r, g, b) == (255, 255, 255):
			#pixels[x, y] = (255, 0, 0)

img.save("output.jpg")
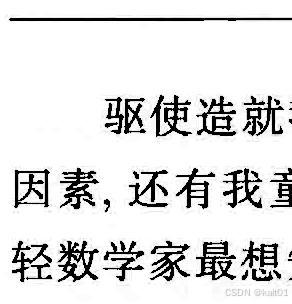
效果图 加深 前
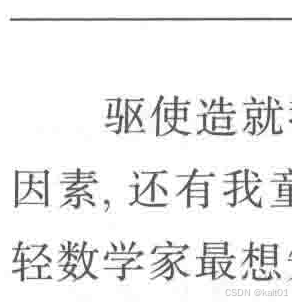
效果图 加深 后