Kafka(文件)数据存储、清理机制、高性能设计

  1. Kafka文件的存储机制

主题 topic - 分区 partition - 分段 segment

每一段有三个文件:

① .index 索引文件

② .log 数据文件

③ .timeindex 时间索引文件

  1. 分段的意义

① 删除无用文件更加方便,提高磁盘的利用率

② 查找数据便捷

  1. 数据清理机制

3.1 根据消息的保留时间,当Kafka中保存的时间超过了指定的时间,就会触发清理过程。

3.2 根据topic存储数据的大小,当topic所占的日志文件大小大于一定的阈值(默认 1 GB),则开始删除最久的消息,需要手动开启。

  1. Kafka 高性能设计

4.1 消息分区: 不受单台服务器的限制,可以不受限的处理更多的数据

4.2 顺序读写: 磁盘顺序读写,提升读写效率(相对于数据随机存放、随机读写而言)

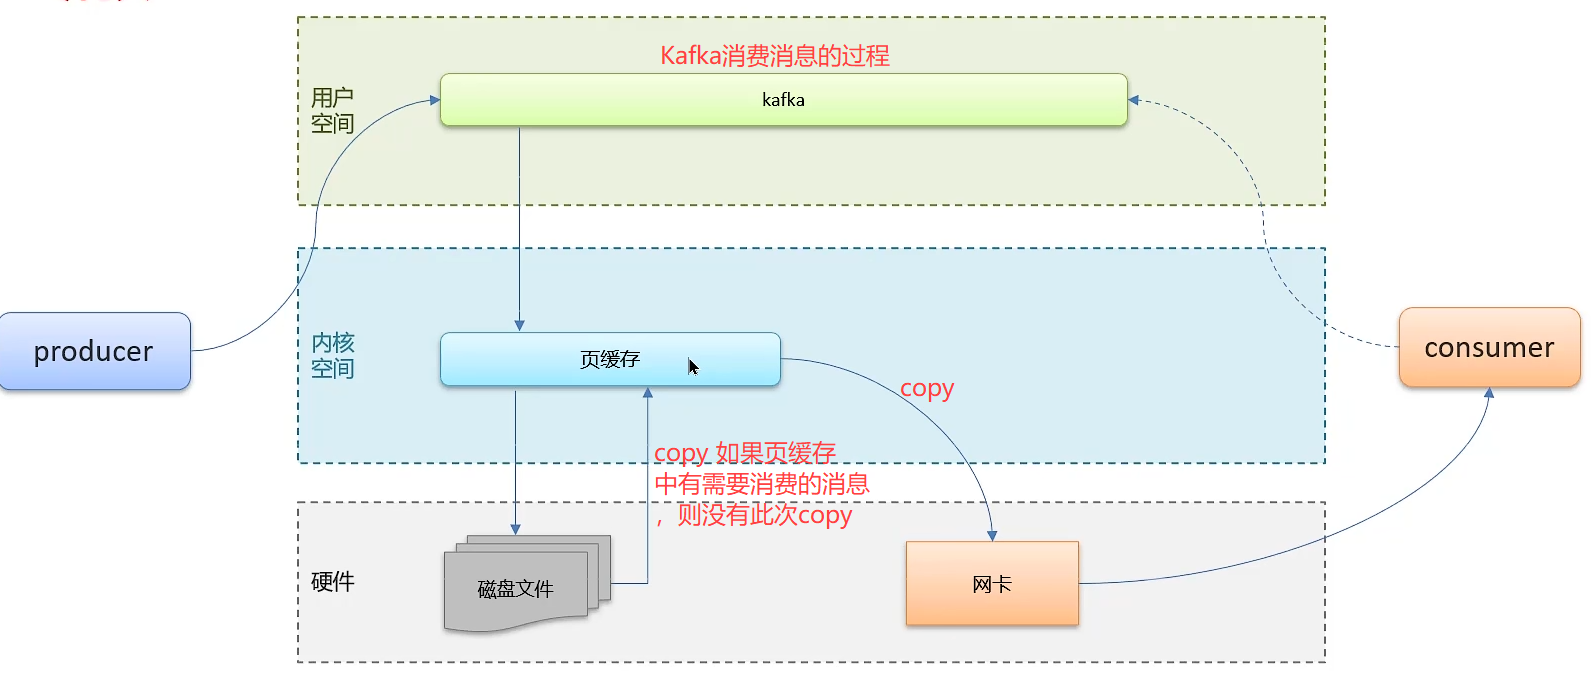
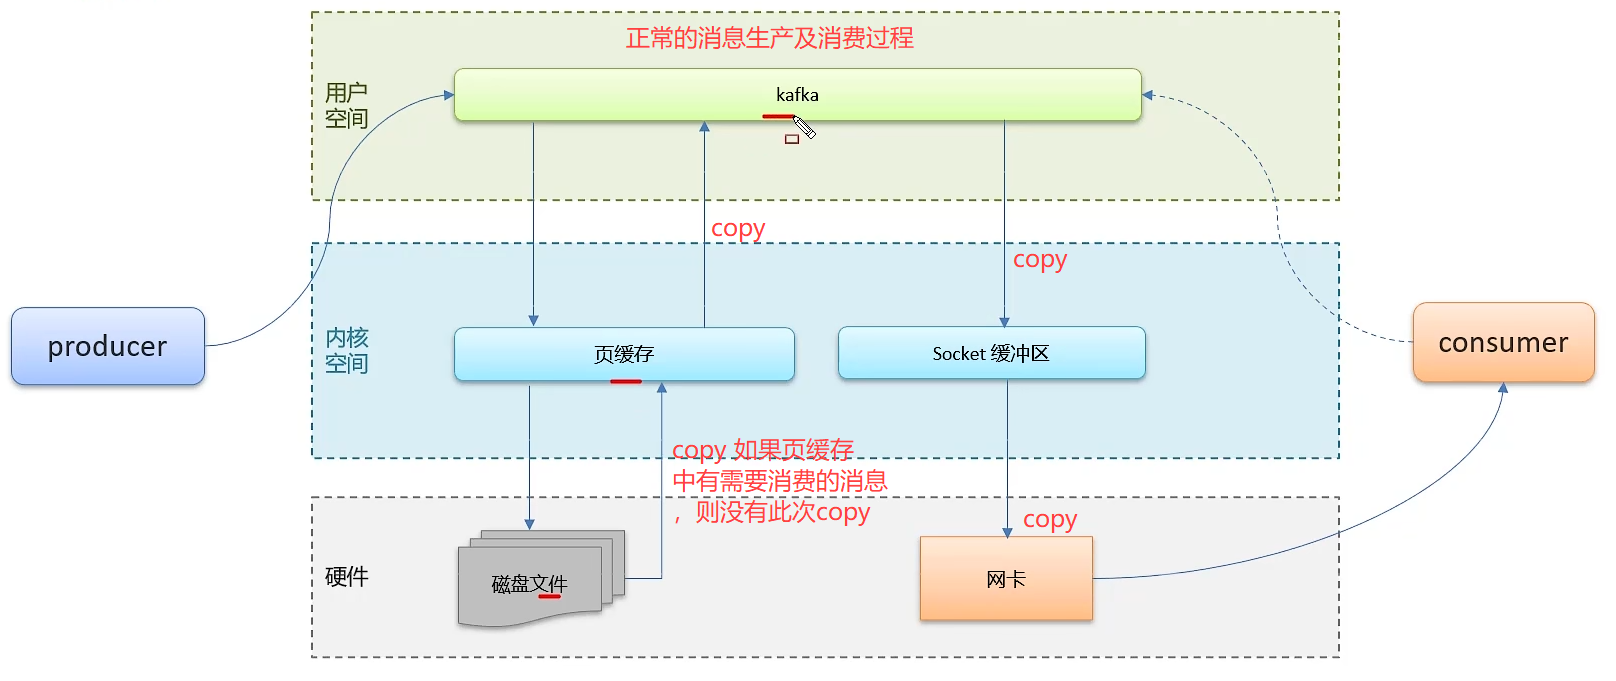
4.3 页缓存(Linux系统): 把磁盘中的数据缓存到内存中,把对磁盘的访问改变为对内存的访问

4.4 零拷贝: 减少上下文切换机数据copy
4.5 消息压缩: 减少磁盘IO和网络IO,但是压缩过程耗费CPU

4.6 分批法送: 将消息打包批量发送,减少网络开销

相关推荐
Thomas.Sir2 天前
第21课:PyTorch|GPU多卡训练与分布式训练基础【让多卡并行成为你的加速引擎】
人工智能·pytorch·分布式
Cicada1282 天前
库存消息消费的正确性设计——从幂等窗口到批量流水线
分布式·系统架构
Nano叶落2 天前
Kafka 消费积压排查入门:Docker 搭环境亲手制造一次 ‘消息堵死‘,10 分钟看懂 Lag
kafka
Francek Chen2 天前
【大数据处理与分析】数据仓库Hive:04 数据仓库Hive概述
大数据·数据仓库·hive·hadoop·分布式
Gl�ria3 天前
Hadoop/YARN 集群缩容:下线DN节点
大数据·hadoop·分布式
吉甫作诵3 天前
Kafka 集群安装与运维实战:消费组排查、Offset 重置与副本重分配
大数据·运维·分布式·kafka·消息队列
imDwAaY3 天前
消息队列四大核心问题:顺序性、幂等性、可靠性与一致性
学习·kafka·rabbitmq
wno7043 天前
Spring Boot整合Kafka
spring boot·kafka
是Dream呀3 天前
Harness 工程:让 Agent 真正把任务做完
人工智能·分布式·缓存·agent