在星河社区部署大模型unsloth/Llama-3.3-70B-Instruct-GGUF

unsloth/Llama-3.3-70B-Instruct-GGUF在hf的网址:https://huggingface.co/unsloth/Llama-3.3-70B-Instruct-GGUF
在hf-mirror镜像的网址:https://hf-mirror.com/unsloth/Llama-3.3-70B-Instruct-GGUF

先上结论,速度慢,基本上1秒一个token的往外出,基本没法使用

部署unsloth/Llama-3.3-70B-Instruct-GGUF

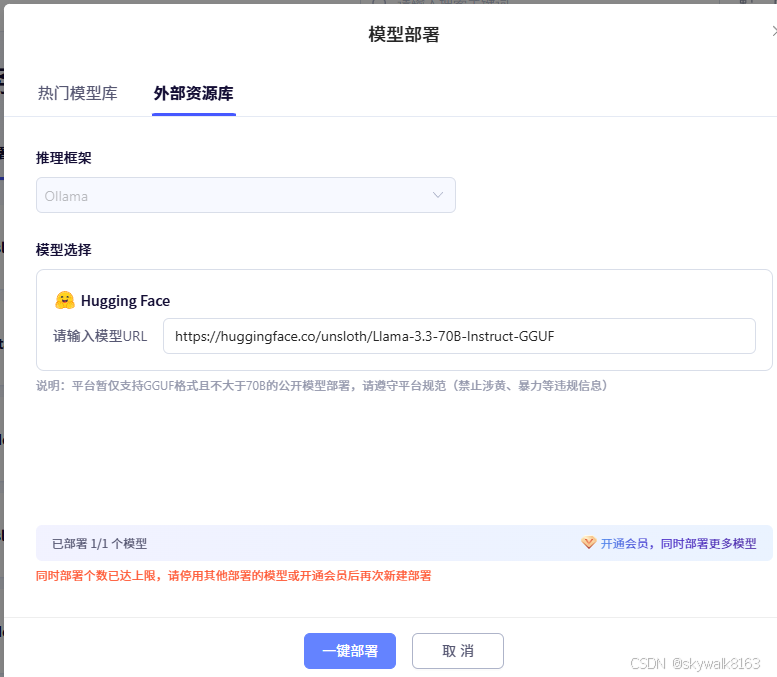
部署很简单,进入星河社区部署页面:飞桨AI Studio星河社区-人工智能学习与实训社区

点击:新建部署,选外部资源库,输入模型url,比如

复制代码
https://huggingface.co/unsloth/Llama-3.3-70B-Instruct-GGUF

然后点击:一键部署,后面一会儿就部署好了。

使用外部库部署要比内部(也就是热门模型库)要慢很多。而且文本输出速度也很慢,只能说聊胜于无吧。

估计也就是7b、8b模型的速度还可以一用。另外文心自己的21b模型,速度也还将就,至少咱也有免费的大模型用,还要啥自行车!

相关推荐
~远在太平洋~12 小时前
大模型评测框架 OpenCompass 本地部署保姆级教程:从安装到跑通 C-Eval 基准(含依赖冲突修复与判分避坑)
llama
程序猿编码3 天前
告别 GPU 空转!token 级调度,Qwen/Llama 高并发推理引擎
人工智能·机器学习·llm·llama·大模型推理
还卿一钵无情泪5 天前
PEFT-Transformers、Unsloth、LLaMA-Factory 微调框架 横向对比
深度学习·大模型·llama·ollama
程序猿编码6 天前
不依赖 vLLM/llama.cpp:一套面向学习的 DeepSeek-R1 CUDA 推理实现
c++·学习·语言模型·llama·vllm·大模型推理
天燹6 天前
本地部署大模型ollama
人工智能·llama
骑着蜗牛撵大象3277 天前
N1 小盒子撑起 AI 接口中转层:New-API 接管本地 Ollama,用 Token 分发模型能力
docker·llama·1024程序员节·api网关·飞牛nas·new-api
言简行敏,心静致远。8 天前
llama-bench使用说明及其应用
llama
AI_Gump8 天前
模型篇|llama.cpp 推理引擎深度解读:从一人练手到 LLM 端侧的事实标准
llama·llama.cpp
星野云联AIoT技术洞察11 天前
设备手册离线 RAG:先管住版本、权限和引文,再谈本地大模型
llama·rag·设备告警·rag知识库·设备运维·设备离线·设备手册
晚风吹北巷13 天前
基于LLama-Factory 进行Lora微调
llama