Windows环境下LLaMA-Factory微调模型时“未检测到CUDA环境”

根据官网安装CUDN

执行命令nvcc -V 和 nvidia-smi 后出现下面图中表示安装OK
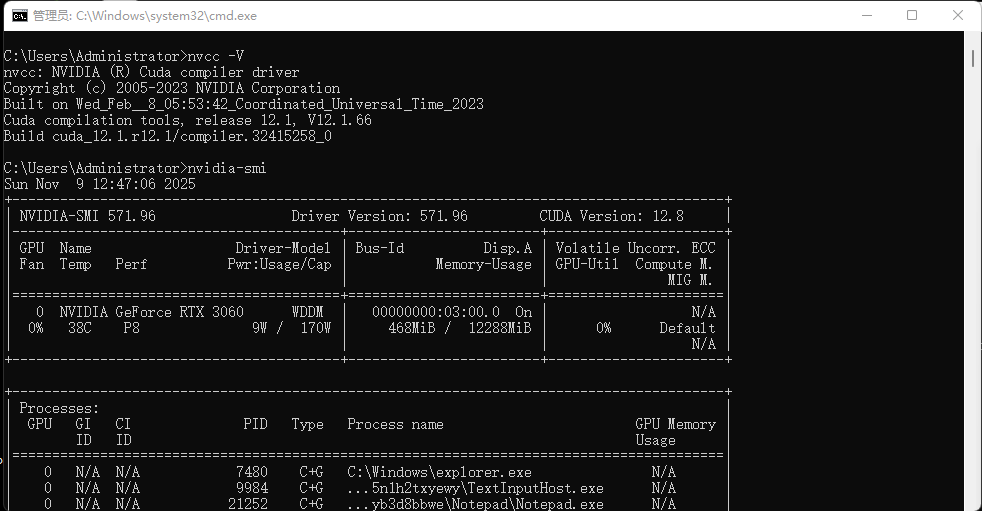
我到这里都ok,但是还是报未检测到CUDA环境,

可以进入Python环境执行命令

python 复制代码
import torch
print(torch.__version__)
print(torch.version.cuda)
print(torch.cuda.is_available())

理想输出应为:

  • 2.3.0(PyTorch-cpu版本)
  • 12.1(编译时使用的CUDA版本)
  • True(GPU可用)

发现PyTorch是cpu版本 要使用GPU需要PyTorch-GPU版

若已经下载了cpu版,可以执行卸载后再安装GPU版

卸载指令

python 复制代码
#卸载 CPU 版 PyTorch(根据安装方式选择命令)
#‌若通过 pip 安装‌:执行卸载主包
pip uninstall torch
#再执行 卸载相关依赖
pip uninstall torchvision torchtext torchaudio
‌#若通过 conda 安装‌:执行 
conda uninstall torch
#卸载主包后,再执行 卸载相关依赖。
conda uninstall torchvision torchtext torchaudio

执行命令下载,若下载慢设置为国内镜像地址

python 复制代码
#pip方式下载安装
pip install torch torchvision torchaudio pytorch-cuda=12.1 -c pytorch -c nvidia

#conda下载安装
conda install pytorch torchvision torchaudio pytorch-cuda=12.1 -c pytorch -c nvidia

安装完成后,成功开启GPU!

相关推荐
GPU实战笔记5 天前
本地跑不动 llama.cpp,临时租云 GPU 怎么搭?从启动服务到环境复用
java·服务器·网络·人工智能·深度学习·llama
牛马工作号7 天前
RK3588 使用 rk-llama.cpp + RKNPU2 部署 Qwen3.5:从零开始的 NPU 本地大模型实战
人工智能·语言模型·llama
书源丶7 天前
Qwen3-Embedding-0.6B 纯 CPU
网络·语言模型·embedding·llama
论文复现现场8 天前
Llama/Qwen 70B 部署需要几张 RTX 4090?2卡、4卡、8卡显存、量化与 vLLM 选型
llama·qwen·vllm·大模型推理·大模型部署·rtx4090
谢白羽9 天前
在4×B300用SGLang部署DeepSeek-V4.1 Flash优化实录
笔记·python·llm·llama·sglang
renzao_ai12 天前
本地 35B 大模型部署实战:Ollama 跑 Ornith-35B 全流程
python·llama·免费ai大模型
Είναι η κοπέλα12 天前
本地大模型部署完全指南:Ollama / vLLM / llama.cpp / MLX 四大引擎横评与选型实战
macos·llama·vllm
小饕12 天前
RK3588 NPU 跑大模型实测:rknn-llm 解码 25.9 tok/s,是 llama.cpp 的 4 倍!附三天完整踩坑记录
人工智能·机器人·llama
一航jason13 天前
Android平台推理框架及试用场景模型对比
android·人工智能·ai·架构·ai编程·llama
一航jason13 天前
Android 端侧大模型推理框架对比
android·人工智能·ai·ai编程·llama·ai-native