目录
[1. Veo 3.1 的三大核心功能提升](#1. Veo 3.1 的三大核心功能提升)
[2. Veo 3.1 体验实测:音画同步惊艳,人物定制仍需优化](#2. Veo 3.1 体验实测:音画同步惊艳,人物定制仍需优化)
[2.1 音画统一测试](#2.1 音画统一测试)
[2.2 首尾画面连贯性与长视频拼接测试](#2.2 首尾画面连贯性与长视频拼接测试)
[2.3 人物主角形象定制测试](#2.3 人物主角形象定制测试)
谷歌最新视频生成模型 Veo 3.1 来了!北京时间 10 月 16 日,谷歌在 Gemini 应用程序接口(API)中发布了 Veo 3.1 和 Veo 3.1 Fast 付费预览版。这款新模型与前不久发布的 Sora 2 一样,新增了音频功能,迅速受到了行业的高度关注。
1. Veo 3.1 的三大核心功能提升
Veo 3.1 的此次提升主要聚焦在三大方面,旨在进一步优化 AI 视频在视听观感上的体验,并寻找实现"AI 长视频叙事"的解法:
AI 视频从默片走向有声电影:Veo 3.1 不但能够要求 AI 视频实现声音和画面的同步统一,还能够要求 AI 更好地理解画面内容,并给予合适的配乐或环境音效。
实现长视频叙事的连贯性:Veo 3.1 可以直接设定 AI 视频的开篇画面和结尾画面。这使得短视频之间的过渡更加自然,并能够进一步控制视频的首尾观感。更具突破性的是,通过将上一个视频的最后一个画面作为下一个视频的开篇,谷歌用一种另类的方式实现了**"AI 长视频"**的无限连贯生成。
通过三张图打造人物人设:用户现在可以给 Veo 3.1 三张图片,分别为一个女性头像、一个服装参考图以及一个场景设定。根据提示词要求,Veo 3.1 可以直接通过三张画面设定 AI 人物形象,并让该人物自然地说出目标台词。
2. Veo 3.1 体验实测:音画同步惊艳,人物定制仍需优化
目前,普通用户可以在 Gemini 应用程序和 Flow 中免费使用 Veo 3.1,但使用机会有限。国内多个 AI 视频生成平台,包括 Imagine.art、Fal-ai 和 Lovart 等,已快速宣布支持 Veo 3.1 模型调用。
2.1 音画统一测试
Veo 3.1 在音画统一上的表现,给出的提示词是:"纽约街头正在下雨,突然一道闪电伴随雷声而来。"
结果:闪电和雷声基本上在同一时间出现,音画一致性达成。更细致的发现是,每一辆车开过水坑时,声音会有一个从远到近、从大到小的变化程度,效果令人惊喜。
不足:生成的视频片段时长大约在 6 秒左右,与 Sora 2 可生成 10-20 秒相比不占优势。此外,画面中除车、雨滴和闪电外,两旁的行人和树木仍是静止的,违和感较重。
2.2 首尾画面连贯性与长视频拼接测试
通过设定首尾画面,并拼接两段视频, Veo 3.1 在连贯性和场景拓展上的能力:
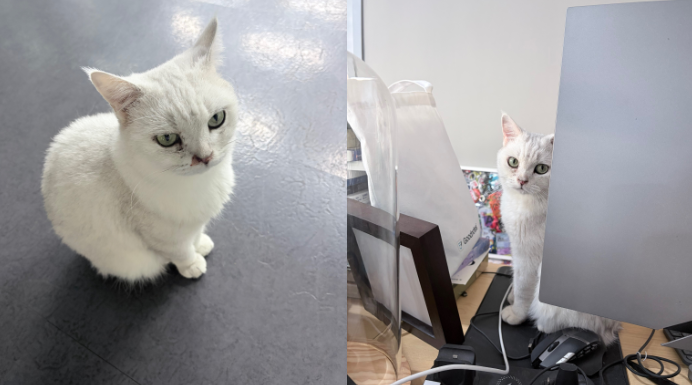
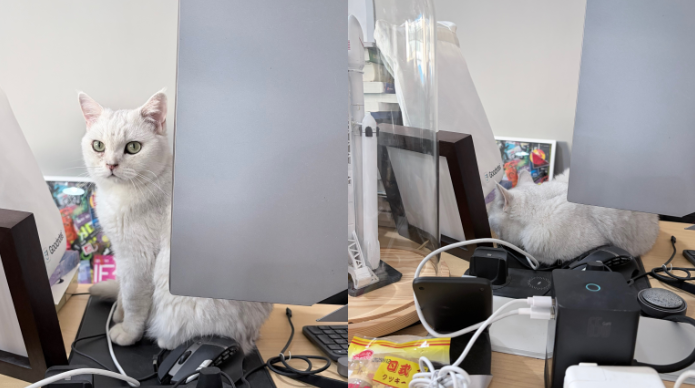
测试 1:指示 Veo 3.1 生成一只虎斑猫跳上办公桌的完整跳跃弧线。结果视频前半部分自然,但在小猫跳到电脑后,突然变了另一只猫,出现了"魔法感"。
测试 2:指示 Veo 3.1 连接到第二个视频,让跳上桌的虎斑猫趴下睡着。当两个视频片段拼接在一起后,除了"魔法感"的突兀,视频与视频之间保持了连贯性,并实现了一定程度上的场景拓展,证明了其"长视频叙事"解法的可行性。
2.3 人物主角形象定制测试
使用三张参考图设定人物主角形象的功能,给出的指令要求人物(参考图)身穿指定服装(参考图)在指定场景(参考图)漫步,并同步生成环境音效。
结果:这是所有测试中表现最差的一项。AI 视频中的人物建模感严重,服装和场景与给出的参考图片有明显差别,AI 感极重。
整体结论:此次 Veo 3.1 在音画同步以及首尾画面稳定上均给出了不错的 AI 效果,展现了谷歌在视听体验上的努力。但在用图片设定人物形象方面,AI 人设的生成效果与官网介绍仍存在差距。