Linux单机部署spark

Linux单机部署spark

前提:java17环境

官网下载:
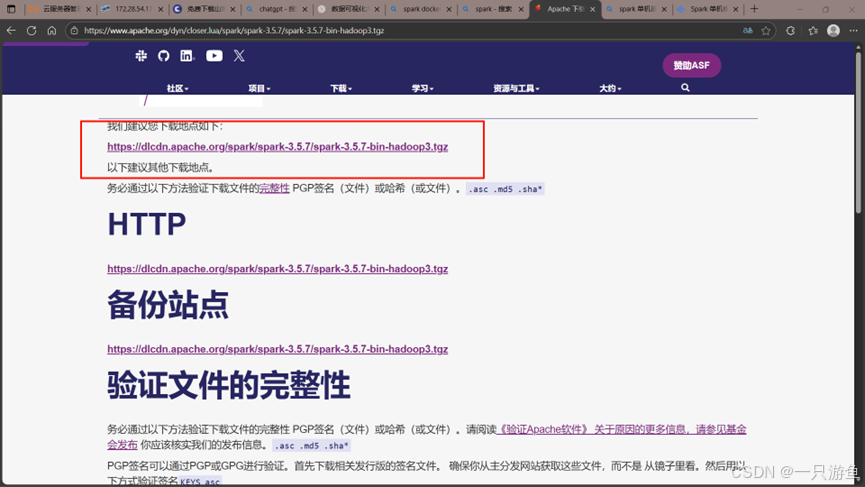
Apache 下载镜像

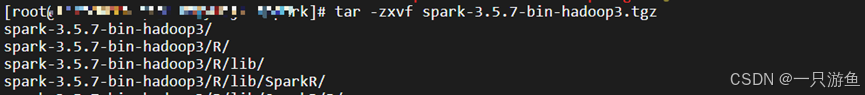
下载成功后通过终端上传到服务器并解压:

tar -zxvf spark-3.5.7-bin-hadoop3.tgz
添加到环境变量:

vi /etc/profile

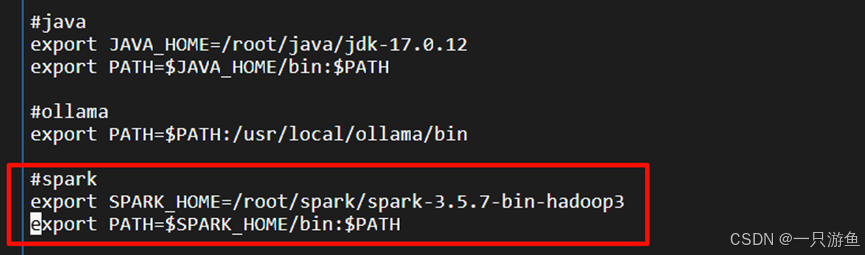
添加如下内容:

#spark

#这里路径给位你的spark的实际路径

export SPARK_HOME=/root/spark/spark-3.5.7-bin-hadoop3

export PATH=SPARK_HOME/bin:PATH
刷新环境变量:

source /etc/profile

检查环境变量是否配置成功:

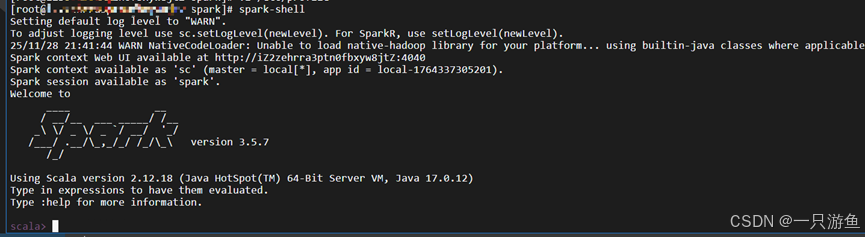
spark-shell

出现以下,证明配置成功:
相关推荐
starzy19902 天前
Structured Streaming 结构化流概述:把流数据当作一张无限增长的表
大数据·spark
Lansonli4 天前
大数据Spark(八十八):Spark任务资源之Standalone集群测试
java·服务器·spark
Lansonli6 天前
大数据Spark(八十七):Spark-Submit 参数详解
大数据·分布式·spark
阿里云大数据AI技术12 天前
EMR Serverless Ray:让 AI 推理融入数据处理
人工智能·spark
freejackman16 天前
【架构篇】双遍历 + 多栈协同:手撸 SQL 血缘引擎的架构思考
java·大数据·数据库·hive·sql·架构·spark
陈年老古董16 天前
Spark 3.1.3 集群搭建 + Spark-SQL 整合 Hive 记录
hive·sql·spark
乌恩大侠17 天前
「AI-RAN」Aerial,使用ORAN C1模式
人工智能·5g·spark·o-ru·ai-ran
测试盐17 天前
spark作业日志定位过程
java·hadoop·spark
IT研究室17 天前
最新大数据毕业设计选题推荐-基于大数据的Kaggle竞赛团队协作模式与效能可视化分析-大数据-Spark-Hadoop-Bigdata
大数据·spark·课程设计