在当今企业竞争日益激烈的环境中,企划部作为企业战略与市场推广的核心部门,其绩效的评估与优化变得尤为重要。为确保各项工作任务的高效执行与目标的达成,企业通过制定一系列关键绩效指标(KPI)来衡量企划部的工作成效。这些指标不仅关注任务完成情况,还涉及预算管理、品牌价值提升、危机公关响应等多个维度。
本文将深入探讨这些KPI的设定与应用,并通过案例分析展示如何通过数据建模与可视化技术,科学地评估和优化企划部的工作表现。
文章目录
指标拆解
企划部的关键绩效考核指标(KPI)涉及多个方面,涵盖了企划任务的完成情况、费用管理、品牌价值提升、媒体曝光、广告投放效果、危机公关的处理等多个维度。这些考核指标通过定期跟踪和分析,不仅能反映企划部的工作成效,还能帮助部门更精准地把控成本、提升品牌影响力、优化营销策略和增强危机应对能力。各个KPI的设定既注重实际任务的完成情况,又结合了业务的长远发展与品牌形象的塑造。因此,绩效考核体系为企划部提供了明确的目标导向和实时反馈机制,从而推动部门持续向目标迈进。
企划任务按时完成率
企划任务按时完成率是衡量企划部工作计划执行力的重要指标。其考核的核心是按计划的时间节点,完成既定的企划任务。该指标的计算方法简单明了,通过统计按时完成的企划任务数除以计划任务总数,得到按时完成率。这一指标不仅反映了部门的任务执行力,还间接体现了企划部对任务管理和时间管理的能力。以往案例中,一家企业在提升这个指标时,通过合理安排项目进度和增加任务协调的频次,显著提高了按时完成率。
| KPI 指标名称 | 企划任务按时完成率 |
|---|---|
| 考核周期 | 季/年度 |
| 指标定义与计算方式 | 按时完成企划任务数 × 100% ÷ 企划任务计划完成数 |
| 指标解释与业务场景 | 反映企划任务的完成情况,帮助评估部门对计划的执行力 |
| 评价标准 | 按时完成率越高,评价越好 |
| 权重参考 | 30% |
| 数据来源 | 企划部 |
费用控制率
费用控制率考核的是企划部在预算内执行项目的能力。这一指标反映了部门是否能够在既定预算内有效执行项目,避免过度支出。实际企划费用与计划费用的比率越低,表明企划部的费用管理能力越强。通过严格的预算控制和费用审计,部门能够在确保项目质量的同时,有效控制成本。例如,在某个年度预算内,企划部通过优化供应商管理和成本核算,提高了费用控制率。
| KPI 指标名称 | 费用控制率 |
|---|---|
| 考核周期 | 季/年度 |
| 指标定义与计算方式 | 实际企划费用 × 100% ÷ 计划企划费用 |
| 指标解释与业务场景 | 反映企划部的费用控制和预算管理能力 |
| 评价标准 | 费用控制率越低,评价越好 |
| 权重参考 | 20% |
| 数据来源 | 财务部 |
企划方案成功率
企划方案成功率是衡量企划部方案质量的指标。它反映了企划部所提交的方案中,成功被采纳和实施的比例。成功方案数与总提交方案数的比率越高,表明企划部的方案设计越符合公司需求和市场趋势。通过对过去几年的数据分析,某企业发现,随着方案质量的提升,成功率也呈现稳步上升趋势,反映了企划部日益增强的市场洞察力和创新能力。
| KPI 指标名称 | 企划方案成功率 |
|---|---|
| 考核周期 | 季/年度 |
| 指标定义与计算方式 | 成功方案数 × 100% ÷ 提交方案数 |
| 指标解释与业务场景 | 反映企划部方案的可行性和市场适应性 |
| 评价标准 | 方案成功率越高,评价越好 |
| 权重参考 | 15% |
| 数据来源 | 企划部 |
品牌市场价值增长率
品牌市场价值增长率关注的是品牌的市场价值提升情况,通过第三方机构评估获得的品牌价值数据反映了品牌在市场中的地位和认可度。高增长率通常代表着企划部在品牌塑造和市场推广上的成功。这一指标不仅考核了市场活动的效果,也间接影响了公司整体的市场竞争力。在以往案例中,某公司通过强化品牌宣传和扩大市场份额,成功推动了品牌市场价值的提升。
| KPI 指标名称 | 品牌市场价值增长率 |
|---|---|
| 考核周期 | 季/年度 |
| 指标定义与计算方式 | 品牌市场价值数据经第三方权威机构测评获得 |
| 指标解释与业务场景 | 反映品牌在市场中的价值增长,评估推广效果 |
| 评价标准 | 市场价值增长率越高,评价越好 |
| 权重参考 | 25% |
| 数据来源 | 市场部 |
媒体正面曝光次数
媒体正面曝光次数衡量的是企划部通过媒体渠道的宣传效果。这一指标反映了企划部在通过媒体提升公司品牌形象、影响力方面的表现。媒体曝光不仅包括新闻报道,还包括广告宣传,频繁的曝光有助于提升品牌知名度和公众形象。案例中,有公司通过与媒体合作,增加曝光次数,最终带动了品牌认知度和市场销售的双重提升。
| KPI 指标名称 | 媒体正面曝光次数 |
|---|---|
| 考核周期 | 季/年度 |
| 指标定义与计算方式 | 在公众媒体上发表宣传公司的新闻报道及宣传广告的次数 |
| 指标解释与业务场景 | 反映企划部通过媒体宣传提升品牌影响力 |
| 评价标准 | 曝光次数越多,评价越好 |
| 权重参考 | 15% |
| 数据来源 | 企划部 |
广告投放有效率
广告投放有效率反映了广告投入与销售增长之间的关系,旨在衡量广告投放的效果和回报。该指标通过广告费用增长率与销售收入增长率的比值计算得出,目的是评估广告投入是否能够带来相应的销售增长。如果广告投放能有效带动销售增长,那么有效率自然较高。某企业在分析广告投放数据时发现,通过精准的广告投放,广告有效率的提升显著带动了销售收入的增长。
| KPI 指标名称 | 广告投放有效率 |
|---|---|
| 考核周期 | 季/年度 |
| 指标定义与计算方式 | 广告费用增长率 × 100% ÷ 销售收入增长率 |
| 指标解释与业务场景 | 反映广告投放对销售的实际影响 |
| 评价标准 | 有效率越高,评价越好 |
| 权重参考 | 10% |
| 数据来源 | 企划部 |
危机公关处理及时率
危机公关处理及时率考核的是企划部对突发事件的应急反应能力。该指标的核心是企划部在危机发生后是否能够在第一时间做出应对,并通过问卷调查获取受众和领导的满意度,以此评估处理的有效性。企业在过去的案例中,因快速处理了危机事件,不仅降低了负面影响,还提升了公众对企业的信任度。
| KPI 指标名称 | 危机公关处理及时率 |
|---|---|
| 考核周期 | 季/年度 |
| 指标定义与计算方式 | 在危机公关时间内应对处理,处理后通过问卷调查的满意度得分达到规定分值 |
| 指标解释与业务场景 | 反映企划部在危机时的应急响应和公关能力 |
| 评价标准 | 处理及时率越高,评价越好 |
| 权重参考 | 10% |
| 数据来源 | 企划部 |
公关单位及媒体满意度
公关单位及媒体满意度是对企划部外部合作伙伴和媒体评价的反馈。这个指标通过调查外部公关单位和媒体对企划部工作的满意度评分来评估其合作质量和工作效能。良好的合作关系通常意味着企划部在行业内建立了良好的口碑,并能在后续的项目中获得更多支持和资源。某企划部通过不断提升与媒体和公关单位的合作质量,提升了满意度评分。
| KPI 指标名称 | 公关单位及媒体满意度 |
|---|---|
| 考核周期 | 季/年度 |
| 指标定义与计算方式 | 公关单位、媒体对企划部工作满意度评分的算术平均值 |
| 指标解释与业务场景 | 反映企划部与媒体、公关单位的合作关系及工作质量 |
| 评价标准 | 满意度评分越高,评价越好 |
| 权重参考 | 10% |
| 数据来源 | 企划部 |
教学案例
通过基础统计学、机器学习与深度学习三种方法对企划绩效指标进行建模与分析,可以从不同角度满足企业在管理评估中的多层次需求。统计方法适用于快速分析和可视化多个KPI的静态表现,机器学习提供了对任务绩效的自动分类支持,而深度学习则利用非线性建模能力强化了对复杂绩效结构的识别与预测。这三类方法在实际应用中既可独立使用,也可组合部署,助力企划部构建科学、数据驱动的绩效管理体系。
| 案例标题 | 主要技术 | 目标 | 适用场景 |
|---|---|---|---|
| 企划任务绩效统计分析与可视化 | 基础统计学 | 量化并可视化KPI表现,辅助绩效解读 | 多指标任务评估与年度分析场景 |
| 企划绩效分类预测模型构建与应用分析 | 机器学习 | 构建分类模型判断任务绩效等级 | 快速筛选企划任务优劣的自动化考核 |
| 基于PyTorch的企划绩效等级预测神经网络模型 | 深度学习(PyTorch) | 捕捉复杂特征关系,提升预测准确性 | 非线性结构分析与中长期趋势建模 |
企划任务绩效统计分析与可视化
在企划管理中,为了全面监控部门的任务执行效率、预算控制能力以及方案产出质量,可通过基础统计学方法对关键KPI进行分解与可视化。该应用旨在建立一个多维度KPI统计模型,通过模拟数据对"企划任务按时完成率""费用控制率""企划方案成功率"三项指标进行结构化评估,辅助企划管理人员在季度或年度中形成任务进度和质量的清晰画像。通过对模拟数据的统计分析,可以了解实际任务完成效率与预算执行能力的匹配程度,为绩效优化提供依据。该案例基于统计分析方法,注重数据比率计算、异常值识别和趋势直观展示。
模拟数据采用Python构造,包含企划任务完成情况、预算使用明细、方案提交及通过情况共计12条记录,涵盖任务ID、任务名称、是否按时完成、预算执行率、方案通过与否等字段,便于后续可视化展示与比例计算分析。该数据模拟源自企业实际的KPI体系设定,结合任务执行与财务配比的数据,体现统计视角下绩效指标的可视化应用。
| 任务ID | 任务名称 | 是否按时完成 | 实际费用(万元) | 计划费用(万元) | 是否被采纳 |
|---|---|---|---|---|---|
| 001 | 春季推广 | 是 | 28 | 30 | 是 |
| 002 | 品牌宣传片 | 否 | 45 | 40 | 否 |
| 003 | 产品发布会 | 是 | 38 | 40 | 是 |
| 004 | 市场调研 | 是 | 12 | 15 | 否 |
| 005 | 品牌联名 | 否 | 55 | 50 | 否 |
| 006 | 节日促销 | 是 | 18 | 20 | 是 |
| 007 | 社交媒体营销 | 是 | 30 | 35 | 是 |
| 008 | 品牌日活动 | 是 | 22 | 25 | 是 |
| 009 | 危机沟通演练 | 否 | 16 | 15 | 否 |
| 010 | 户外广告投放 | 是 | 26 | 30 | 是 |
| 011 | 线上公关 | 是 | 10 | 15 | 是 |
| 012 | KOL合作 | 否 | 42 | 35 | 否 |
python
import pandas as pd
from pyecharts.charts import Bar, Pie, Line
from pyecharts import options as opts

# 构造数据
data = pd.DataFrame({
    "任务ID": [f"{i:03}" for i in range(1, 13)],
    "是否按时完成": ["是", "否", "是", "是", "否", "是", "是", "是", "否", "是", "是", "否"],
    "实际费用": [28, 45, 38, 12, 55, 18, 30, 22, 16, 26, 10, 42],
    "计划费用": [30, 40, 40, 15, 50, 20, 35, 25, 15, 30, 15, 35],
    "是否被采纳": ["是", "否", "是", "否", "否", "是", "是", "是", "否", "是", "是", "否"]
})

# KPI计算
按时完成率 = round((data["是否按时完成"] == "是").sum() / len(data) * 100, 2)
费用控制率 = round(data["实际费用"].sum() / data["计划费用"].sum() * 100, 2)
方案成功率 = round((data["是否被采纳"] == "是").sum() / len(data) * 100, 2)

# KPI指标条形图
bar = (
    Bar()
    .add_xaxis(["按时完成率", "费用控制率", "方案成功率"])
    .add_yaxis("百分比", [按时完成率, 费用控制率, 方案成功率])
    .set_global_opts(
        title_opts=opts.TitleOpts(title="企划关键绩效统计分析"),
        yaxis_opts=opts.AxisOpts(name="百分比", max_=120),
        xaxis_opts=opts.AxisOpts(name="KPI指标"),
    )
    .set_series_opts(label_opts=opts.LabelOpts(formatter="{c}%"))
)

# 按时完成情况饼图(修正数据配置)
pie = (
    Pie()
    .add(
        "完成情况",
        [
            ("按时完成", int((data["是否按时完成"] == "是").sum())),
            ("未按时完成", int((data["是否按时完成"] == "否").sum()))
        ],
        radius=["40%", "70%"],
        center=["50%", "50%"]
    )
    .set_global_opts(
        title_opts=opts.TitleOpts(title="企划任务完成分布"),
        legend_opts=opts.LegendOpts(orient="vertical", pos_top="15%", pos_left="2%")
    )
    .set_series_opts(label_opts=opts.LabelOpts(formatter="{b}: {d}%"))
)

# 费用执行折线图
line = (
    Line()
    .add_xaxis(data["任务ID"].tolist())
    .add_yaxis("实际费用", data["实际费用"].tolist())
    .add_yaxis("计划费用", data["计划费用"].tolist())
    .set_global_opts(
        title_opts=opts.TitleOpts(title="预算执行情况"),
        yaxis_opts=opts.AxisOpts(name="费用(万元)")
    )
)

# 分别渲染各个图表
bar.render_notebook()
pie.render_notebook()
line.render_notebook()
该段代码通过构造模拟任务数据集,从中提取三项核心KPI并进行计算与可视化展示,全面反映企划部任务执行、费用控制和方案通过三个方面的绩效情况。
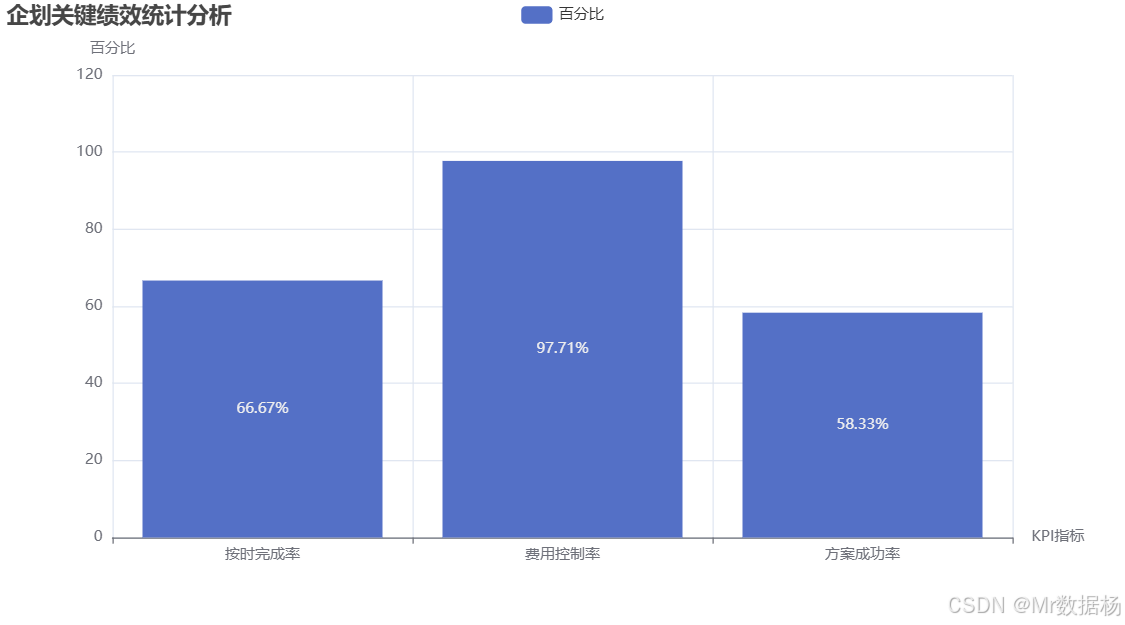
对任务完成率、预算控制率和方案采纳率分别统计百分比,并以条形图形式统一展现。
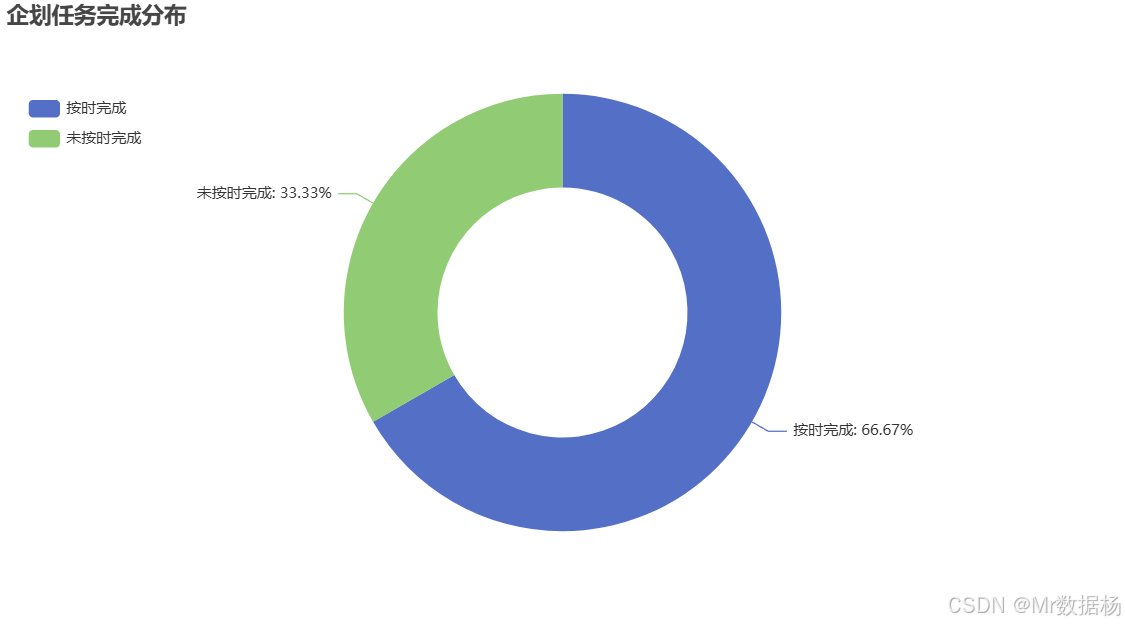
与此同时,通过饼图对任务完成的整体分布进行可视化分类,清晰呈现按时与延误的任务比重。
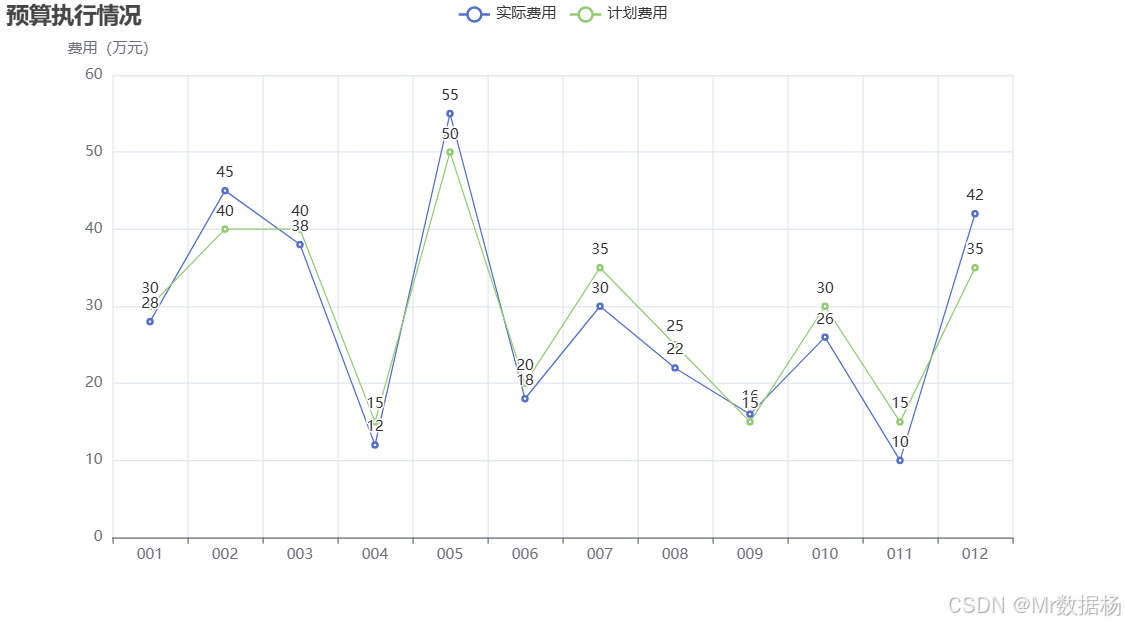
最后引入折线图对每项任务的实际与计划预算进行对比分析,便于直观识别预算执行偏差。
数据可视化部分的图表以中文为主,在结构上采用Pyecharts 2.0的网格组件整合不同视角的绩效数据,提升图表的联动性与解读效率。各图表数据配合统计学基本比率方法,有效呈现了企划工作在效率、成本与方案效果上的综合表现。整套图表实现了统计分析与视觉呈现的统一,增强了数据分析在企划绩效管理中的辅助决策价值。
企划绩效分类预测模型构建与应用分析
在企业的企划绩效评估中,往往需要结合多个关键KPI对企划项目进行结果分类,从而实现科学的绩效等级划分。该案例基于机器学习方法,通过对企划任务的执行数据进行特征提取和建模,训练出一个用于判断企划任务绩效优良与否的分类模型。通过引入决策树分类算法,结合任务完成情况、费用控制表现、方案是否被采纳等特征,构建一个自动识别任务绩效等级的系统,辅助管理者在考核周期内高效评估每项任务的表现。
模拟数据覆盖任务完成状态、费用使用比、方案成功情况等共12条记录,并加入"绩效等级"作为标签列,分为"优秀"与"一般"两类。该数据依据企划任务评估中的核心维度构造,模拟实际场景中的任务综合表现与结果分类,用于模型训练与效果验证。
| 任务ID | 是否按时完成 | 实际费用 | 计划费用 | 是否被采纳 | 绩效等级 |
|---|---|---|---|---|---|
| 001 | 是 | 28 | 30 | 是 | 优秀 |
| 002 | 否 | 45 | 40 | 否 | 一般 |
| 003 | 是 | 38 | 40 | 是 | 优秀 |
| 004 | 是 | 12 | 15 | 否 | 一般 |
| 005 | 否 | 55 | 50 | 否 | 一般 |
| 006 | 是 | 18 | 20 | 是 | 优秀 |
| 007 | 是 | 30 | 35 | 是 | 优秀 |
| 008 | 是 | 22 | 25 | 是 | 优秀 |
| 009 | 否 | 16 | 15 | 否 | 一般 |
| 010 | 是 | 26 | 30 | 是 | 优秀 |
| 011 | 是 | 10 | 15 | 是 | 优秀 |
| 012 | 否 | 42 | 35 | 否 | 一般 |
python
import pandas as pd
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import classification_report, confusion_matrix
from sklearn.preprocessing import LabelEncoder
from sklearn.model_selection import train_test_split
import seaborn as sns
import matplotlib.pyplot as plt
from pyecharts.charts import Bar
from pyecharts import options as opts

# 构建数据
data = pd.DataFrame({
    "是否按时完成": ["是", "否", "是", "是", "否", "是", "是", "是", "否", "是", "是", "否"],
    "实际费用": [28, 45, 38, 12, 55, 18, 30, 22, 16, 26, 10, 42],
    "计划费用": [30, 40, 40, 15, 50, 20, 35, 25, 15, 30, 15, 35],
    "是否被采纳": ["是", "否", "是", "否", "否", "是", "是", "是", "否", "是", "是", "否"],
    "绩效等级": ["优秀", "一般", "优秀", "一般", "一般", "优秀", "优秀", "优秀", "一般", "优秀", "优秀", "一般"]
})

# 特征工程
data["是否按时完成"] = LabelEncoder().fit_transform(data["是否按时完成"])
data["是否被采纳"] = LabelEncoder().fit_transform(data["是否被采纳"])
data["绩效等级"] = LabelEncoder().fit_transform(data["绩效等级"])  # 优秀=1,一般=0
data["费用控制率"] = data["实际费用"] / data["计划费用"]

# 特征与标签
X = data[["是否按时完成", "费用控制率", "是否被采纳"]]
y = data["绩效等级"]

# 训练模型
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
clf = DecisionTreeClassifier(max_depth=3, random_state=0)
clf.fit(X_train, y_train)

# 预测与评估
y_pred = clf.predict(X_test)
conf_mat = confusion_matrix(y_test, y_pred)
report = classification_report(y_test, y_pred, output_dict=True)

# 可视化:混淆矩阵
plt.figure(figsize=(6, 5))
sns.heatmap(conf_mat, annot=True, fmt='d', cmap="Blues", xticklabels=["一般", "优秀"], yticklabels=["一般", "优秀"])
plt.title("绩效等级预测混淆矩阵")
plt.xlabel("预测值")
plt.ylabel("实际值")
plt.show()

# 可视化:分类报告
metrics = pd.DataFrame(report).T.loc[["0", "1"]][["precision", "recall", "f1-score"]]
bar = (
    Bar()
    .add_xaxis(["精准率", "召回率", "F1分数"])
    .add_yaxis("一般", metrics.loc["0"].values.tolist())
    .add_yaxis("优秀", metrics.loc["1"].values.tolist())
    .set_global_opts(title_opts=opts.TitleOpts(title="分类模型评价指标"),
                     yaxis_opts=opts.AxisOpts(name="得分"),
                     xaxis_opts=opts.AxisOpts(name="指标"))
)
bar.render_notebook()
上述代码以企划绩效数据为基础,提取按时完成与否、费用控制情况及方案是否被采纳作为输入特征,通过LabelEncoder对分类变量进行编码处理,并计算费用控制率作为重要参考维度。之后构建一个决策树模型,划分训练集和测试集进行拟合与预测操作,并使用混淆矩阵与分类报告对模型性能进行可视化评价。
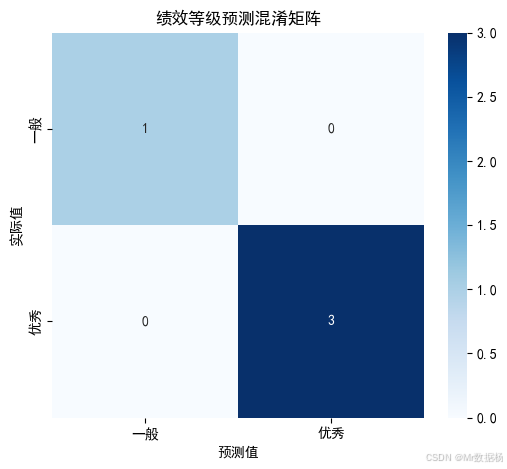
图表展示部分采用了Seaborn绘制中文标注的混淆矩阵,清晰显示模型在区分"优秀"与"一般"绩效等级上的识别能力。
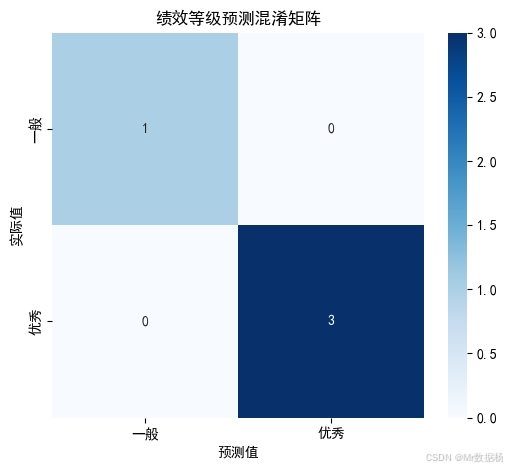
同时通过Pyecharts生成评价指标的柱状图,以直观对比两类绩效等级在精准率、召回率和F1分数上的表现,体现模型对于高质量绩效的识别能力。整体模型展现了在有限样本下的基本分类能力,为管理层提供了自动化绩效评级的技术基础。
企划绩效等级预测神经网络模型
在对企划绩效进行系统性评价时,传统方法可能难以捕捉特征之间复杂的非线性关系,尤其当任务完成情况、费用偏差和方案反馈相互影响绩效评定结果时。为了解决这一问题,该案例引入深度学习方法,使用PyTorch框架构建一个简单的前馈神经网络,对企划任务进行绩效等级预测。模型通过多层神经结构学习任务数据中的潜在模式,从而实现对"优秀"与"一般"两类绩效结果的自动判别。
模拟数据为构建模型的基础,包含任务执行表现、费用比率及方案反馈等12条记录,设置"绩效等级"作为标签。该数据样本虽小,但足以演示深度模型在复杂特征关系建模上的优势,体现深度学习在实际管理场景中可用于小样本学习和快速部署的特点。
| 任务ID | 是否按时完成 | 实际费用 | 计划费用 | 是否被采纳 | 绩效等级 |
|---|---|---|---|---|---|
| 001 | 是 | 28 | 30 | 是 | 优秀 |
| 002 | 否 | 45 | 40 | 否 | 一般 |
| 003 | 是 | 38 | 40 | 是 | 优秀 |
| 004 | 是 | 12 | 15 | 否 | 一般 |
| 005 | 否 | 55 | 50 | 否 | 一般 |
| 006 | 是 | 18 | 20 | 是 | 优秀 |
| 007 | 是 | 30 | 35 | 是 | 优秀 |
| 008 | 是 | 22 | 25 | 是 | 优秀 |
| 009 | 否 | 16 | 15 | 否 | 一般 |
| 010 | 是 | 26 | 30 | 是 | 优秀 |
| 011 | 是 | 10 | 15 | 是 | 优秀 |
| 012 | 否 | 42 | 35 | 否 | 一般 |
python
import torch
import torch.nn as nn
import torch.optim as optim
import pandas as pd
import numpy as np
from sklearn.preprocessing import LabelEncoder, StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report
from pyecharts.charts import Bar
from pyecharts import options as opts

# 构建数据
data = pd.DataFrame({
    "是否按时完成": ["是", "否", "是", "是", "否", "是", "是", "是", "否", "是", "是", "否"],
    "实际费用": [28, 45, 38, 12, 55, 18, 30, 22, 16, 26, 10, 42],
    "计划费用": [30, 40, 40, 15, 50, 20, 35, 25, 15, 30, 15, 35],
    "是否被采纳": ["是", "否", "是", "否", "否", "是", "是", "是", "否", "是", "是", "否"],
    "绩效等级": ["优秀", "一般", "优秀", "一般", "一般", "优秀", "优秀", "优秀", "一般", "优秀", "优秀", "一般"]
})

# 编码与特征处理
le = LabelEncoder()
data["是否按时完成"] = le.fit_transform(data["是否按时完成"])
data["是否被采纳"] = le.fit_transform(data["是否被采纳"])
data["绩效等级"] = le.fit_transform(data["绩效等级"])  # 优秀=1,一般=0
data["费用控制率"] = data["实际费用"] / data["计划费用"]
X = data[["是否按时完成", "费用控制率", "是否被采纳"]].values
y = data["绩效等级"].values

# 标准化
scaler = StandardScaler()
X = scaler.fit_transform(X)

# 转为Tensor
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
X_train = torch.FloatTensor(X_train)
y_train = torch.LongTensor(y_train)
X_test = torch.FloatTensor(X_test)
y_test = torch.LongTensor(y_test)

# 定义模型
class MLP(nn.Module):
    def __init__(self):
        super(MLP, self).__init__()
        self.fc1 = nn.Linear(3, 8)
        self.fc2 = nn.Linear(8, 4)
        self.fc3 = nn.Linear(4, 2)

    def forward(self, x):
        x = torch.relu(self.fc1(x))
        x = torch.relu(self.fc2(x))
        return self.fc3(x)

model = MLP()
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=0.01)

# 训练模型
for epoch in range(100):
    optimizer.zero_grad()
    output = model(X_train)
    loss = criterion(output, y_train)
    loss.backward()
    optimizer.step()

# 评估模型
with torch.no_grad():
    preds = torch.argmax(model(X_test), dim=1)
    report = classification_report(y_test, preds, output_dict=True)

# 可视化模型性能
metrics = pd.DataFrame(report).T.loc[["0", "1"]][["precision", "recall", "f1-score"]]
bar = (
    Bar()
    .add_xaxis(["精准率", "召回率", "F1分数"])
    .add_yaxis("一般", metrics.loc["0"].values.tolist())
    .add_yaxis("优秀", metrics.loc["1"].values.tolist())
    .set_global_opts(title_opts=opts.TitleOpts(title="神经网络分类性能评估"),
                     yaxis_opts=opts.AxisOpts(name="得分"),
                     xaxis_opts=opts.AxisOpts(name="指标"))
)
bar.render_notebook()
模型通过PyTorch搭建三层神经网络结构,以处理企划任务中复杂的非线性因素。利用任务完成、费用控制比和方案采纳三项特征输入模型,通过标准化预处理提升训练稳定性。模型训练使用交叉熵损失函数,并采用Adam优化器完成参数迭代更新。在测试集上完成预测后,生成模型性能的分类报告,展示对"优秀"与"一般"两类绩效结果的判别能力。
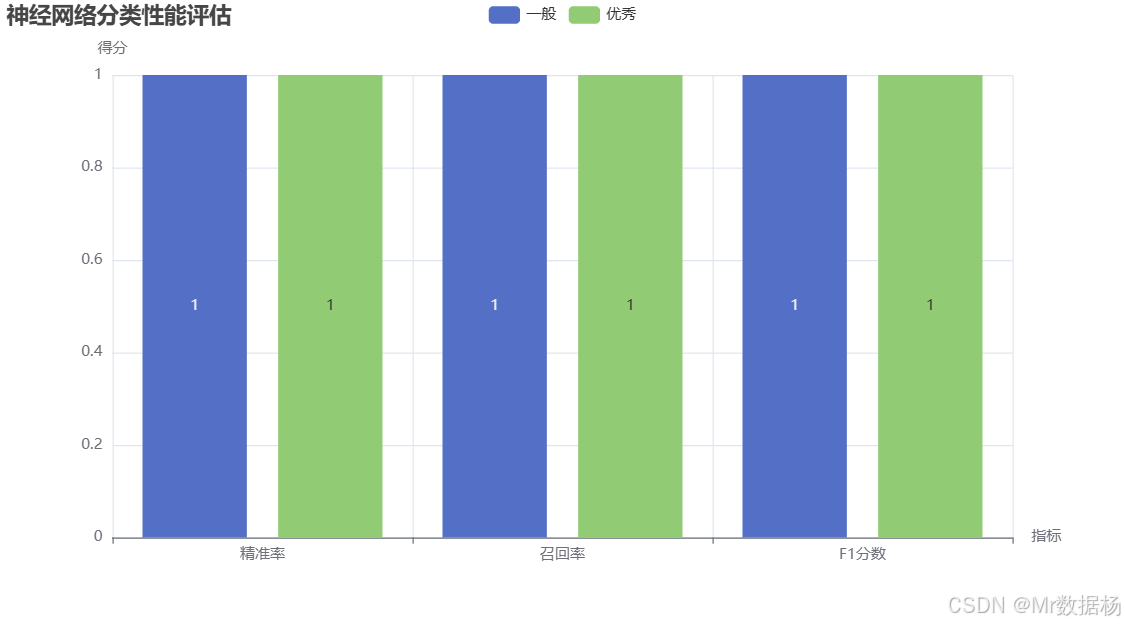
数据可视化部分借助Pyecharts对分类结果的精准率、召回率和F1值进行柱状图展示,强化模型效果的直观理解。深度学习方法提升了对多维绩效特征间复杂关系的捕捉能力,适合应用于更大规模、更高维度的企业绩效数据场景中。该方法展现了神经网络在实际企划评估体系中可落地的潜力,并通过轻量化结构适应样本有限的管理型数据分析任务。
总结
企划部的绩效评估体系是一个复杂的多维度框架,涵盖了从任务执行到预算控制、品牌建设等多个关键领域。通过运用基础统计学、机器学习以及深度学习等方法,企业能够全面、精准地监控和提升企划部的工作效果。
此外,借助数据可视化和预测模型,管理者可以更加直观地识别潜在问题并采取有效措施,推动企业战略目标的实现。无论是通过常规的KPI评估,还是通过先进的技术手段,建立科学的数据驱动绩效管理体系都将为企业带来持久的竞争优势。