表信息说明
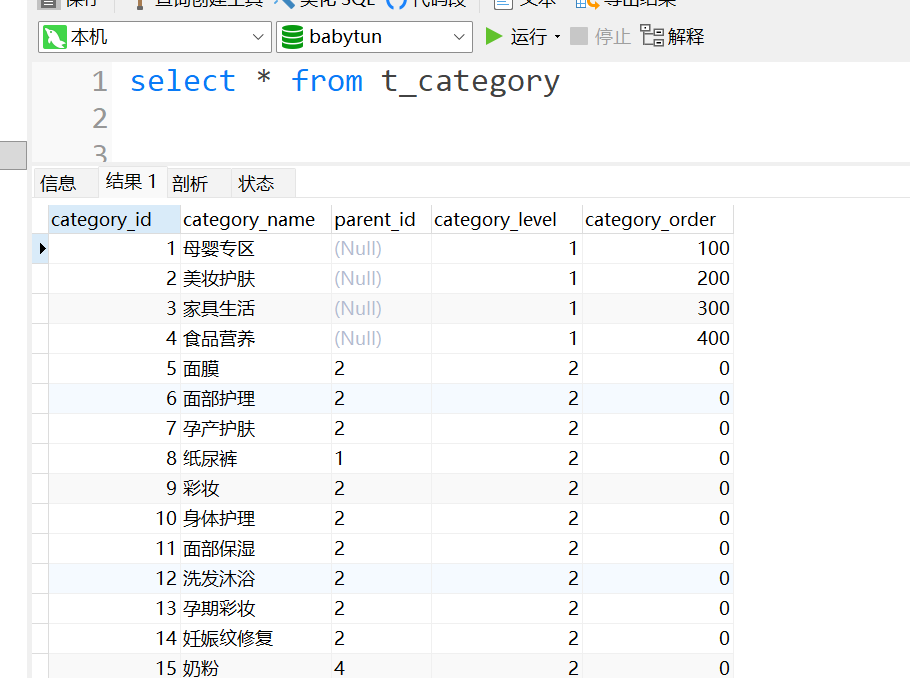
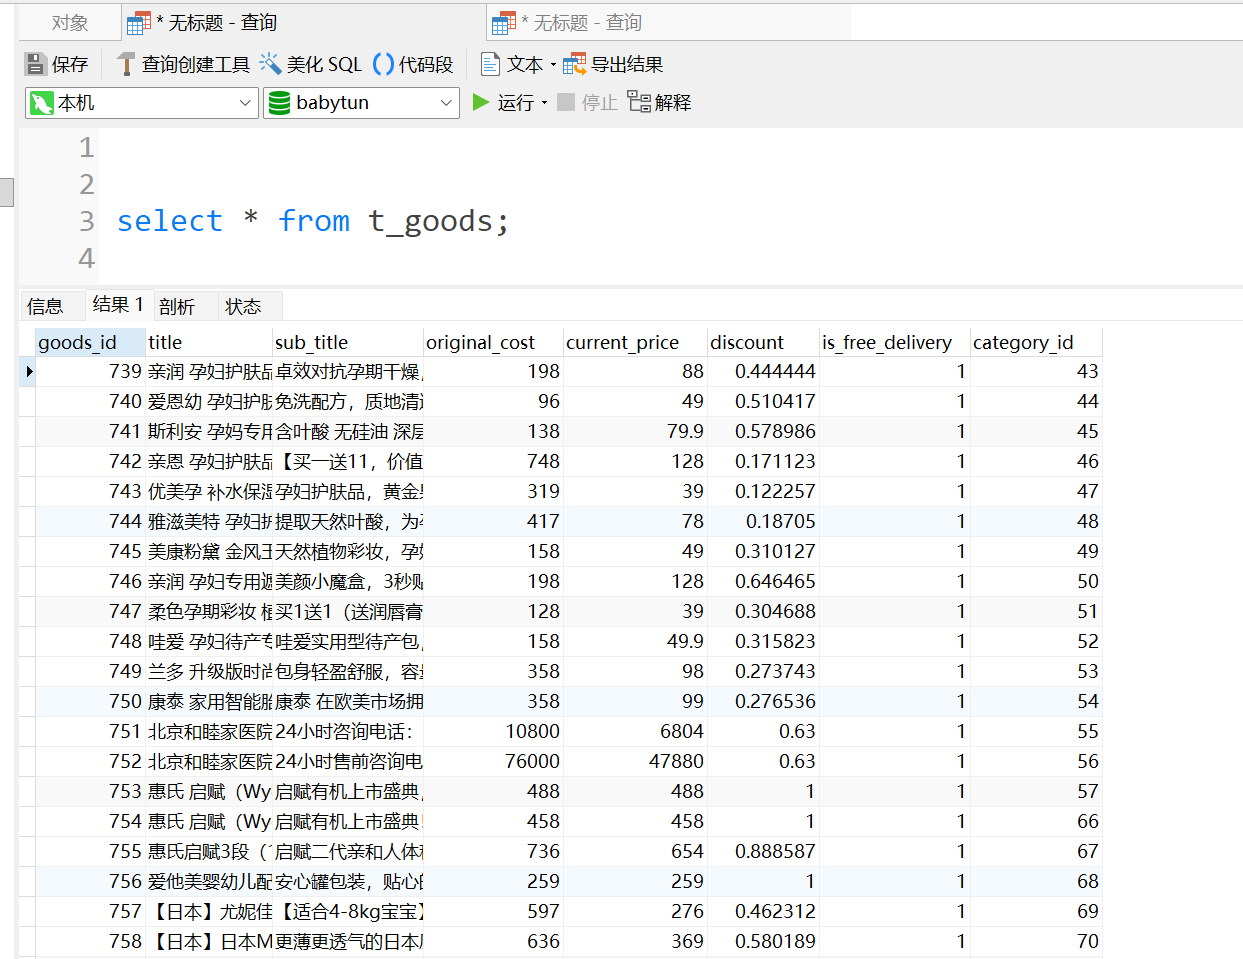
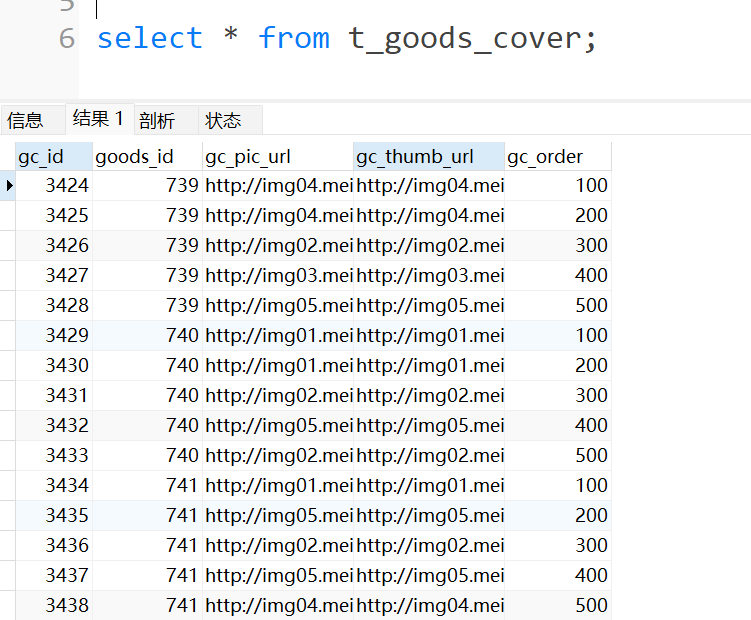
以下三张表,是用于下面查询演示的表,根据字段名称大概就知道其含义,不做额外解释。
商品分类信息表
商品信息表
商品封面图片信息表
关联查询
现在要查询类别ID=40的所有商品标题及其图片信息。
注意当前只是创建了表,然后表中插入了记录,并未对表字段添加索引(除了自带的主键索引)。
查询语句如下:
explain select g.title ,gc.*
from t_goods g , t_goods_cover gc
where g.goods_id = gc.goods_id
and g.category_id = 44 ;
查询语句前的explain关键字,是指显示当前查询的查询计划。下面信息为查询计划的内容:
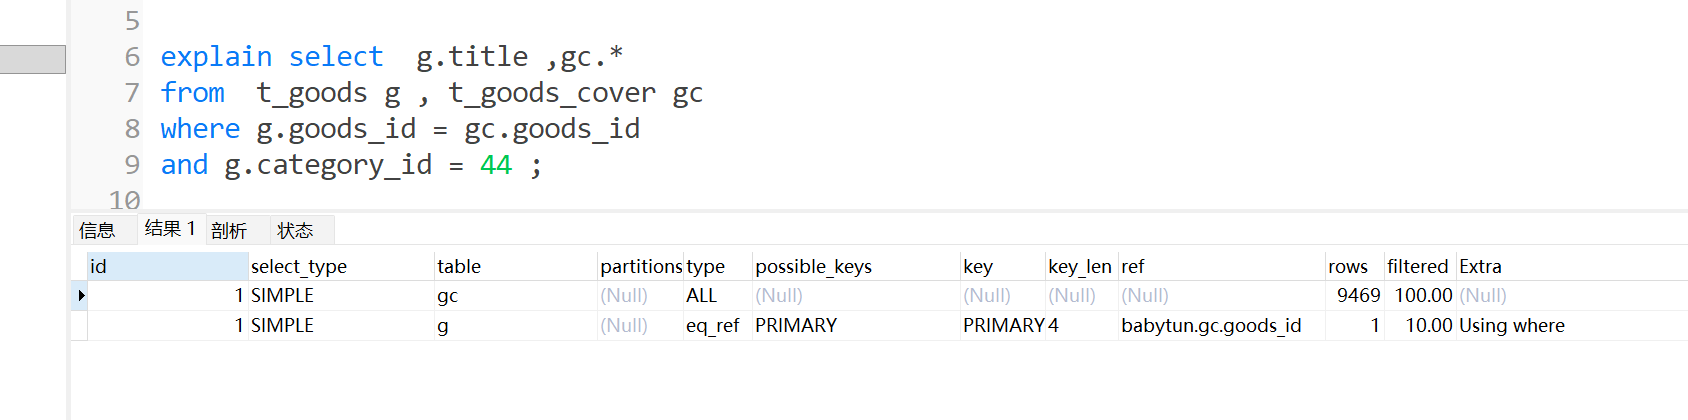
可以看到查询计划有两条数据。从上面的两条执行计划信息中,可以提炼出如下的信息:
- 一般情况下,第一条记录显示的table为驱动表,也就是gc这个表为驱动表。
- 在第一条查询计划中,type=ALL,表示全表扫描,这是执行最慢的一种方式,希望可以优化。
- 第二条执行计划信息,可以看到type=eq_ref,表示联表的主键或唯一键联合查询。指g.goods_id = gc.goods_id查询条件。
explain type值的含义:
①ALL 全表扫描
②eq_ref 联表查询的情况,按联表的主键或唯一键联合查询。
③ref 非主键或唯一索引的等值检索
现在执行一万次查询,看看执行速度如何,下面用Java代码进行测试:
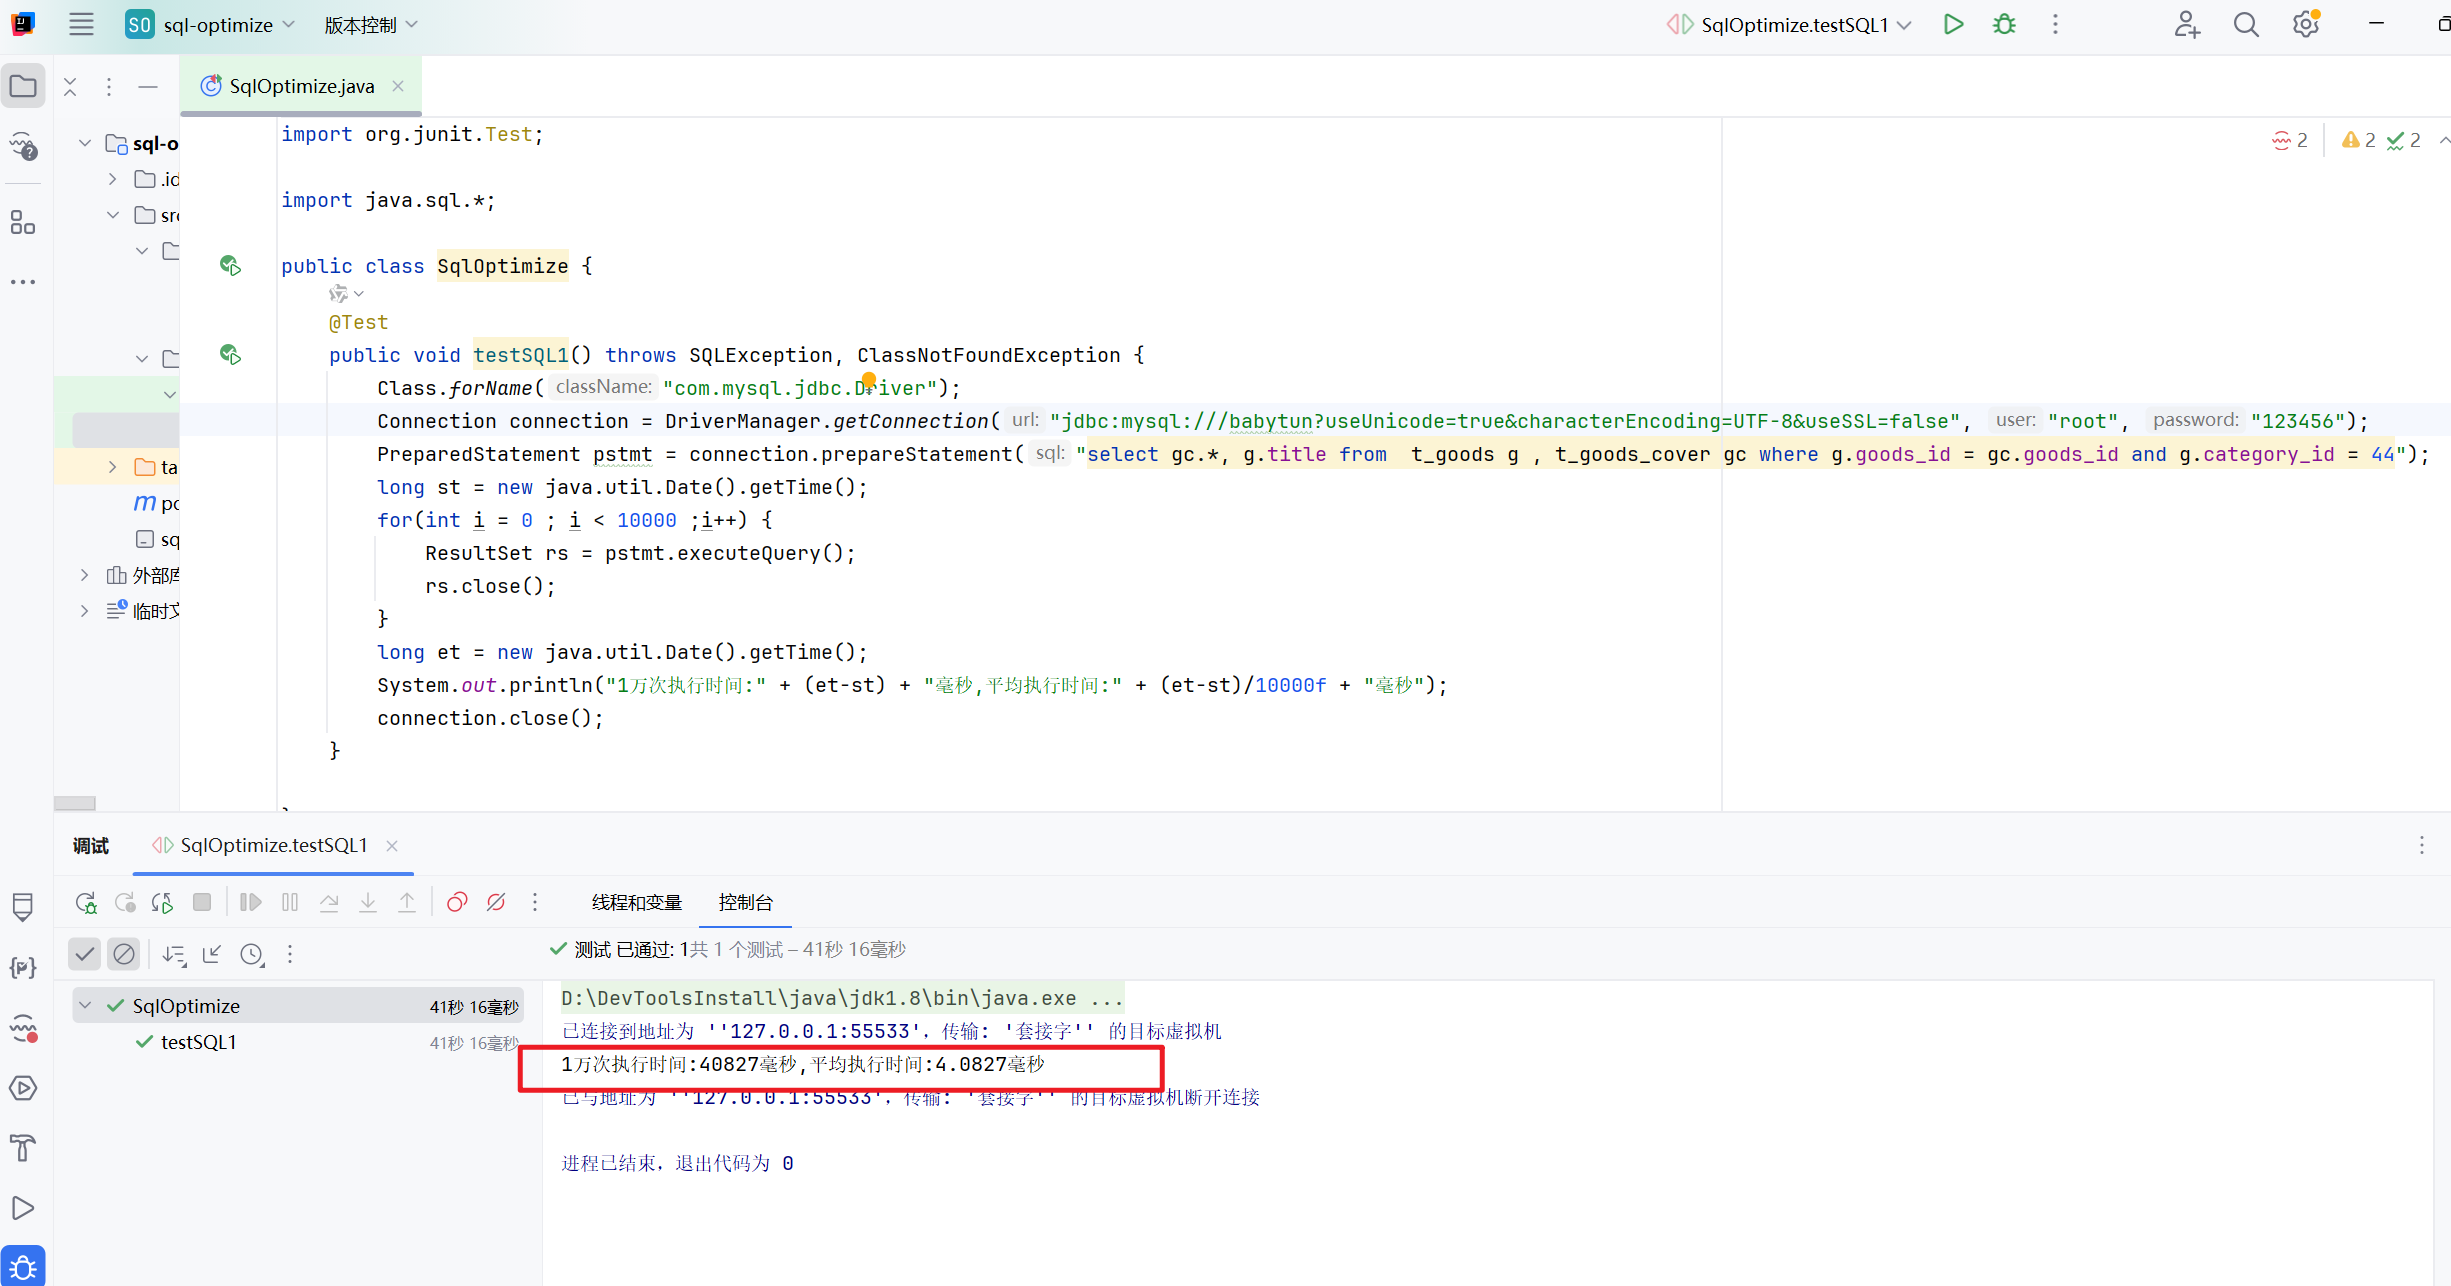
执行一万次查询,平均每次4毫秒。
查询优化
对数据库表字段,添加索引,进行优化:
#关联查询优化要点
#1. 外键上加索引
create index idx_goods_id on t_goods_cover(goods_id);
#2. 查询条件上加索引
create index idx_category_id on t_goods(category_id);
在 t_goods_cover表的外键字段goods_id上添加索引,因为goods_id字段用在了两个表的关联条件中。
在t_goods表的外键字段category_id上添加索引,因为category_id字段用在了where查询条件中。
两个索引添加后,再次执行一万次查询,看下效率:
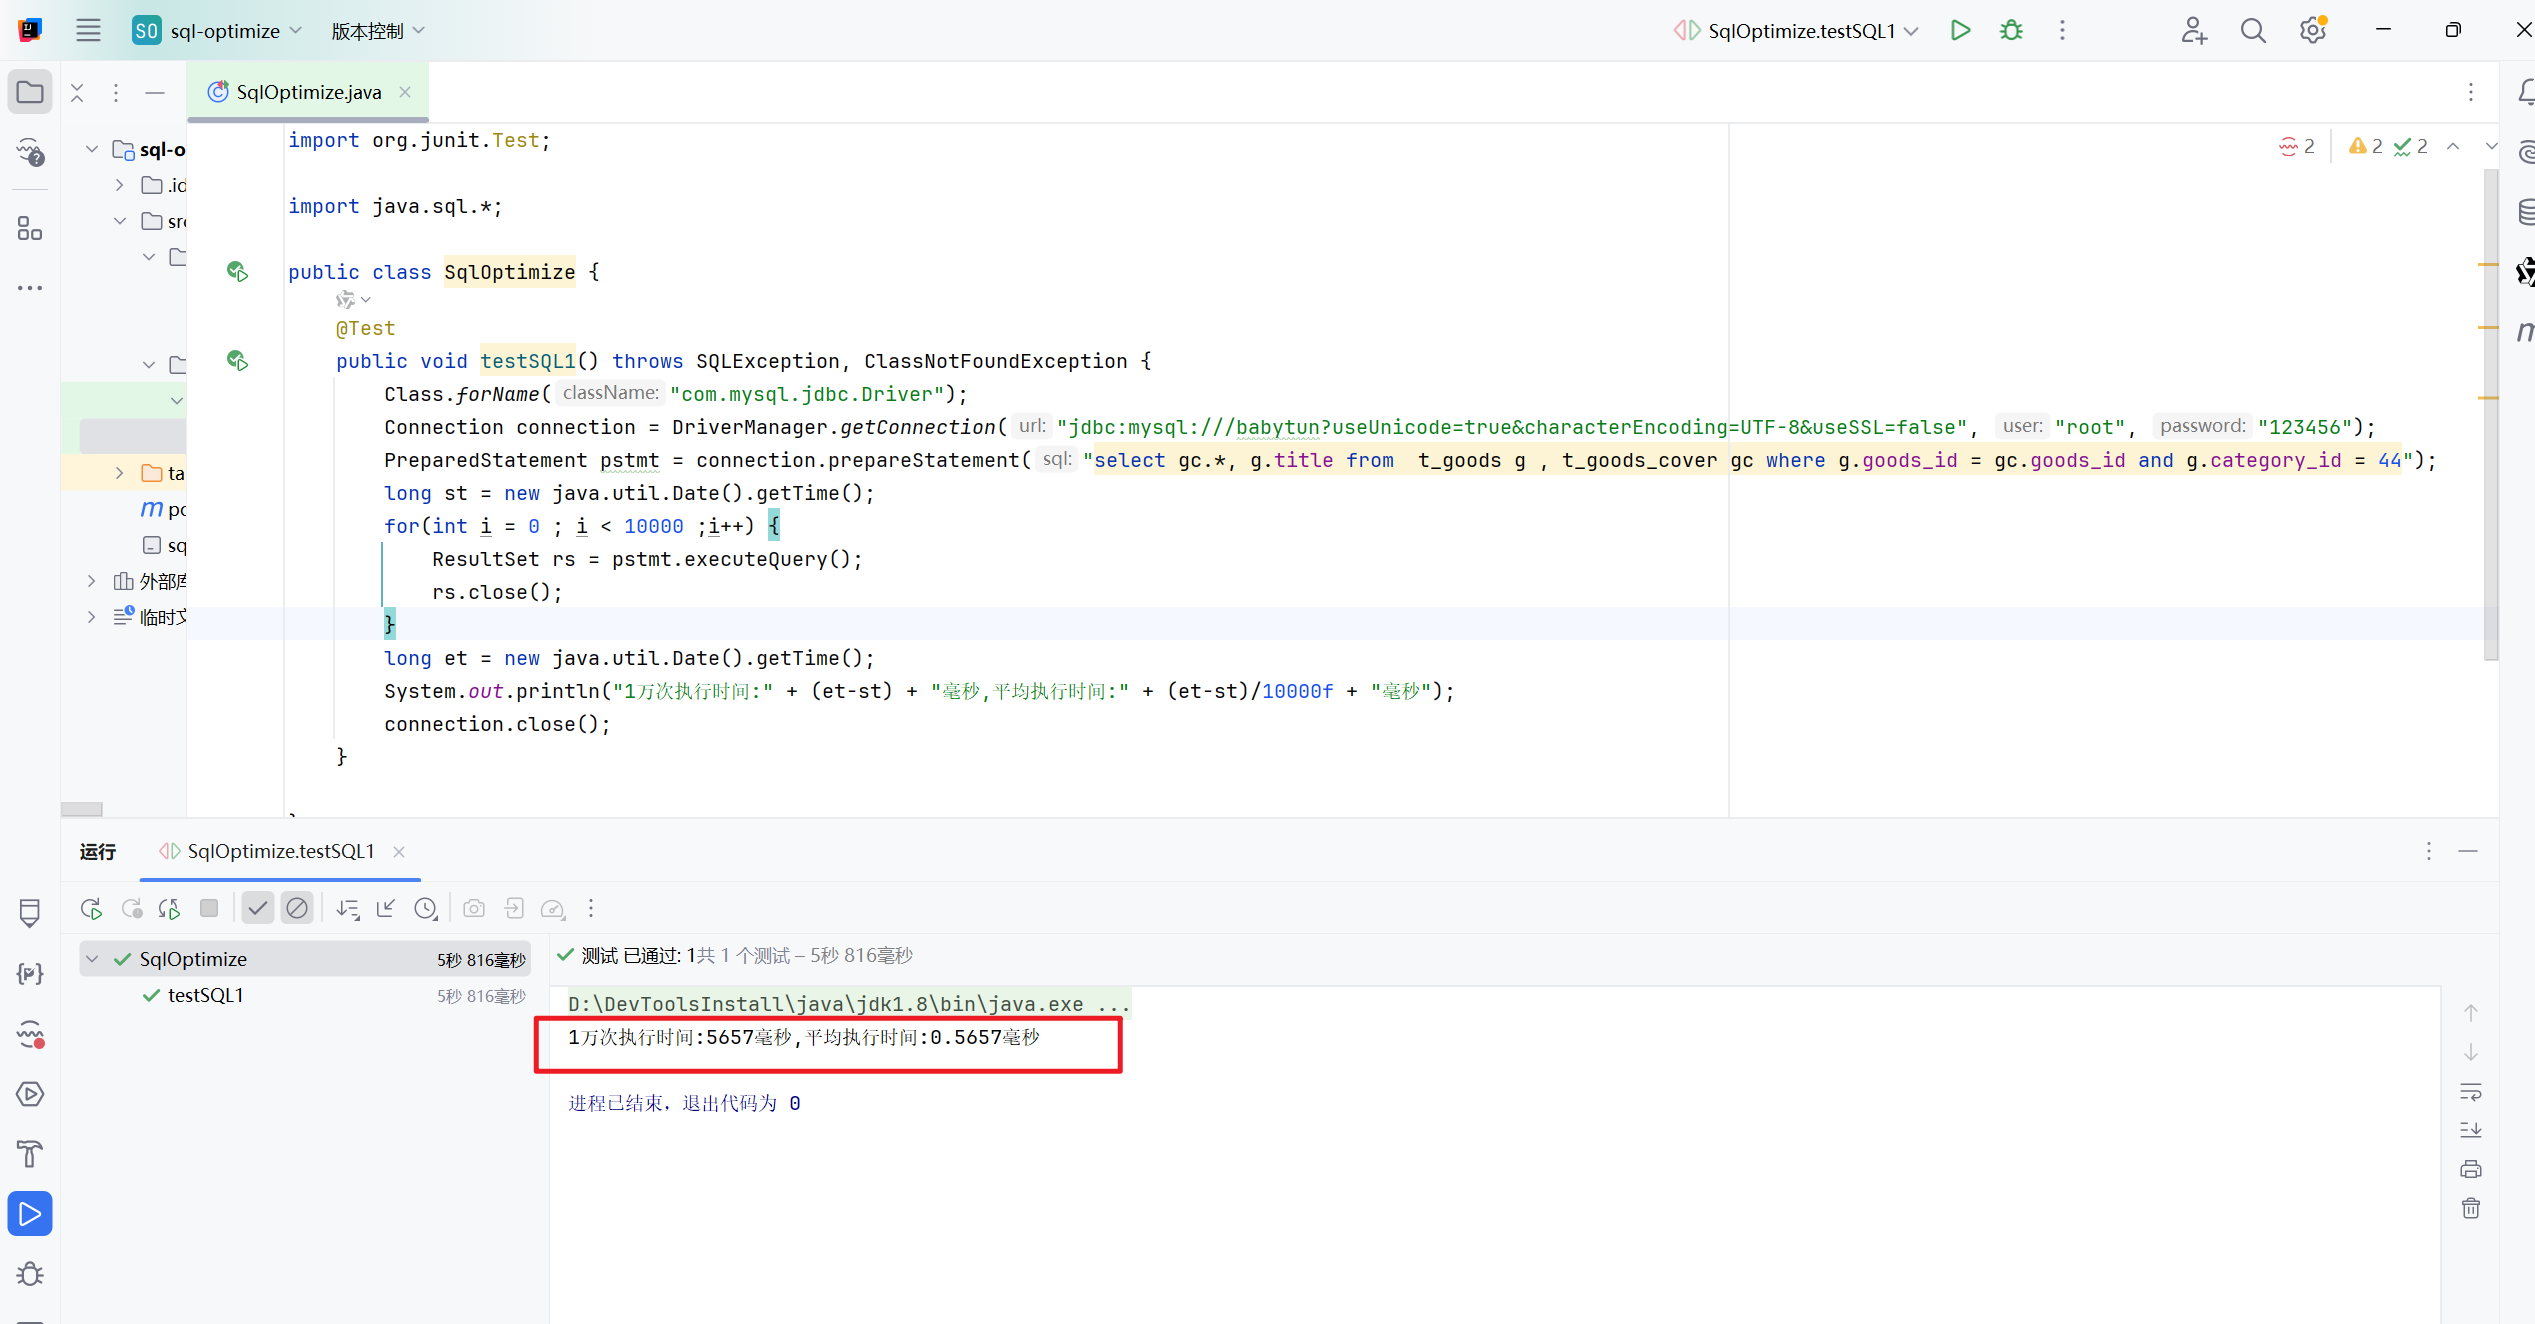
添加两个索引后,平均每次0.5毫秒。平均查询速度提升了8倍。
更多关于索引的使用,数据库的优化技巧,参考下面文章: