Qwen1/2/2.5/3 VL的图像处理与位置编码方式讲解

Qwen2 VL visual encoder

Qwen2 VL中在patch size的基础上还会通过MLP 做一个2*2的merge,进一步减小viusal token输,并加上start 和 end token。
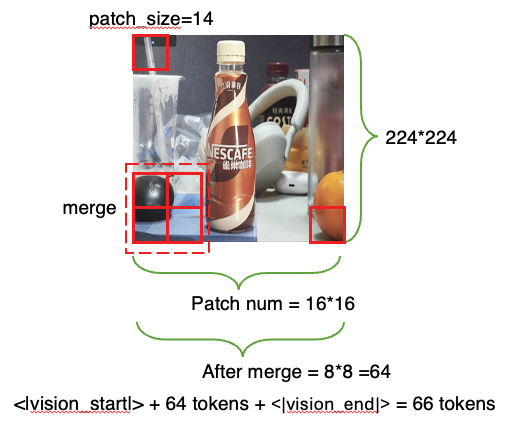
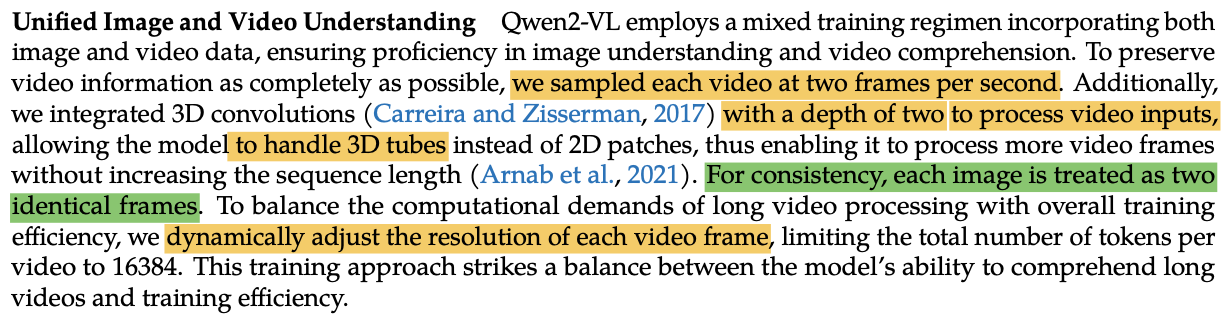
注意:在Qwen2VL以及Qwen2.5/3VL中,单张图像都是视为2张同样的帧作为输入的,因此在通过image_processor时,一个patch的pixel shape是14*14*3(RGB)* 2(视为相同2帧)= 1176
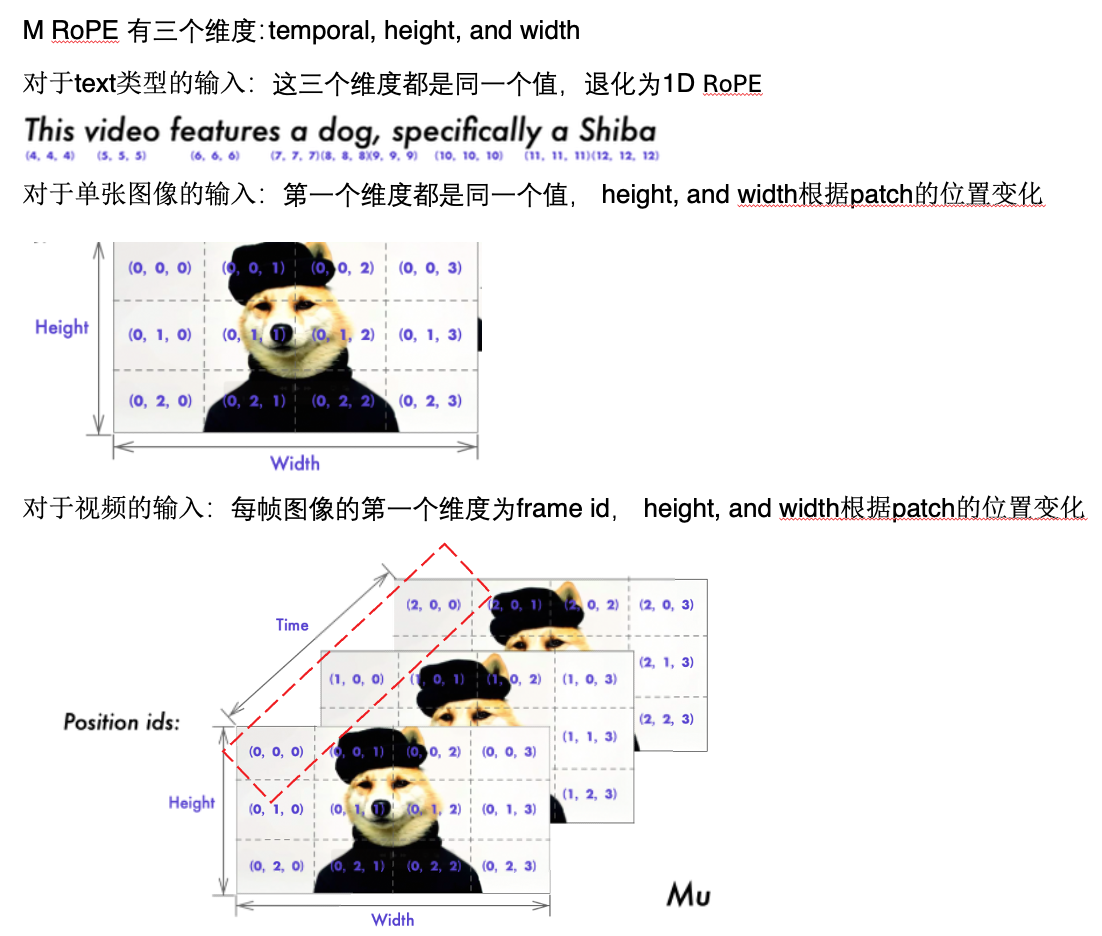
M-RoPE: MultimodalRotaryPositionEmbedding
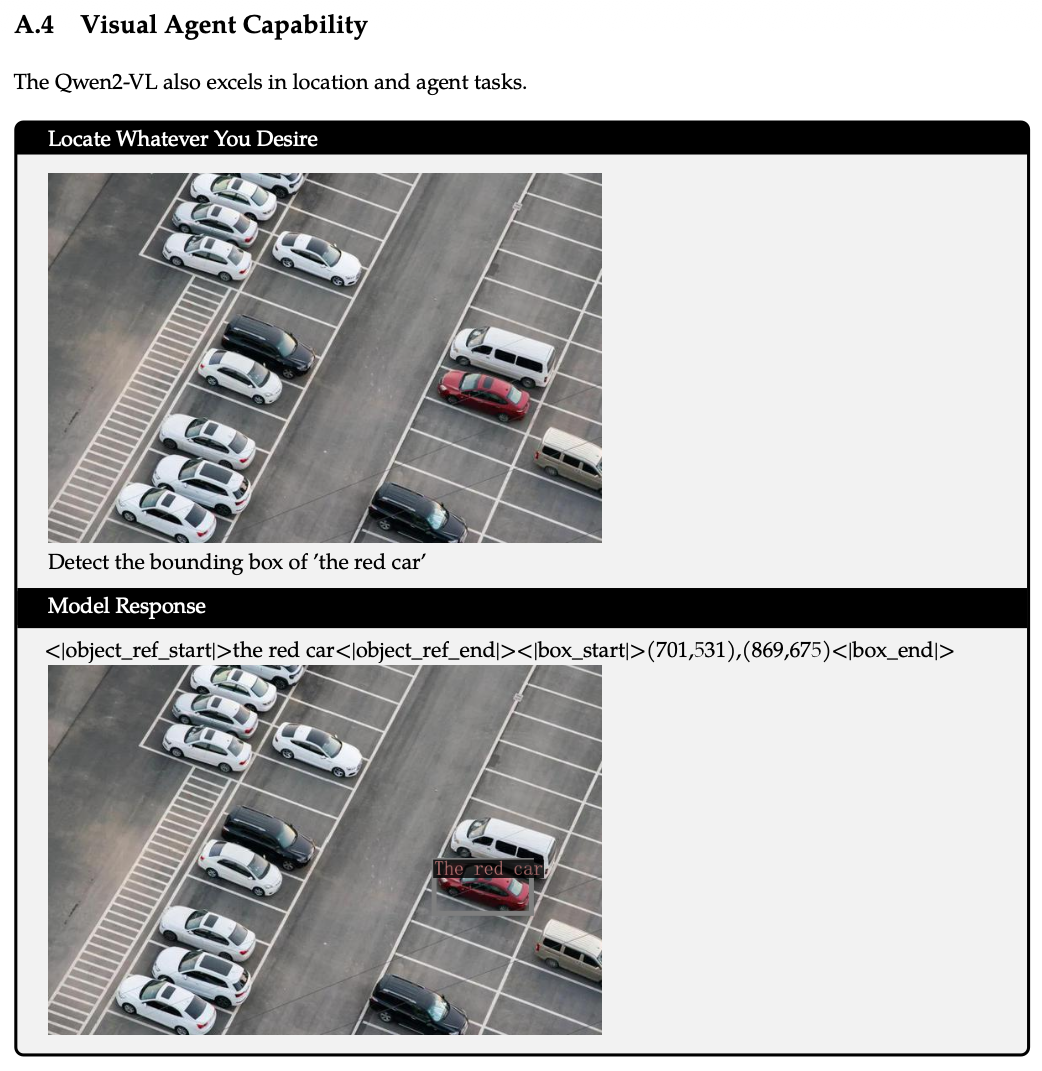
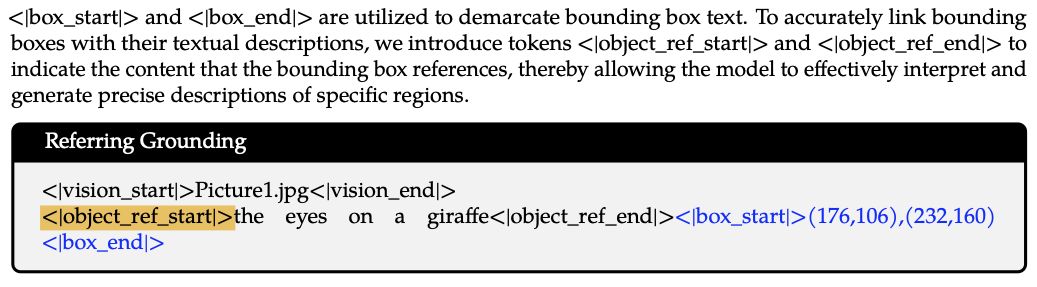
Qwen2 VL做2D grounding还是采取的类似Qwen1 VL的特殊token的表示形式:
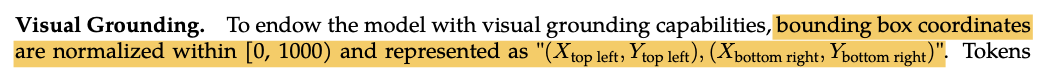
Qwen1 VL visual encoder

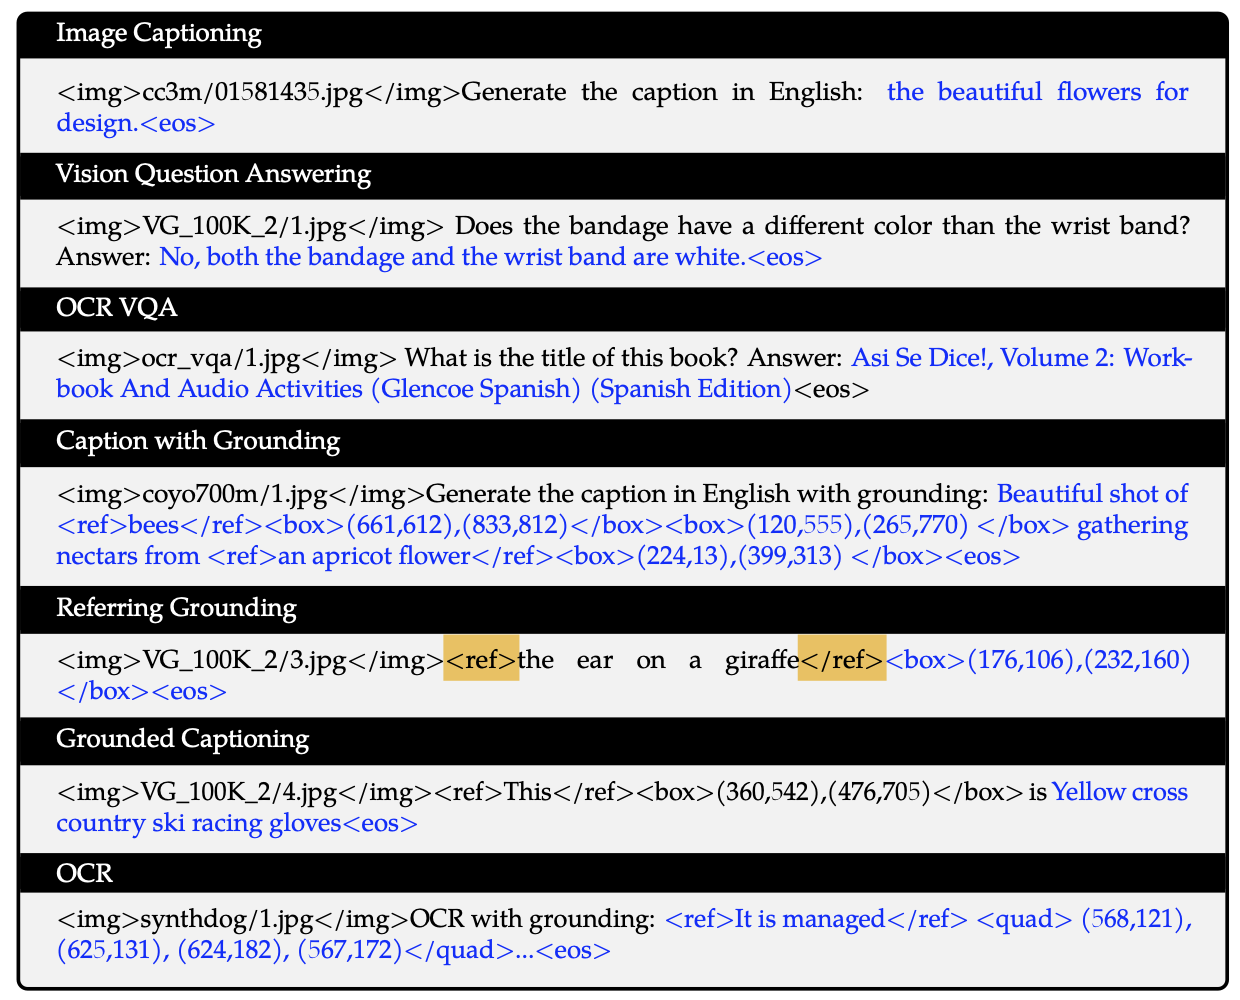
Qwen1 VL的visual encoder 其实是一个Q -former的架构,通过256个可学习的token来表示图像,并且这个版本中还不支持视频输入。只支持输出2D normaliezd 的bbox。范围是归一化到0,1000的图像grid空间。表示方式是文本,并通过<ref> ,和<box>的方式指代物体和对应的box。
相关推荐
jianpeng的工程笔记2 天前
Qwen-Image-2.1 图像编辑拆解:从透明改字到多图合成
人工智能·qwen·图像生成·comfyui
Zhu7582 天前
docker环境,vLLM 部署 Qwen3.8-27B
docker·qwen·vllm
空 白II3 天前
9.20 大语言模型研究简报:Qwen Code v0.24.1从 Coding Agent 走向统一 Agent Runtime
大语言模型·qwen
咬代码的兽5 天前
Qwen3.8-Omni-Flash 发布:1M 上下文 + 原生全模态,四步跑通音视频 API
人工智能·大模型·api·qwen
程序猿编码6 天前
不用 GPU!RK3588 跑视觉大模型,Qwen3.5-2B VLM 端侧落地
大模型·llm·rk3588·qwen·推理·vlm
赋创小助手6 天前
Qwen3.8-27B 本地推理 Benchmark 解析:llama.cpp、vLLM、SGLang 与长 Context 的性能差异
服务器·人工智能·大模型·qwen·vllm·sglang·context长度
论文复现现场6 天前
Llama/Qwen 70B 部署需要几张 RTX 4090?2卡、4卡、8卡显存、量化与 vLLM 选型
llama·qwen·vllm·大模型推理·大模型部署·rtx4090
程序猿编码7 天前
扔掉 vLLM!从零构建 Qwen3-8B 推理引擎,C++/CUDA 实现性能追平 98%
大模型·qwen·推理
程序猿编码9 天前
两张 3090 扛 27B:Qwen3.8-27B 大模型 DFlash2 加速版生产级落地
开发语言·gpt·深度学习·神经网络·大模型·qwen
java_logo11 天前
Claude 遭大规模「蒸馏」?过去 8 个月,AI 行业另一场战争被摊开了
人工智能·claude·qwen·ai 安全·kimi·模型蒸馏·anthropic