强化学习基础概念----状态、动作、策略、奖励

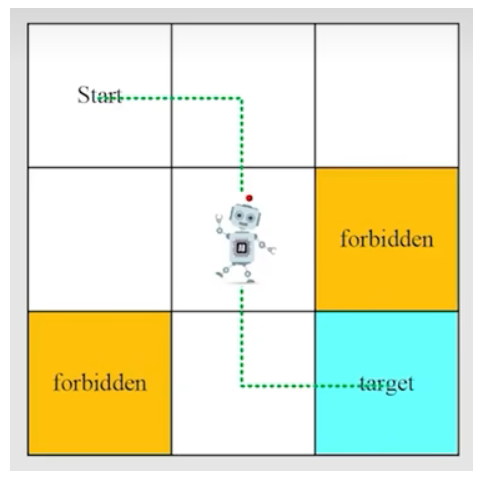
状态:智能体相对环境的状态 如:s1

状态空间:也就是所有的状态和 记作 S={s1,s2....s9}

动作:s1->s2,这个行为就是动作 上下左右保持不动等5个动作

动作空间: 不同状态下的不同动作的总和 如 s1 的动作空间为 As1=它可以执行的动作

状态转移:意思是状态经过动作后进入下一个状态,可以记做 s1----a2--->s2

策略:
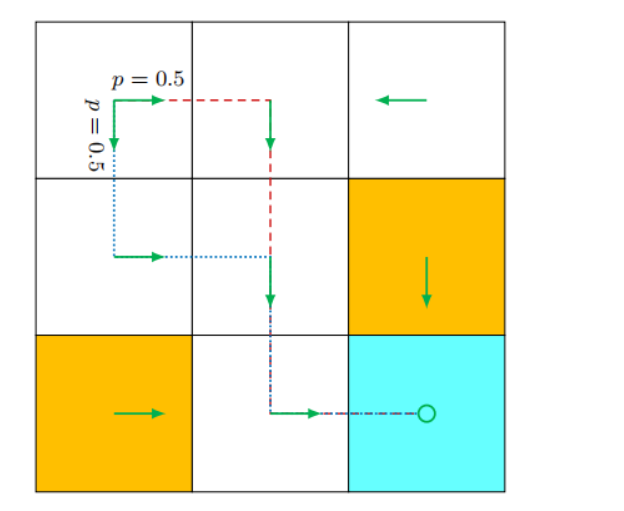
策略:整个表格 各个状态 动作的 整体条件概率
专业说法 强化学习术语 :"策略 π 可以表示为一个状态-动作值表(或矩阵),其元素 π(a|s) 定义了在状态 s 下选择动作 a 的概率。"
奖励:

在网格世界的例子中,奖励设计如下:

  • 如果智能体试图越过边界,设 rboundary=−1。
  • 如果智能体试图进入禁止的格子,设 rforbidden=−1。
  • 如果智能体到达目标状态,设 rtarget=+1。
  • 否则,智能体获得 rother=0 的奖励。

在某个状态执行一个动作后,智能体获得一个奖励(记为 r)作为来自环境的反馈。奖励是状态 s 和动作 a 的函数。因此,它也记为 r(s,a)。它的值可以是正数、负数或零。不同的奖励对智能体最终学到的策略有不同的影响。一般来说,通过正奖励,我们鼓励智能体采取相应的动作。通过负奖励,我们阻止智能体采取该动作。

在某个状态执行一个动作后,智能体获得一个奖励(记为 r)作为来自环境的反馈

相关推荐
秦禹辰几秒前
ClipSketch AI把视频改造成图文漫画:选关键帧、生成手绘分镜、融合IP形象并自动写小红书文案
人工智能·tcp/ip·音视频
梦想出海-Phoebe1 分钟前
ChatGPT 2026年10月更新汇总:GPT-6.1 Terra、AI短信助手与新功能解析
人工智能·chatgpt
乌恩大侠3 分钟前
从纳秒级同步到厘米级定位:基于 NVIDIA Aerial、SRS 与多 O-RU 的 5G/6G UL-TDOA 实现原理与工程实践
人工智能·5g·o-ru·ai-ran
霸道流氓气质5 分钟前
智能表单生成器:结构化输出契约、JSON Schema 驱动渲染与 EAV/JSONB 混合存储的 Vue3 + Spring AI 生产级实战
人工智能·spring·json
威哥爱编程15 分钟前
Python 智能体开发实战 03:聊十轮就“失忆”,账单还翻倍?管好上下文,Token 立省一半
python·agent
情 九15 分钟前
MCP 开发环境搭建:Mac 与 Windows 跑通 Python 服务和 stdio 客户端
windows·python·macos·mcp
lpfasd12317 分钟前
Mac mini M6(24GB)本地大模型部署实战:选型考量、踩坑记录与全链路搭建
人工智能
SEO_juper22 分钟前
Bash 交叉验证 robots.txt 和 sitemap:两个文件自相矛盾,页面永远收录不了
开发语言·python·node.js·json·bash
云上工程笔记27 分钟前
2026年如何保障Token传输过程中的数据安全与隐私?加密、脱敏、审计与权限指南
人工智能
2601_9707038327 分钟前
工业除湿机选型与安全使用研究报告:把铭牌数字放回工况里
大数据·人工智能