文章目录
提示词链模式:Prompt Chaining
也被叫做管道模式。
其核心思想是:将原始的复杂问题分解为一系列更小、更易管理的子问题。每个子问题通过专门设计的提示词单独处理,并且一个提示词的输出会作为输入传递给链中的下一个提示词。
我们在构建复杂AI Agent的时候最好不要采用单一提示词,单一提示词的局限性很大,可能会导致:
- 指令忽略(提示词的某些部分被忽视)
- 上下文漂移(模型失去对上下文的跟踪)
- 错误传播(早起错误被放大)
- 需要更长上下文窗口(模型获得的信息不足无法响应)以及幻觉(认知负荷增加导致错误信息的可能性)
顺序分解增强
先说一个例子:
一个要求分析市场分析研究报告、总结、发现、识别带数据点的趋势并起草电子邮件的查询。
对于上面这个例子,提示词链通过将这个复杂任务分解为聚焦的顺序工作流来解决它。用链式方法可以这样描述:
- 初始化提示词(总结):"总结以下市场分析研究报告的主要发现:文本。" 模型的唯一焦点是总结,提高了这一初始化步骤的准确性。
- 第二个提示词(趋势识别):"使用摘要,识别前三个新兴趋势并提取支持每个趋势的具体数据点:步骤1的输出。"此提示词现在更受约束,并直接建立在经验验证的输出之上。
- 第三个提示词(电子邮件撰写):"向营销团队起草一封简明的电子邮件,概述以下趋势及其支持数据:步骤2的输出。"
这种对任务的分解允许对流程进行更精细的控制。每一步都简单明了清晰,这样减少了模型的认知负荷,可以让输出的结果更准确。
这种模块化类似计算管道,其中每一个函数在执行特定操作后将结果传递给下一个。
为了确保每个特定任务的准确性,可以在每个阶段为模型分配不同的角色。例如在给定的场景中,初始化提示词的时候可以指定:市场分析室;后续提示词为"贸易分析师";第三个提示词为"专家文档撰写者",以此类推。
结构化输出
我们上面说到,提示词要在每个环节之前传递,这个传递得靠谱才行。我们要让他靠谱,最好应用json格式去传递这个数据:
运用领域
提示词链是一种多用途模式,在构建Agent对话系统的时候运用的场景特别多:
- 信息处理工作流(总结文档、提取关键实体、然后使用这些实体查询数据库生成报告)
- 自动化内容分析
- AI驱动的研究助手
- 复杂报告生成
- 复杂查询回答
- 数据提取和转换
- 从表单、发票、电子邮件非结构化来源进行数据提取和分析
- OCR识别、PDF表单
- 创意叙事、技术文档、其他形式结构化文档内容自动创作
- 代码生成和完善工具
- 多模态推理
- 解释包含嵌入文本的图片、突出显示文本的的标签、解释每个标签的表格数据的图像。
实际代码
如何使用Langchain库处理文本?
我们可以选择用两个独立的提示词来实现:
- 提示词1:一个从输入字符串中提取技术规格
- 提示词2:从这些技术规格中转换为json对象
我们使用大语言模型交互,配合StrOutputParser确保输出为可用的字符串格式。
python
import os
from typing import final

from langchain_community.chat_models import ChatTongyi
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate


os.environ["DASHSCOPE_API_KEY"] = "sk-xxx"#换成你自己的
##初始化语言模型
llm = ChatTongyi(model="qwen-turbo-2025-04-28")
## 提示词1:提取信息
prompt_extract = ChatPromptTemplate.from_template(
    "从以下文本中提取技术规格:\n\n{text_input}"
)

## 提示词2:转换为json
prompt_transform = ChatPromptTemplate.from_template(
    "将以下规格转换为json对象,使用CPU、memory和storage作为键:\n\n{specifications}"
)
##使用LCEL构建链
extraction_chain = prompt_extract | llm | StrOutputParser()
##完整的链将提取链的输出传递到转换提示词的"specifications"变量中
full_chain=(
    {"specifications":extraction_chain}
    | prompt_transform
    | llm
    | StrOutputParser()
)
##运行链
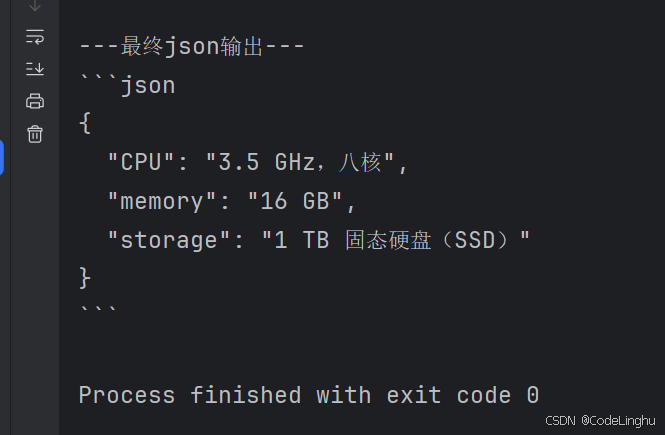
input_text="新款笔记本电脑型号配备3.5GHZ,八核处理器、16GB内存和1TB固态硬盘。"
##使用输入文本字典执行链
final_result = full_chain.invoke({"text_input":input_text})

print("\n---最终json输出---")
print(final_result)