目录
[1. 理论](#1. 理论)
[1.1 Embedding 模型:文字的「数字身份证」](#1.1 Embedding 模型:文字的「数字身份证」)
[1.2 Reranker 模型:结果的「智能排序员」](#1.2 Reranker 模型:结果的「智能排序员」)
[1.3 Embedding 和 Reranker 的关系](#1.3 Embedding 和 Reranker 的关系)
[2. 部署](#2. 部署)
[2.1 vllm](#2.1 vllm)
[2.2 sglang](#2.2 sglang)
主要是rag用的比较多,先把内容换成向量然后使用排序模型提高召回率
1. 理论
1.1 Embedding 模型:文字的「数字身份证」
作用:把文字(词、句子)转换成计算机能理解的「数字坐标」,就像给每个文字画一张地图上的定位点。
使用场景:
- 搜索:比如搜「猫」,Embedding 会找到「猫咪」「小猫」甚至「橘猫」等相近词(就像地图上离得近的点)。
- 推荐系统:推荐和你看过的电影「类型相似」的影片(比如科幻→科幻,而不是爱情片)。
- 聚类分析:把用户评论自动分成「好评」「差评」两类(相近的评论聚在一起)。
比喻 :
想象你去图书馆找「关于狗的书」,Embedding 就像图书管理员,快速把所有和「狗」相关的书(比如训犬、宠物护理)都搬到你的面前,但顺序可能杂乱。
1.2 Reranker 模型:结果的「智能排序员」
作用:对初步筛选的结果重新排序,把最相关的内容排到最前面。
使用场景:
- 问答系统:从 100 条答案中,挑出最直接回答「如何做蛋炒饭」的那几条。
- 搜索引擎:搜「苹果」,把「水果苹果」排在前面,而不是「苹果手机」(根据上下文调整)。
- 推荐系统:在 20 部科幻片中,把评分最高、最近热门的排到推荐列表顶部。
比喻 :
接着图书馆的例子,Reranker 就像另一个细心的管理员,把搬过来的书按「评分高低」「出版时间」「借阅次数」重新整理,让你第一眼看到最符合需求的书。
1.3 Embedding 和 Reranker 的关系
- 分工合作 :
- Embedding 先「大海捞针」(快速找到相关结果)。
- Reranker 再「精益求精」(对结果精细排序)。
- 结合使用 :
- 比如电商搜索:Embedding 找到所有「运动鞋」,Reranker 按「价格、销量、品牌」排序。
- 智能客服:Embedding 匹配用户问题到知识库,Reranker 选出最准确的回答。
类比 :
就像选餐厅:Embedding 帮你找到「附近所有川菜馆」,Reranker 再按「评分、人均价格、距离」排出前 5 名
2. 部署
ollama没什么说的,直接搜索run就可以了
https://ollama.com/search?c=embedding
2.1 vllm
启动示例
bash
#Embedding
vllm serve /mnt/Qwen3-Embedding-8B/ \
--tensor-parallel-size 2 \
--pipeline-parallel-size 1 \
--trust-remote-code \
--enable-chunked-prefill \
--host 0.0.0.0
bash
#Reranker
vllm serve /mnt/Qwen3-Reranker-0.6B/ --hf_overrides '{"architectures": ["Qwen3ForSequenceClassification"],"classifier_from_token": ["no", "yes"],"is_original_qwen3_reranker": true}'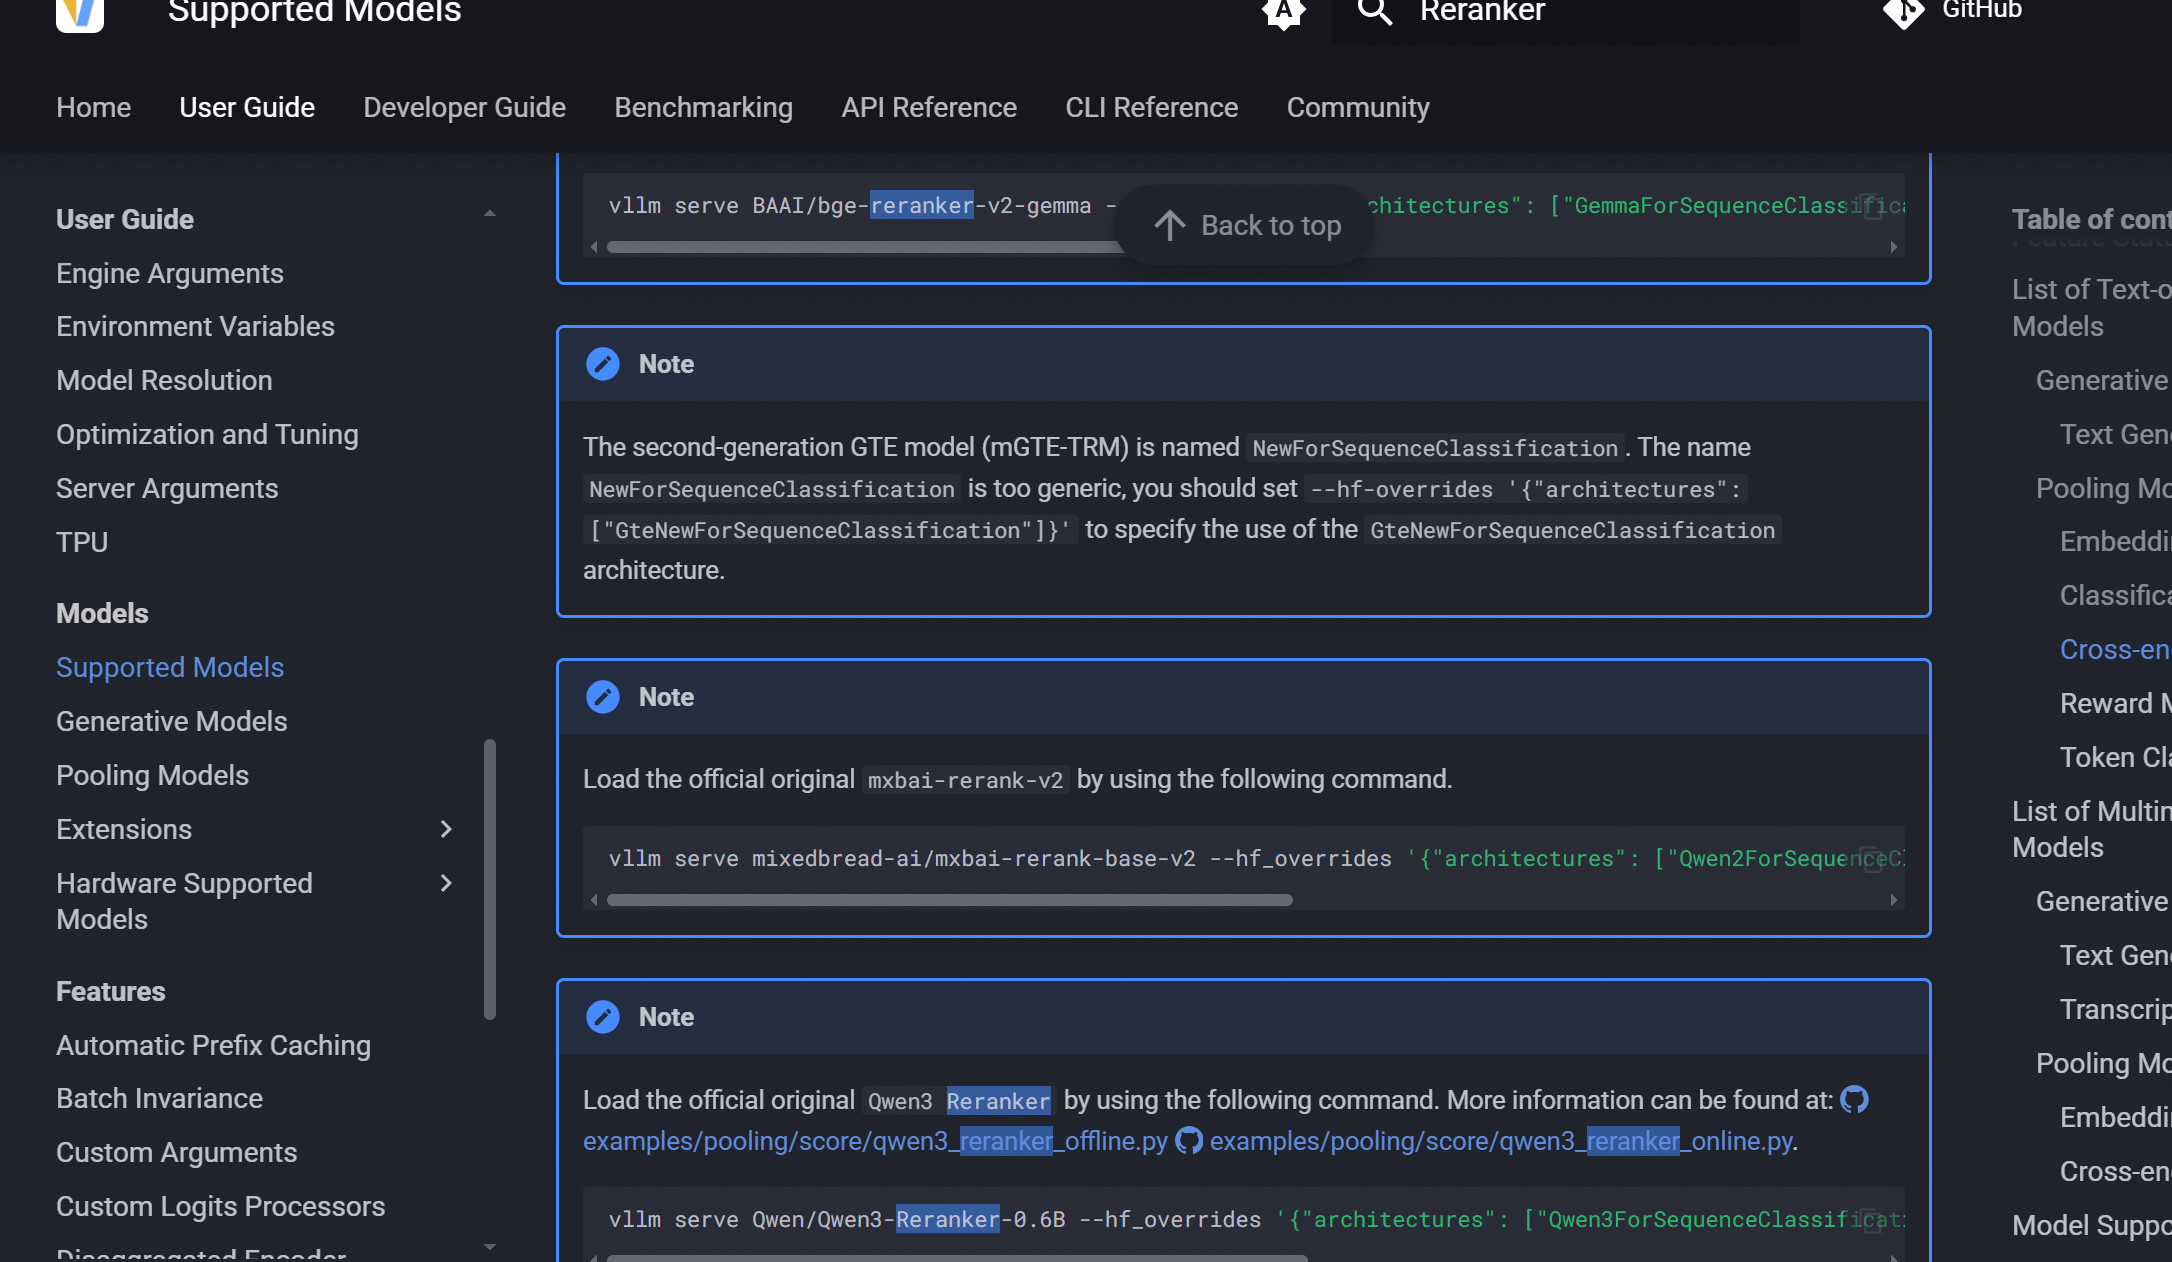
https://docs.vllm.ai/en/latest/models/supported_models/?h=reranker#cross-encoder-reranker
Benchmark 示例
bash
#vllm必须是0.11.0以上版本
vllm bench serve \
  --model /mnt/Qwen3-Embedding-8B/ \
  --backend openai-embeddings \
  --endpoint /v1/embeddings \
  --dataset-name sharegpt \
  --num_prompts 1000 \
  --host 127.0.0.1 --port 8000 \
  --dataset-path /root/ShareGPT_V3_unfiltered_cleaned_split.json
https://docs.vllm.ai/en/latest/benchmarking/cli/?h=reranker#text-embeddings
2.2 sglang
Embedding 支持的模型列表
https://docs.sglang.io/supported_models/embedding_models.html#supported-models
bash
python3 -m sglang.launch_server \
  --model-path Qwen/Qwen3-Embedding-4B \
  --is-embedding \
  --host 0.0.0.0 \
  --port 30000
Reranker 支持的模型列表
https://docs.sglang.io/supported_models/rerank_models.html
bash
python3 -m sglang.launch_server \
  --model-path BAAI/bge-reranker-v2-m3 \
  --host 0.0.0.0 \
  --disable-radix-cache \
  --chunked-prefill-size -1 \
  --attention-backend triton \
  --is-embedding \
  --port 30000
llm可以参考