一、前言
在得物(Poizon)业务场景中,算法生态已演进为涵盖交易搜索、社区推荐、图像识别及广告策略的多维复杂系统。请求从Java网关下发,进入 C++ 构建的高性能算法核心(DSearch检索、DGraph图计算、DFeature特征提取等)。
随着系统复杂度的指数级增长,我们对现有系统的可观测性进行了全面梳理,为了提高稳定性,我们希望建设一个业务场景维度全链路变更事件中心, 以"聚焦做好可观测性"为核心目标,通过建设监控平台的事件中心与全链路可观测的核心产品,整合各平台资源与数据,提升系统的整体透明度和稳定性,从而提升业务稳定性和故障止血效率,为产品迭代奠定坚实的基础。
二、可观测性的"四大支柱"与联动愿景
在业界,可观测性通常被定义为Trace、Metric和Log三位一体。我们的目标是打造一套 "以场景为魂,以联动为骨" 的可观测体系,打破数据孤岛,实现算法治理的智能化转型。提出了 "四大支柱联动":
- Trace为径: 超越单纯的拓扑记录。通过Baggage机制,将复杂的业务语义与算法策略注入链路,实现调用流与业务流的深度耦合。
- Metric为脉: 通过Trace自动生成场景化的性能指标。并结合元数据关联服务端业务指标,实现指标间的联动。
- Log为证: 推动全链路日志格式化治理。规范异常码和业务码。
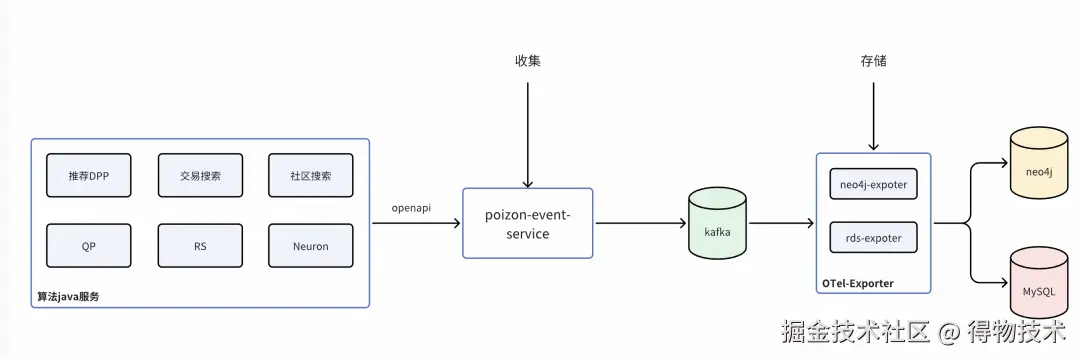
- Event为源: 算法系统的灵魂在于演进。打通算法侧10+个变更平台, 将日均上万+的变更事件实时映射至链路拓扑。
三、核心攻坚:可观测性标准化
Trace标准化
在得物算法生态中,DMerge、DScatter、DGraph、DSearch、DFeature等核心组件承载着极致的性能诉求。由于C++侧Trace SDK的长期缺失,算法服务曾处于微服务观测体系的"孤岛",难以与上下游实现全链路串联。
C++ Trace2.0(得物分布式链路追踪Trace2.0基于OpenTelemetry二次开发,目前已经支持Java/Go/JS/Python语言)并没有基于OpenTelemetry CPP进行二次开发主要考虑以下几点:
- 极致性能与可控开销要求: C++侧服务位于请求链路关键路径,对RT与尾延迟极其敏感,需要对Span创建、上下文传播、属性写入 等操作进行严格的CPU与内存开销控制,并对内存分配、锁竞争及线程切换具备严格可控性。相比之下,OpenTelemetry C++ SDK更偏向通用性与标准完备性, 其抽象层次与扩展点在部分高QPS场景下存在不可忽略的性能不确定性。
- 原生SDK行为不透明带来的工程风险: OpenTelemetry C++ SDK 内部实现较为复杂,可能包含隐式线程、后台任务或复杂生命周期管理,在极端并发或异常场景下的问题定位与边界控制成本较高,而对源码完整评估的成本同样高昂。
- brpc+bthread运行模型的兼容性担忧: C++ 服务大量基于brpc与bthread用户态调度模型,若SDK内部依赖pthread或引入额外系统线程,可能影响bthread worker的调度行为,存在运行时的兼容风险。
- 工程依赖与符号冲突风险(尤其是Protobuf): 现有工程依赖特定版本的protobuf,而OpenTelemetry C++ SDK对其依赖栈有独立版本要求,在静态或混合链接场景下存在符号泄漏与ABI冲突风险,整体工程稳定性不可控。
SDK框架
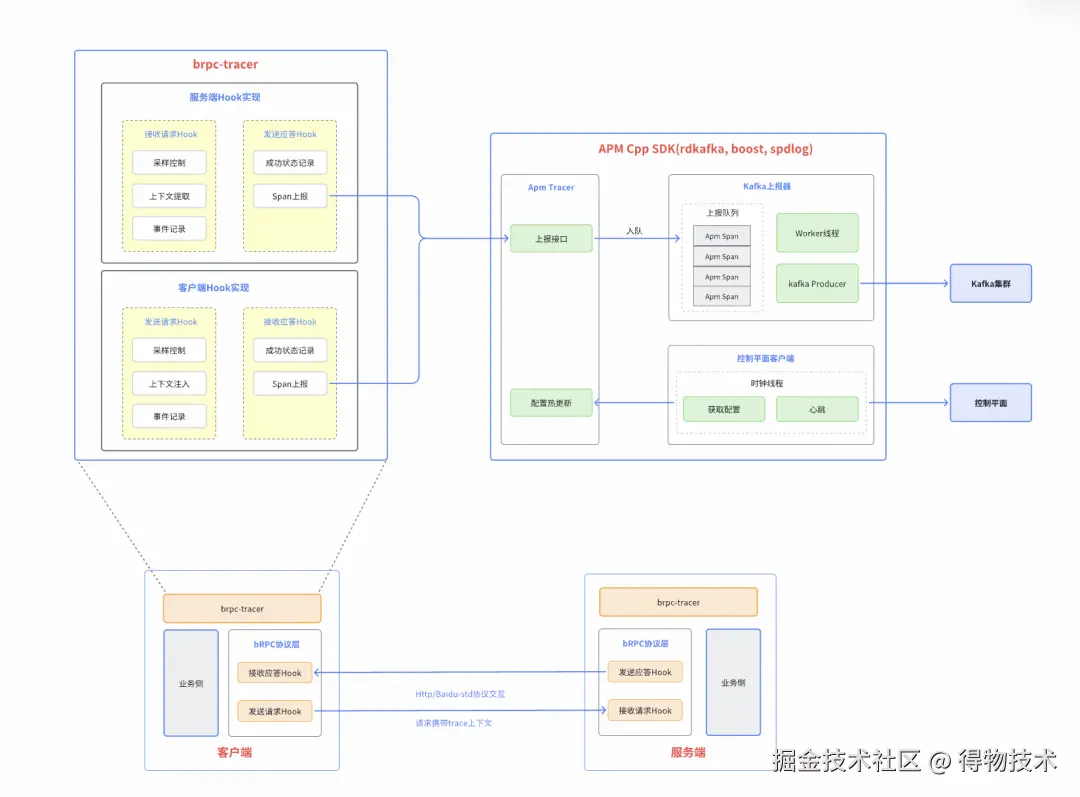
- APM Cpp SDK: 实现Span的创建、采集和上报,同时与控制平面对接实现心跳和配置热更新,基于kafka上报Trace。
- brpc-tracer: brpc框架适配层,支持http与baidu-std协议的自动上报探针。
- 引擎接入: 业务侧通过依赖brpc-tracer,支持链路上报。
报文压缩方案
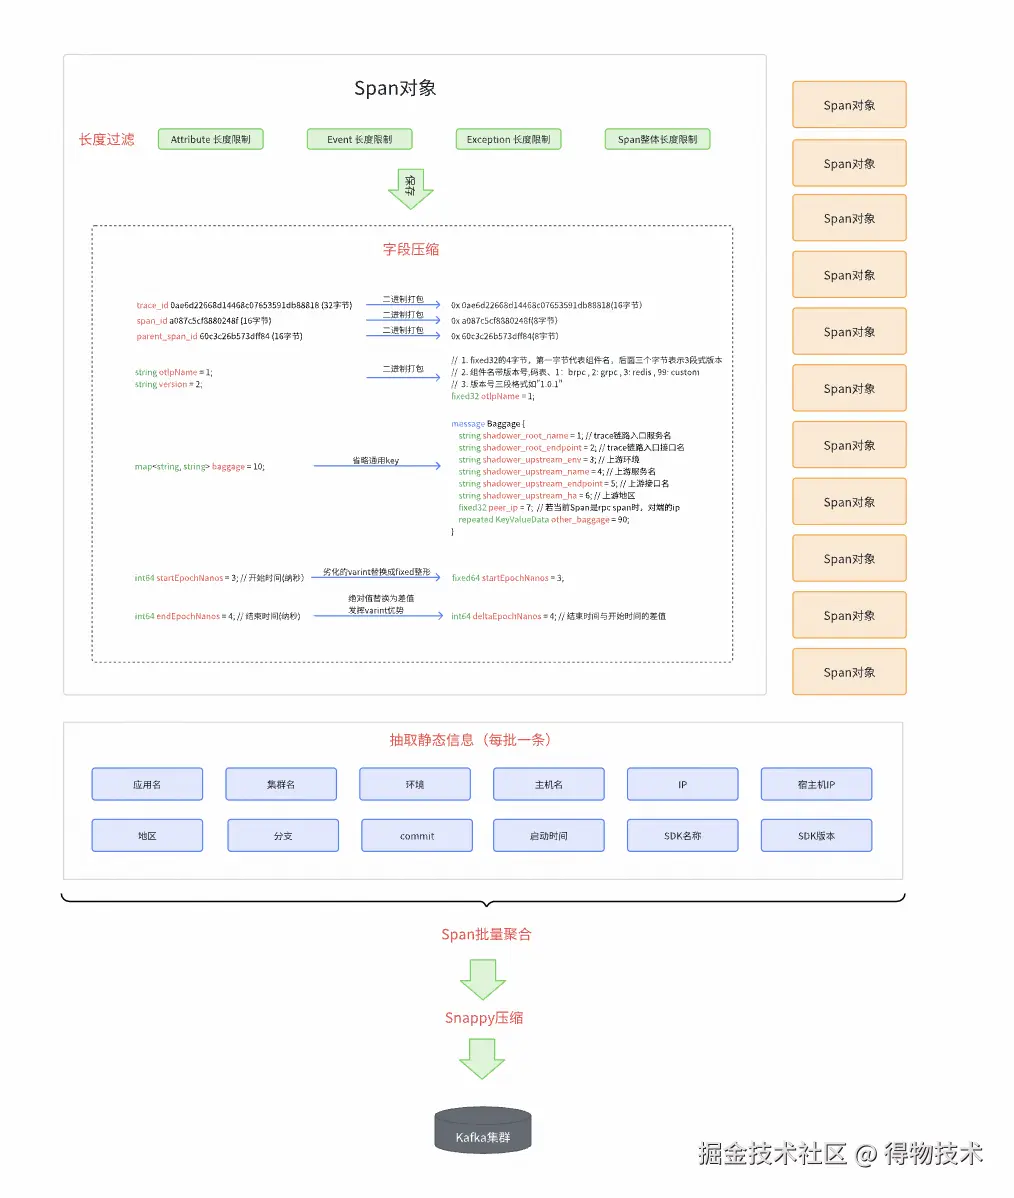
通过对报文进行压缩,显著降低Trace上报过程中的带宽消耗,减少链路数据与业务请求在带宽上的竞争,避免对正常请求响应时延产生干扰,保障业务服务稳定性。
压缩策略:
长度过滤: 对写的属性、事件、异常进行key、value长度限制,对Span的整体进行长度限制,超出阈值部分进行截断,阈值实现了控制平面的动态更新。
字段压缩: 尽可能的对协议中的所有字段进行了压缩,例如,16进制字符串打包为2进制,通用字段省略key,通过差值替代结束时间等。
批量聚合: 将多条Span进行合并,作为一条报文进行上报,增加吞吐量的同时,减少kafka集群和带宽压力。聚合阈值也实现了控制平面动态更新。
静态信息抽取: 对进程级别的静态信息从Span对象中剥离,每个聚合报文只添加一个静态信息副本。
Snappy压缩: 先对聚合后的消息序列化,再进行Snappy压缩,经验压缩比是30%左右。
异步上报和MPSC无锁环队列
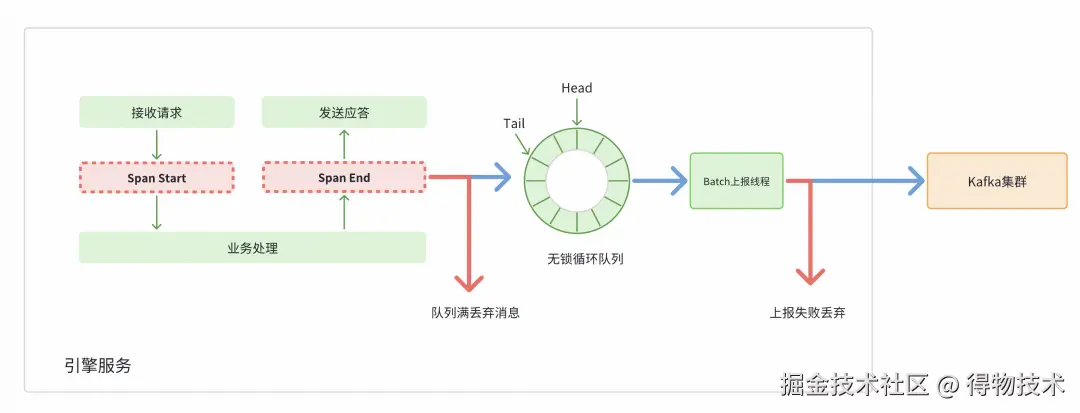
- 异步上报: Span采集后写入队列,由异步线程批量处理并投递至Kafka;当队列已满或上报失败时直接丢弃,避免阻塞业务线程及内存膨胀。
- MPSC无锁循环队列: MPSC是支持多生产者单消费者的无锁队列结构,利用循环数组实现高效数据传递。通过原子操作避免加锁,减少线程竞争带来的上下文切换和性能开销。在高并发场景下能提供更稳定的吞吐量和更低的延迟,保证队列操作的高效性和可预测性。
RPC探针
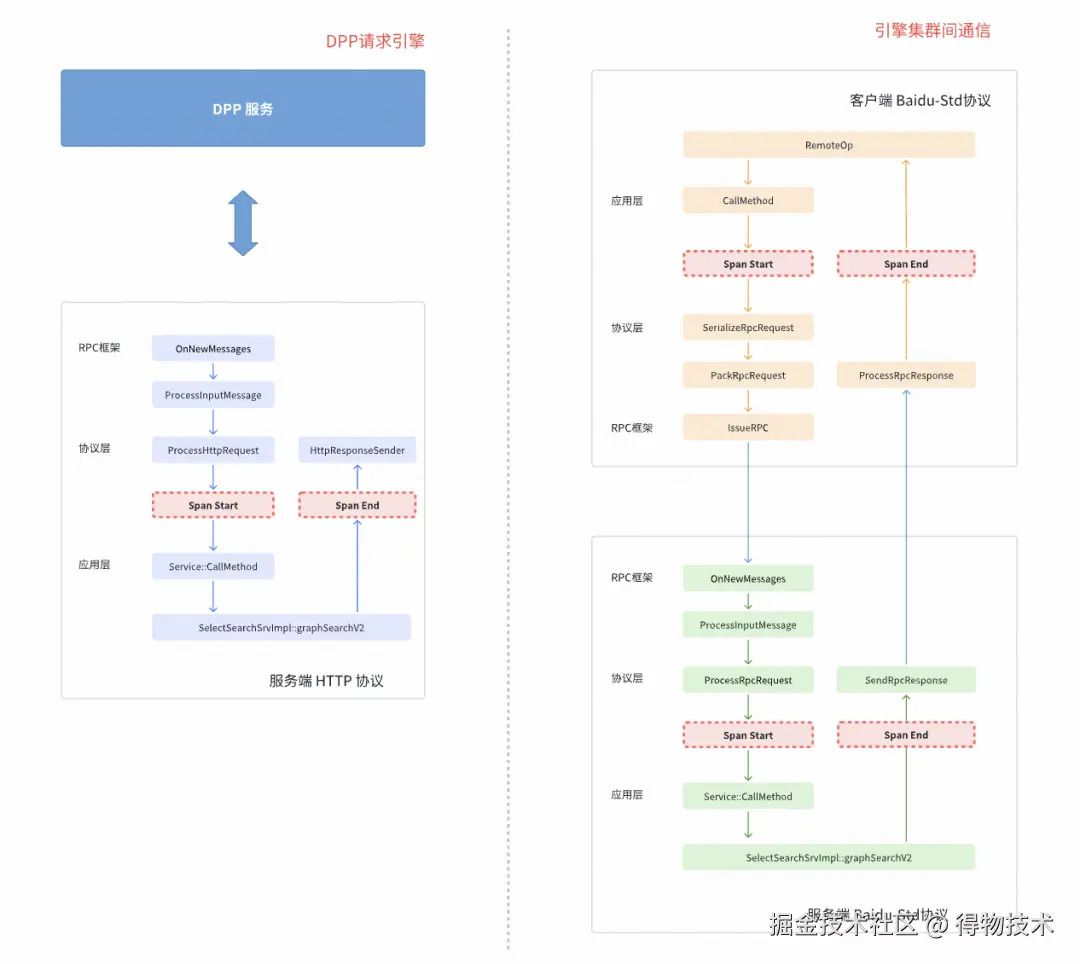
RPC 探针实现了在协议层对请求生命周期的统一感知与Trace自动化处理,支持BRpc客户端与服务端在无业务侵入的前提下完成Trace的自动采样与上报。
针对不同通信场景,在协议层引入统一的RPC探针,通过埋点回调对请求生命周期进行拦截,实现Trace的自动采样与埋点。
上线效果
- 支持trace_id链路查询。
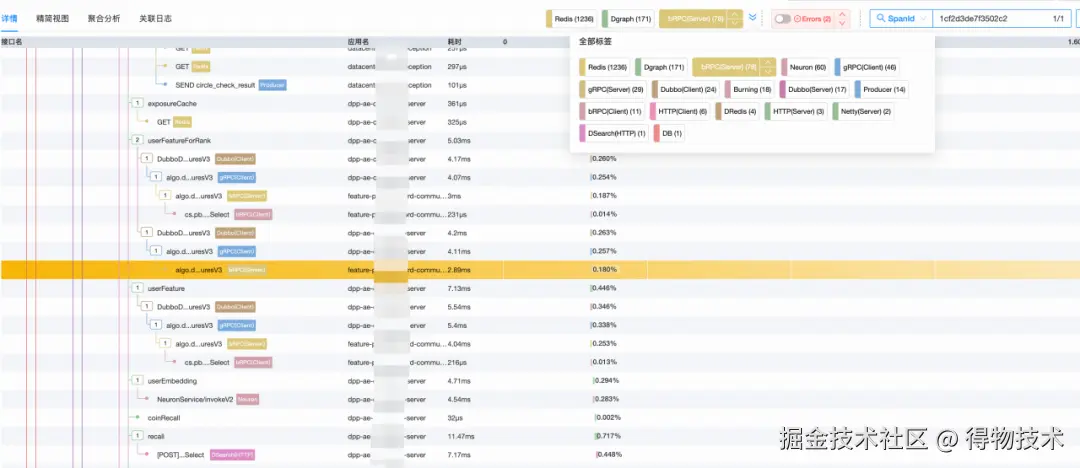
- 支持指标维度(异常,RT范围等)的链路查询。
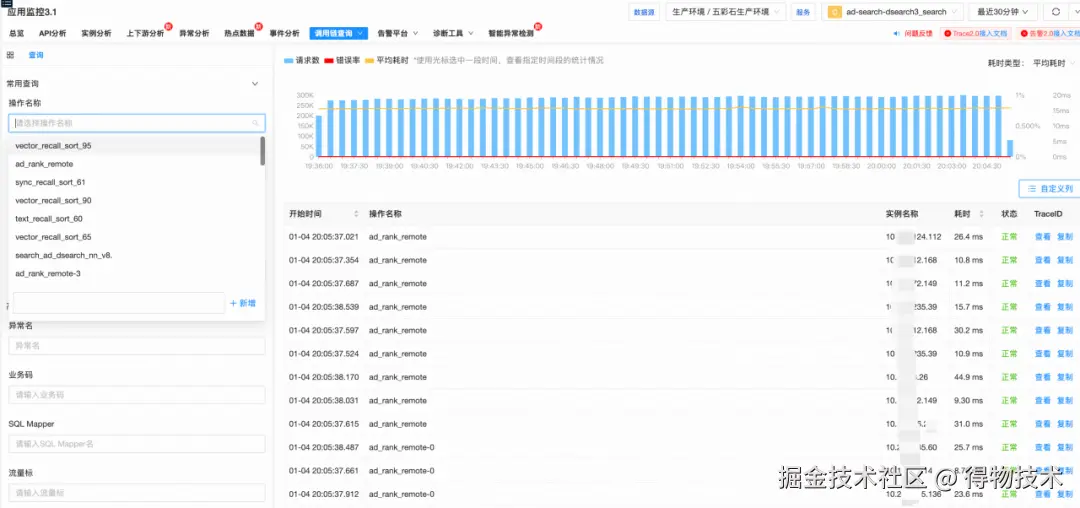
Log标准化
在全链路可观测体系中,日志是还原业务现场的最终证据。针对算法侧Java 侧规范、C++ 侧杂乱的现状,我们实施了深度对齐与语义重构。
- 跨语言语义对齐:以Java侧成熟的标准化日志为标杆,通过自研C++ Log SDK推行结构化日志协议。
- 业务语义锚定:在日志规范中首次引入了"场景 (Scene) + 异常码 (Error Code)"。
- 场景化建模: 将具体的业务上下文(如推荐、搜索)注入日志元数据,使日志具备了清晰的业务属性。
- 异常码标准化: 建立算法侧统一的错误字典,实现从"模糊描述"到"精确指纹"的跨越。
日志格式规范
1.统一文件名
lua
/logs/应用名/{应用名}-error.log- 文件目录在/logs/应用名/
- 统一文件名叫{应用名}-error.log,比如引擎的叫:doe-server-error.log
- 日志采集时按pattern: *-error.log采集
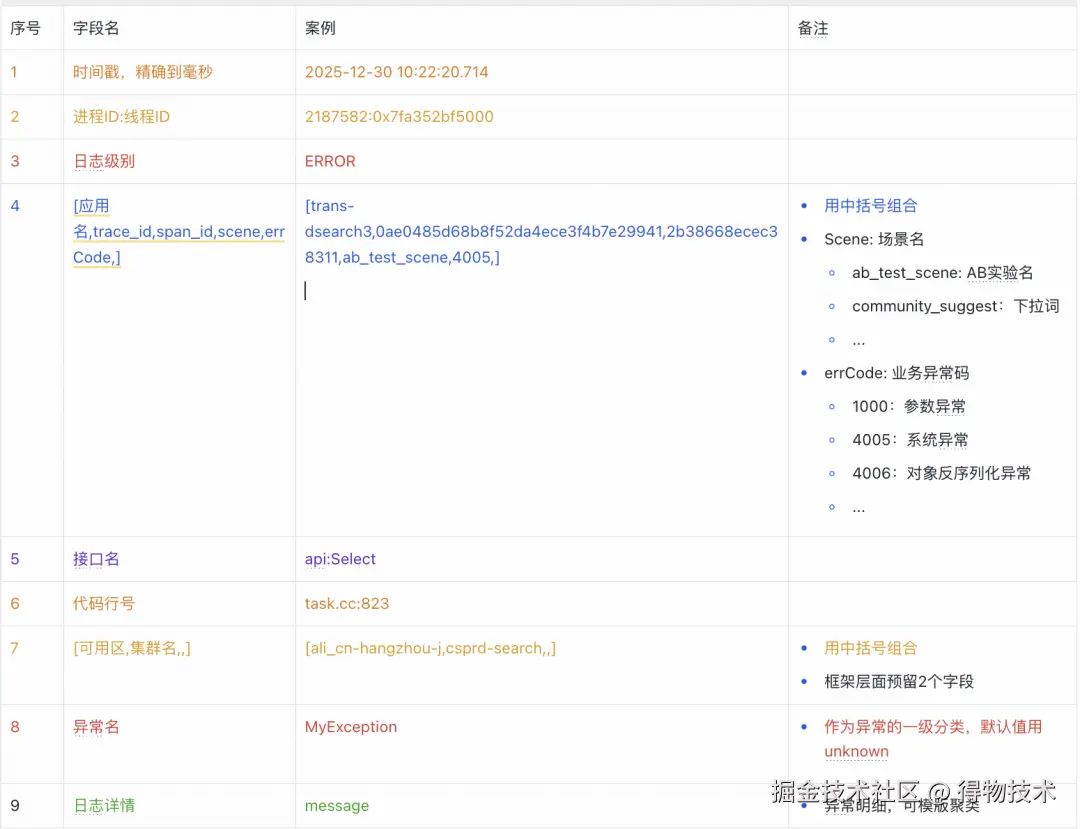
2.日志格式
- 按照竖线 "|"分隔符分隔
ini
时间戳|进程ID:线程ID|日志等级|[应用名,trace_id,span_id,scene,errCode,]|接口名|代码行号|[可用区,集群名,,]|异常名|message- 字段详细介绍
日志模板聚类算法
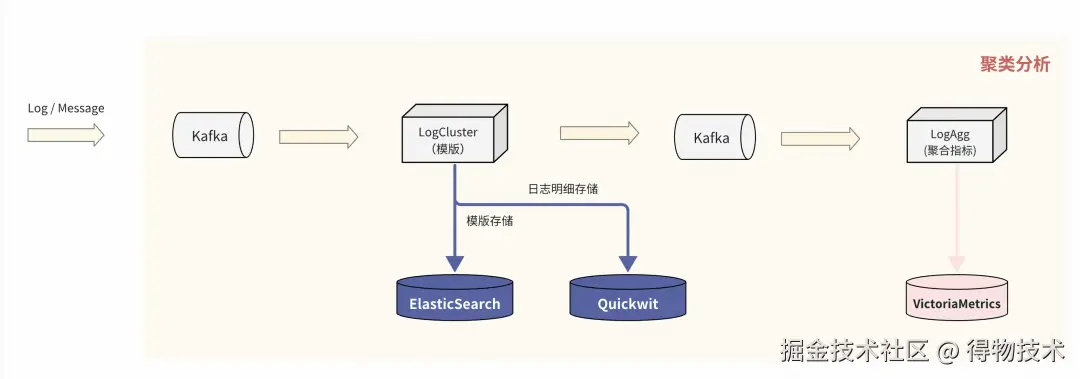
模板聚类流程
规则:以正则掩码+Drain解析树为基础
- 正则掩码: 通过正则对日志进行预处理,如时间,IP地址,数字,等等。例如"2025-12-01 10:20:30 ERROR host 10.0.1.2 connect timeout"经过正则掩码后,得到"<:TIME:> ERROR host <:IP:> connect timeout"
- Drain算法: Drain算法是一种用于处理日志数据的结构化分析算法,广泛应用于日志解析和日志模板抽取领域。它是一种基于层次聚类的在线日志解析算法,其主要目标是从原始日志中提取日志模板,从而将非结构化日志转换为半结构化数据格式,这有助于后续的日志分析、故障检测和系统监控。
Drain算法主要分为以下几个步骤
- 预处理
首先需要对日志进行预处理,包括前文的正则掩码,以减少冗余信息对解析的影响。另外,需要对日志进行分词,按空格和其他分割符划分为多个片段。
- drain解析树
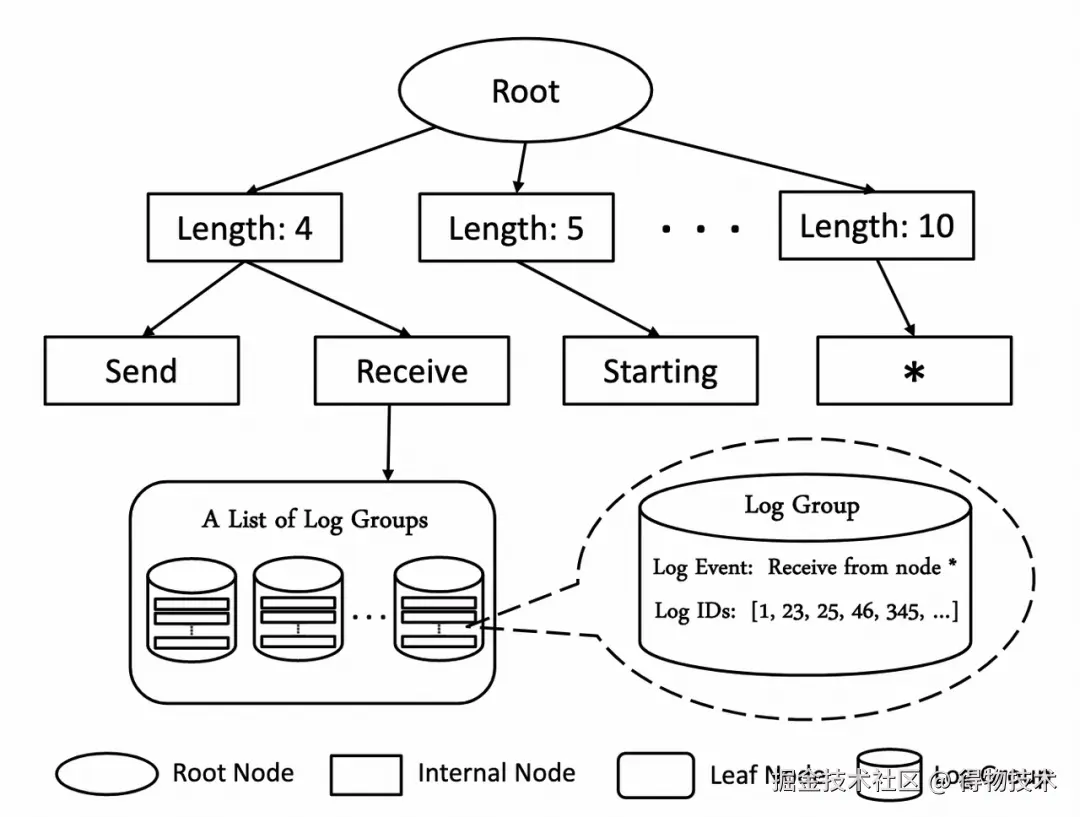
接下来构建了一种层次结构的树,称为parse tree,用于记录和组织日志消息。
- 在树的第一级节点,日志将会依据其长度(分词后片段数目)进行分类。不同长度的日志会被分配到不同的路径上。
- 然后在树的后续层级中,每一层级都尝试根据其他的静态关键字对日志消息进行进一步细化分类。
- 树的叶子节点为日志聚类桶,逐个遍历桶中的聚类,分别判断当前日志与对应日志聚类的相似度是否达到阈值,相似度算法为相同位置的相同token占token总数的比例。
- 如果相似则将判断当前的日志匹配该聚类,如果都不相似则创建新的聚类并加入桶中。
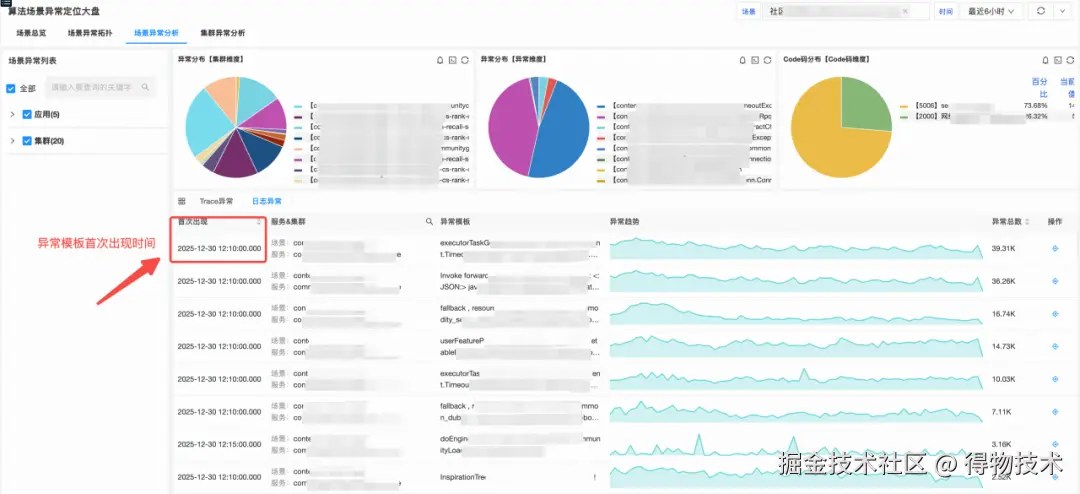
上线效果
日志模板聚类维度支持:应用名、集群名、异常名、code码、异常日志模版等。
四、以"场景"为魂:构建算法知识图谱
场景化建模 (AlgoScene)
在得物APP中,用户每一次搜索或进入社区频道,底层都会触发一次复杂的RPC调用流。流量在算法域内穿梭时,会经历多次不同"场景"算子的串行与并行计算,最终才将推荐结果反馈给客户端。正是由于这种调用路径极其复杂且具备高度的业务特性,我们决定打破传统的物理链路视角,转而以 "场景"为核心单元构建知识图谱。
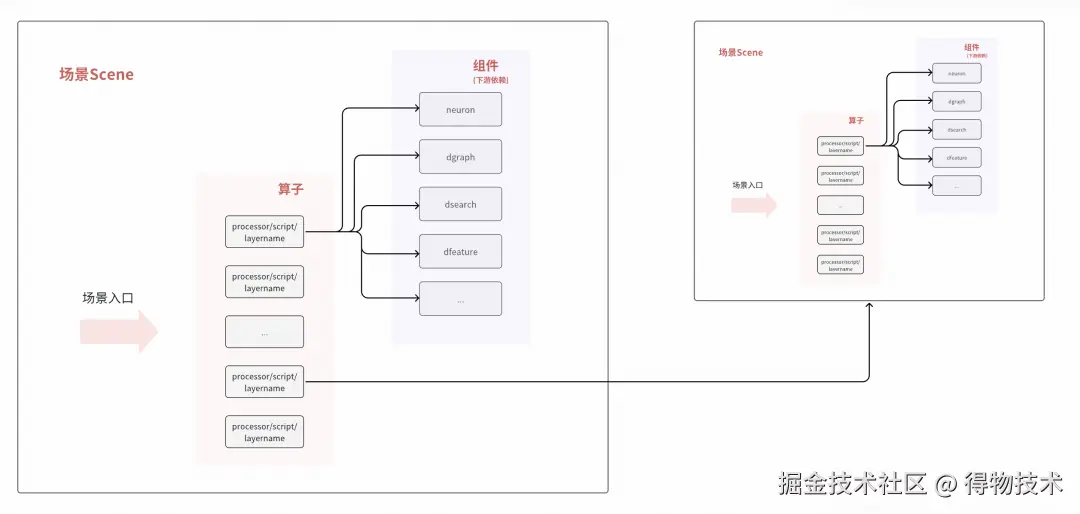
如图所示,
- 一个场景由多个算子组合
- 每个算子由0..多个组件构成
- 组件一般通过RPC(HTTP/GRPC/Dubbo/Redis/BRPC/场景)方式调用下
AlgoScene场景名
在确定以"场景"为核心的串联逻辑后,由于单次 RPC 调用往往横跨多个算法节点,我们必须实现对多场景动态链的支持。
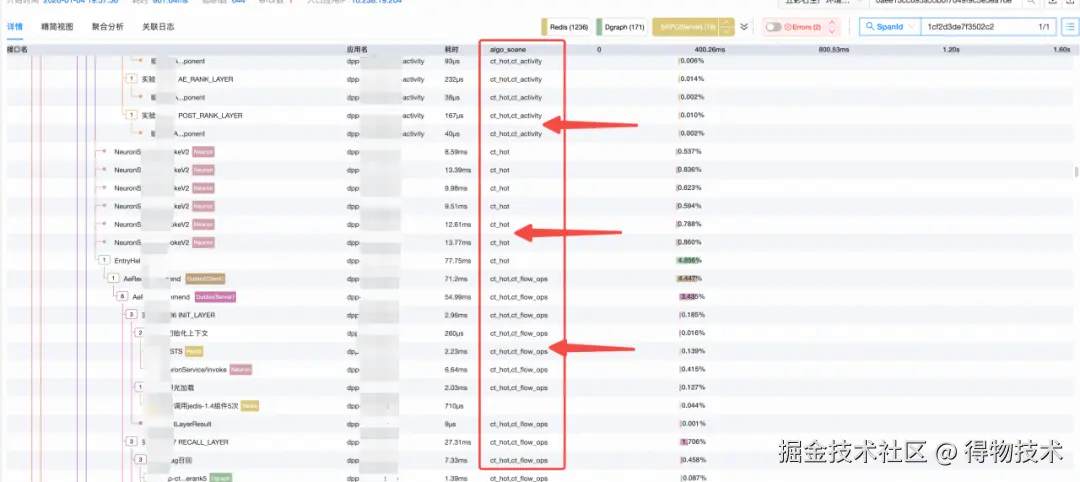
考虑到算法任务编排天然以场景为基本单元,我们通过在Trace SDK中封装putAlgoSceneToBaggage方法,利用Baggage机制将场景信息透传至全链路。在每个服务的场景入口处,只需通过以下代码即可实现场景上下文的注入,确保全链路中的每个Span都能自动携带algo_scene字段:
ini
Context ctx = AlgoBaggageOperator.putAlgoSceneToBaggage("trans_product");
try (Scope scope = ctx.activate()) {
    // 业务逻辑执行
}在数据清洗阶段,我们通过对algo_scene字段进行逗号切分,解析出完整的场景路径链:
- algoScene: 记录全链路经过的所有场景名(逗号分隔)。
- rootScene: 切分后的第一个场景名,代表流量进入算法域的原始触发源。
- currentScene: 切分后的最后一个场景名,代表当前节点所属的具体算子场景。
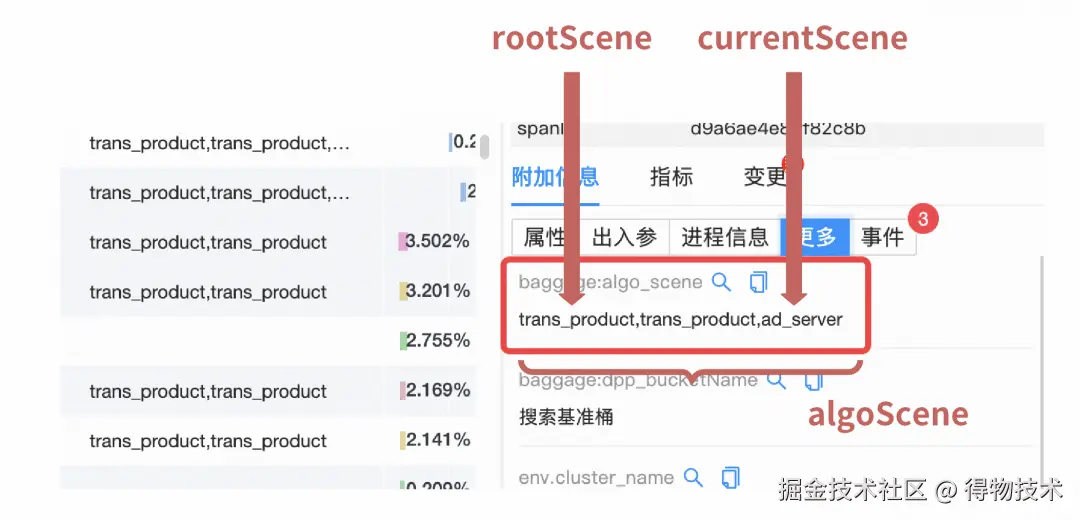
最终Trace效果
传播链"Baggage" VS "InnerBaggage"
Baggage 是OpenTelemetry观测标准中的一个核心组件。如果说TraceID是用来串联整个调用链的"身份证",那么Baggage就像是随身携带的"行李箱"。
它允许开发人员在整个请求链路中携带自定义的键值对(Key-Value Pairs)。 这些数据会随着HTTP Header或RPC元数据在各个微服务之间自动"漂流",确保下游服务能够感知上游传递的业务上下文。
核心原理
Baggage是基于HTTP Header协议实现的。根据W3C标准,它会将数据存放在名为baggage的Header中进行透传:
- 格式: baggage: algoScene=recommend_v1,isTest=true
- 传播方式: 自动随请求从Service A流转至Service B、C,无需在每个服务的业务代码中手动添加参数。
底层实现
如何将baggage信息应用到每个span呢?我们增强了spanProcessor代码如下:
ini
Baggage baggage = Baggage.fromContext(parentContext);
baggage.forEach((s, baggageEntry) -> {
    if (s.startsWith(OTEL_TO_SPAN_BAGGAGE_PREFIX)) {
        String value = baggageEntry.getValue();
        if (value == null) {
            value = NULL_VALUE;
        } else if (value.isEmpty()) {
            value = EMPTY_VALUE;
        }
        span.setAttribute("baggage:" + s.substring(OTEL_TO_SPAN_BAGGAGE_PREFIX.length()), value);
    }
});
InnerBaggage
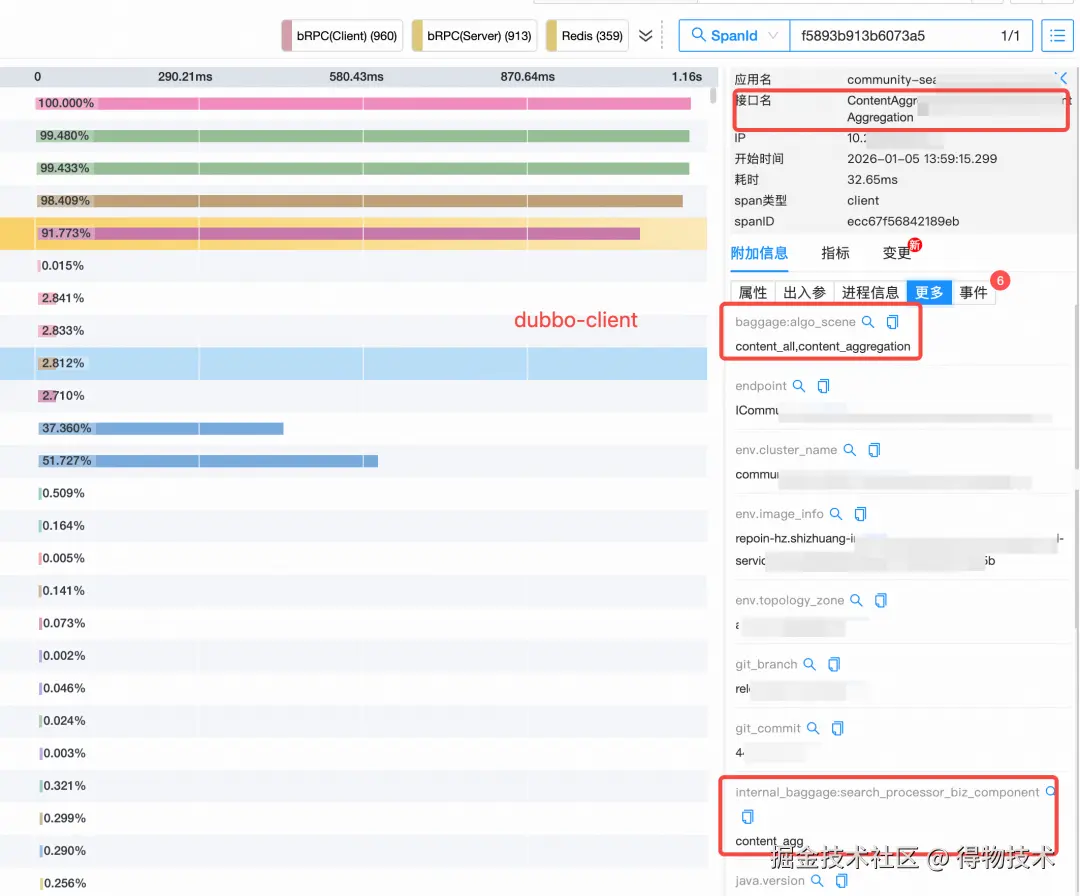
在全链路追踪中,如果说Baggage解决了服务之间的跨站传递,确保业务信息能跨越机器送达下游;那么InnerBaggage则负责服务内部的进程传递,确保在同一个进程里,无论业务逻辑经过多少个组件,当前的"算子名"等信息都能自动同步到每一个执行步骤中,无需在代码里层层手动传递参数。
示例
csharp
// 在算子入口处,定义一个 InnerBaggage 作用域
try (Scope ignored = InnerBaggage.with("search_processor_biz_component", "content_agg")) {
    // 这里的逻辑无论是调用数据库还是计算,生成的 Span 都会自动带上 search_processor_biz_component=content_agg
    runComponentLogic();
}
// 作用域结束,InnerBaggage 自动清理,防止污染下一个算子
最终效果
一个远程Dubbo-client被成功标记algo_scene和业务算子名"content_agg"。
动态元数据与流式计算
配置中心元数据
在复杂的算法场景中,由于变更频率极高,硬编码显然无法满足需求,我们构建了一套基于配置中心的动态元数据订阅体系。
- 建立"应用-配置集"订阅关系
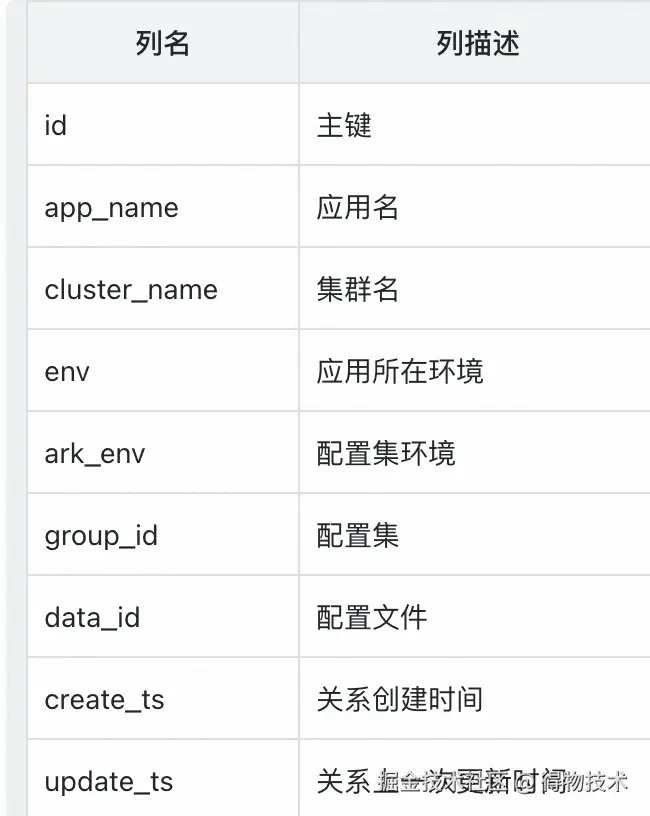
- 元数据模型定义
为了支撑应用与配置之间的多对多关系,我们设计了如下核心表结构,用于记录订阅逻辑与元数据画像:
场景拓扑图 (Neo4j)
在完成业务侧的全链路埋点后,后端数据清洗层负责将海量的原始Trace数据进行结构化处理:它实时解析并提取Baggage 中的全局场景信息与InnerBaggage中的局部算子标签,从而将离散的链路信息转化为标准化的业务计算流。
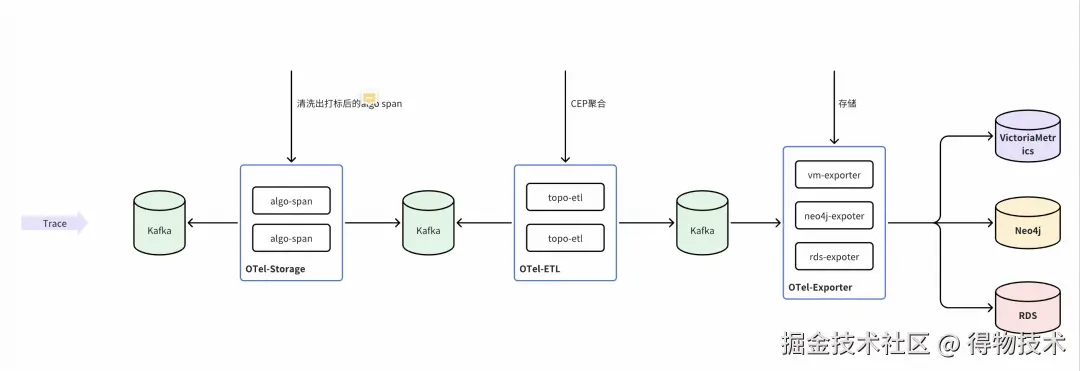
流式计算引擎
借助流式计算引擎强大的EPL能力,我们通过类SQL的声明式语法,精炼地实现了从实时多维聚合到复杂模式匹配的逻辑表达,目前已沉淀出12个覆盖核心业务场景的标准SQL算子,显著提升了实时数据处理的开发效率与灵活性。SQL示例如下:
less
@TimeWindow(10)
@Metric(name = 'algo_redis_client', tags = {'algoScene','rootScene','currentScene','props','env','clusterName','serviceName','redisUrl','statusCode'}, fields = {'timerCount', 'timerSum', 'timerMax'}, sampling='sampling')
SELECT algoScene                                as algoScene,
       rootScene                                as rootScene,
       currentScene                             as currentScene,
       get_value(origin.props)                  as props,
       env                                      as env,
       serviceName                              as serviceName,
       clusterName                              as clusterName,
       statusCode                               as statusCode,
       redisUrl                                 as redisUrl,
       trunc_sec(startTime, 10)                 as timestamp,
       max(duration)                            as timerMax,
       sum(duration)                            as timerSum,
       count(1)                                 as timerCount,
       sampling(new Object[]{duration,traceId})                   as sampling
FROM algoRedisSpan as origin
GROUP BY algoScene, rootScene, currentScene, props,env,serviceName, clusterName, redisUrl,statusCode,trunc_sec(startTime, 10)- @TimeWindow(10): 定义了一个10秒的滚动窗口,引擎会把这10秒内产生的所Redis访问记录(Span)攒在一起进行一次计算
- @Metric(...): 这定义了输出结果的结构。将计算结果转化为指标(Metric),其中tags是维度,fields是数值。
- sampling(...): 采样功能,通过采样逻辑记录耗时最大的traceId。
场景拓扑图
前面构造了以"场景"为中心的算法域调用指标,后面构造怎样的数据模型决定了用户从什么角度去观察和分析数据。我们摒弃了不够直观的传统的表格式展示,借助强大的图数据存储数据库Neo4j,实时存储和更新算法场景的算子调用拓扑图。实时调用指标关系存储时序数据库Victoriametrics,实时调用关系存储Neo4j。
图模型
- 节点(Node):代表实体,如:App、AppCluster、ArkGroup、ArkDataId、AlgoComponent、AlgoDGraph等
- 关系(Relationship):连接节点,如:SceneRelation、AppRelation等
- 属性(Properties):存储在节点和关系上的键值对,如:appName、clusterName、scene、componentName、updateTimestamp等
数据模型设计
php
// app节点
CREATE (a:App {
    id: 1,
    hash: -6545781662466553124,
    appName: "sextant"
})
// appCluster节点
CREATE (c:AppCluster {
    id: 23,
    hash: -8144086133777820909,
    appName: "sextant",
    clusterName: "sextant-csprd-01"
})
// index
CREATE INDEX index_app_name FOR (a:App) ON (a.appName)
// 关系
MATCH (a:App {id: 1}),(c:AppCluster {id:23})
MERGE (a)-[r:HAS_CLUSTER]->(c)
ON CREATE SET r.updateTs = timestamp()
ON MATCH SET r.updateTs = timestamp()
return r;
时序指标设计
json
{
    "metric": {
        "__name__":"algo_client_metric_timerCount",
        "from":"hashcodexxx",
        "to":"hashcodexxx",
        "statusCode": 0,
        "type": "Dgraph"
    },
    "values":[42,32,15],
    "timestamps":[1767573600,1767573620,1767573640]
}
上线效果
- 通过apoc获取实体间的调用关系
objectivec
CALL apoc.meta.graph()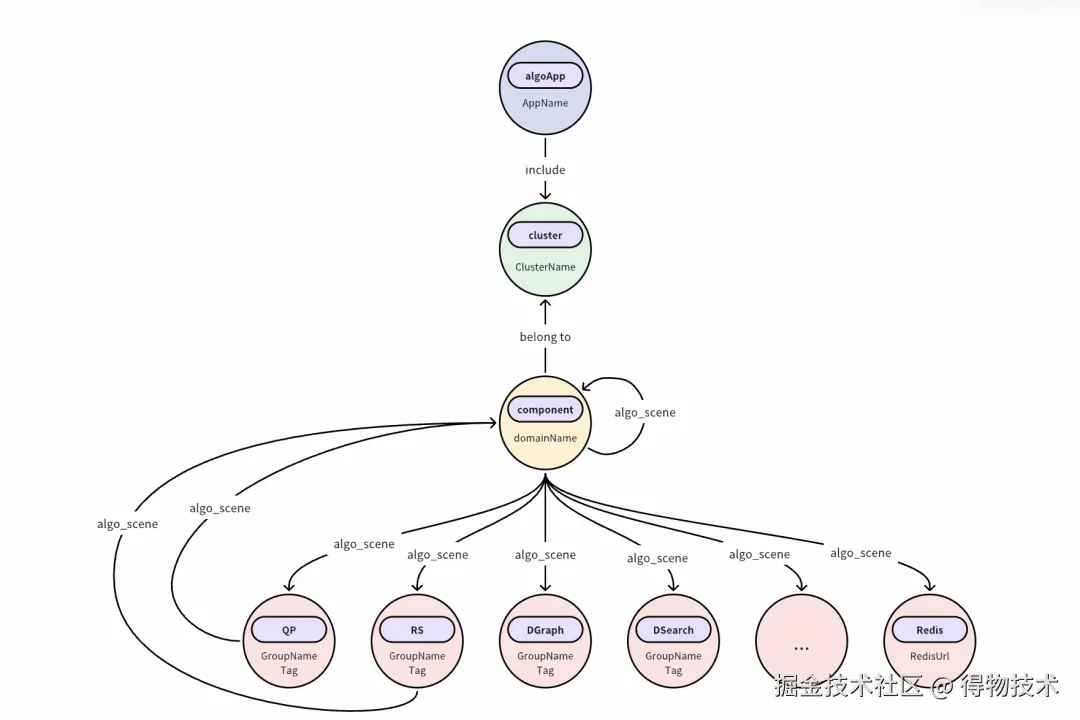
- 通过cypher语句查询某场景下的调用拓扑
scss
MATCH
    p = (entry {appName: 'app'})-[r:USES_SCENE*1..]->(to)
WHERE all(rel IN r WHERE rel.type = 'CURRENT_SCENE' AND rel.scene CONTAINS 'scene'          and rel.updateTs >= 1767675780000 and rel.updateTs <= 1767679380000)
RETURN nodes(p) AS allNodes, relationships(p) AS allRels LIMIT 1000
ini
sum(sum_over_time(algo_client_metric_timerSum{scene="xxx"}[1m] offset 1m)) by (to) / sum(sum_over_time(otel_algo_client_metric_timerCount{scene="xxx"}[1m] offset 1m)) by (to)
/ 1000
sum(sum_over_time(algo_client_metric_timerCount{scene="xxx"}[1m] offset 1m) / 60) by (to)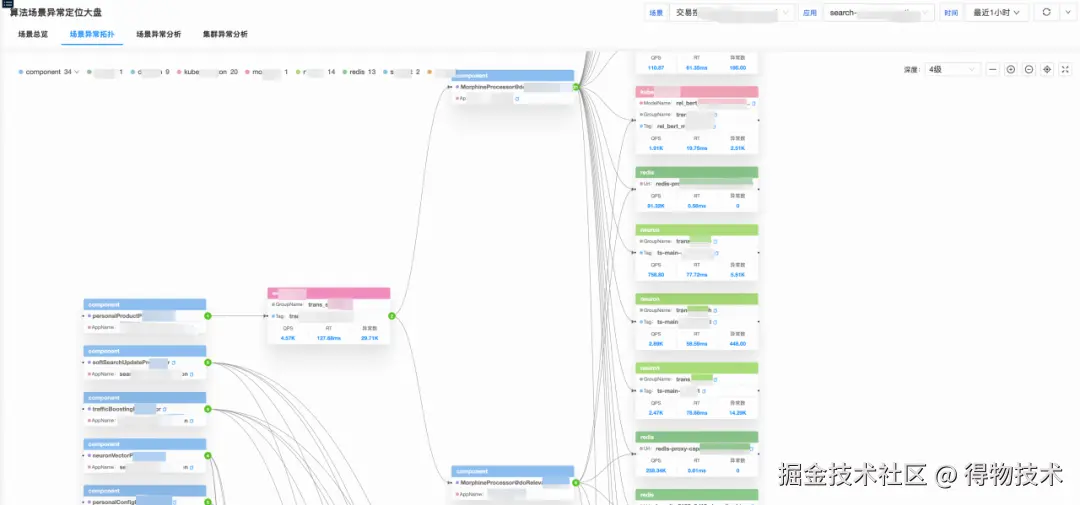
五、智能化演进:异常检测与事件联动
异常检测:改进型IQR算法
通过构建以"场景"为核心的监控维度,我们可以精准捕捉异常总数及其演进趋势。接下来聚焦周期性规律识别与异常检测算法优化两大核心领域:
周期性规律:从傅里叶变换到自适应识别
在电商微服务架构中,指标波动深度耦合人类行为的"昼夜节律";而在算法业务场景下,频繁的实验任务使周期性特征更趋复杂且多变;
- 通用方案:传统的傅里叶变换(FFT)虽能捕捉频域特征,但在时域噪声干扰下难以推导出高精度的物理周期;
- 落地方案:采用自适应周期识别算法, 能够根据时序数据的动态演变,自动、精确地推测出各场景特有的周期步长;
给定一些候选周期,通过计算时间序列的滞后1周期的自相关性,验证时间序列是否匹配候选周期。对不同的候选周期,取不同长度的历史数据,候选周期越大,需要历史数据越久远,相关性要求较低。
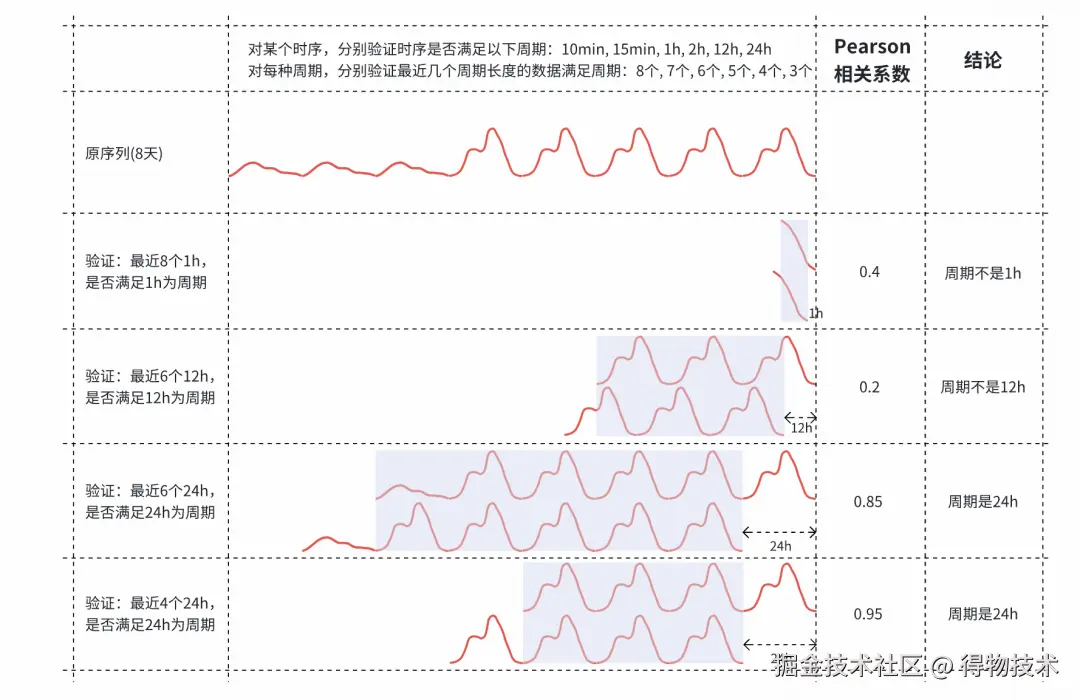
周期识别算法示意图
异常检测算法:从 3-Sigma 到改进型 IQR
面对流量激增产生的"随机突刺"以及低流量场景下的"零水位"常态,检测算法需要具备极高的鲁棒性。
- 通用方案:标准3-Sigma算法 预设数据符合正态分布,而错误数指标往往呈现正偏态、高峰度特征,直接应用会导致虚假告警频繁,产生大量"告警噪音";
- 落地方案:基于四分位距(IQR)算法进行深度改进。通过动态调整比例系数与阈值边界,完美适配非正态分布的错误数指标,在确保灵敏度的同时显著降低了误报率;
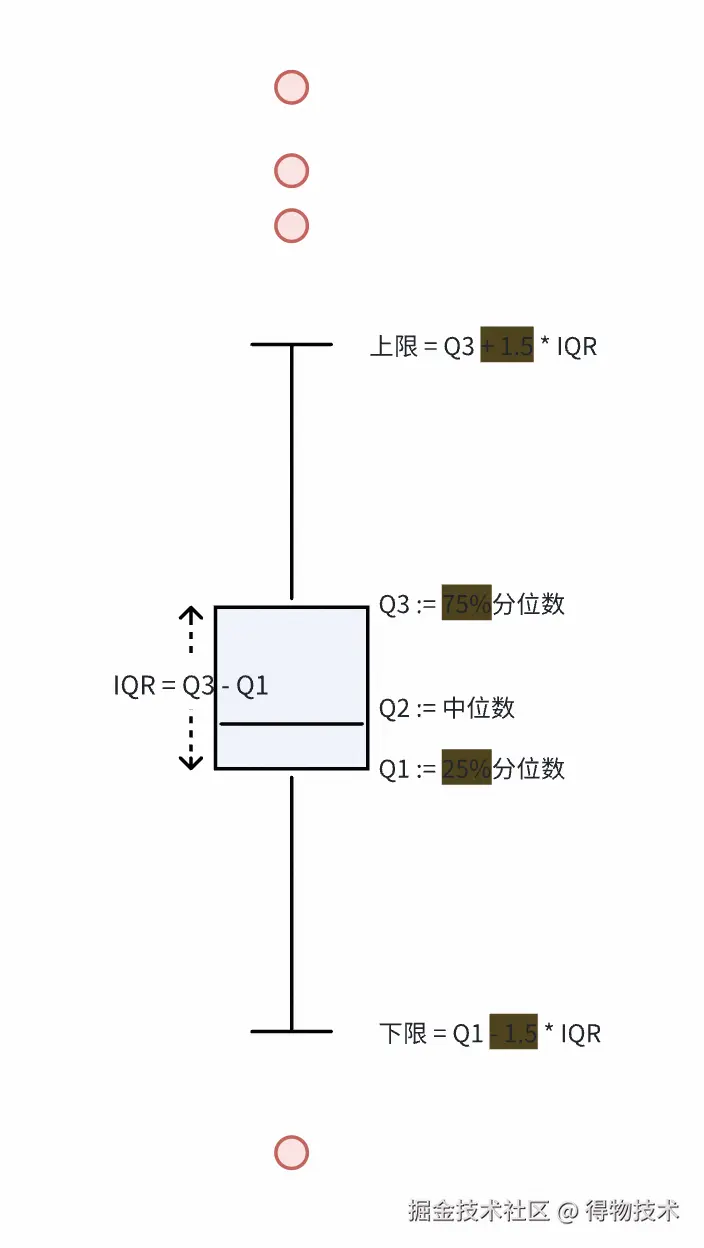
综合考虑,使用IQR异常检测:
- IQR是指:上四分位数与下四分位数(25%分位数)之差,即箱型图中箱体的高度。
- IQR异常检测是指:超过上四分位数1.5倍的IQR,或低于下四分位数1.5倍的IQR,则为异常。
结合错误数指标特征,对IQR异常检测进行了一些改进:
- 零基线自适应处理:当时间序列大量为0时,自动排除0值计算基线,避免误报。
- 双阈值约束:错误数超过多少必为异常,超过基线多少必为异常。
- 图中高亮部分(75%, 25%, +1.5, -1.5 )均设置为可调参数,针对不同算法场景做微调。
落地效果
一般异常检测
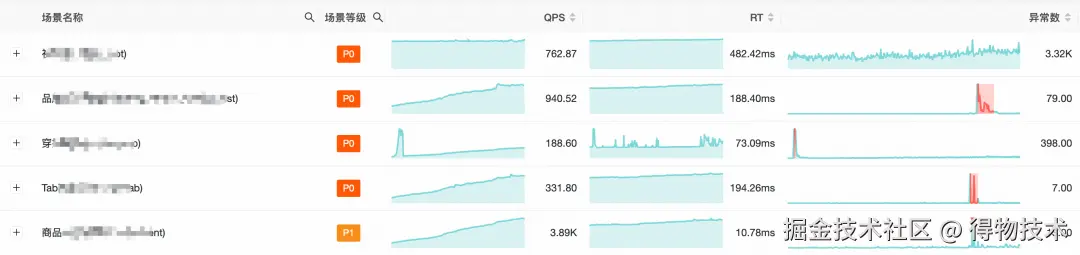
零基指标的异常检测:噪音显著降低
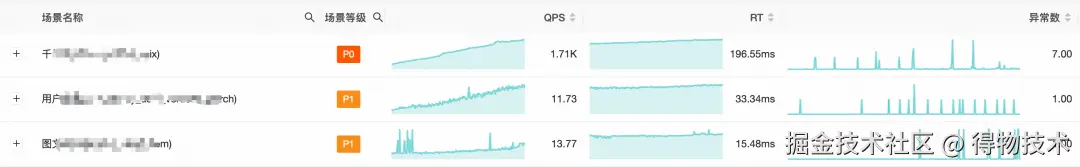
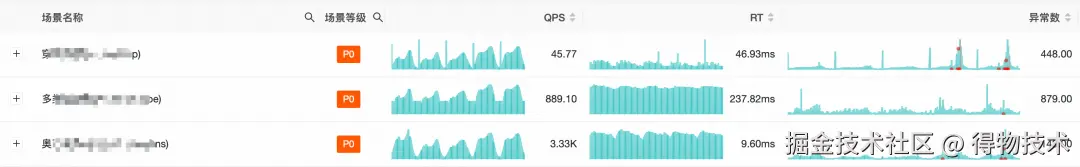
周期性指标的异常检测:能发现局部异常点
事件标准化:因果关联的最后一公里
在得物算法生态中,日均变更次数达万级,涵盖了模型迭代、配置分发、代码部署等多个维度。事件标准化的核心目标是:让每一次变更都有迹可循,并能自动与链路抖动建立因果关联。
统一事件协议
我们对来自配置中心、发布平台、算法实验平台等10+个源头的事件进行了协议标准化。每一个进入可观测底座的事件都必须具备以下条件:
- Source (变更源): 变更的平台(配置中心 / 发布平台 / AB实验平台 / 特征平台 / 机器学习平台等 )
- ChangeObject (主体): 变更对象(如:某个应用名、某个配置文件)
- ChangeStatus (状态): PENDING / APPROVED / CANCELED / FINISHED 等
- StartTime(时间): 变更开始时间
- ChangeName (标题): 变更主体
- Severity (等级): 评估变更风险等级(P0-P3)
- beforeChangeContent (上一次版本): 记录变更前的内容
- changeContent (版本): 记录变更后的内容
- extraInfo (附加信息): 可选字段如下:
- <scene: 场景名>,<isGlobal: 全局变更>,<isReboot: 自动变更> ...
事件流
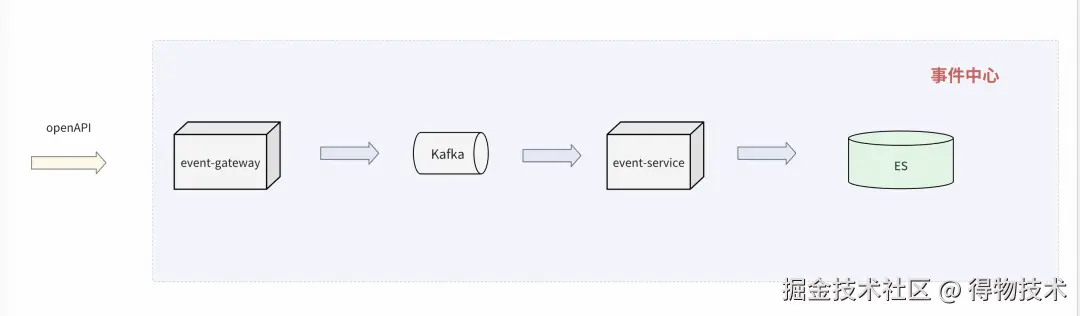
- 各平台通过OpenAPI方式上报到事件中心,数据存储在ES中
- 算法域累计10+个平台100+种变更入口类型,每天10+万的变更事件
场景事件关联
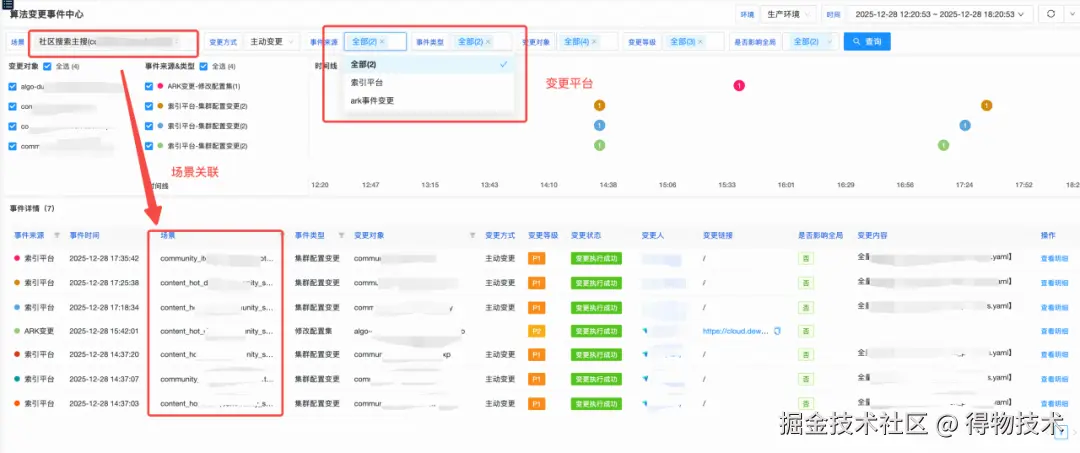
算法侧一些核心的平台的事件只能串联上业务域,这一期我们用在线Trace埋点的方式,串联通了核心平台从一/多个场景,比如:社区搜索主搜索,通过在线Trace清洗后就可以关联上,搜推AB实验管理平台、索引平台、无矩机器学习平台等等。
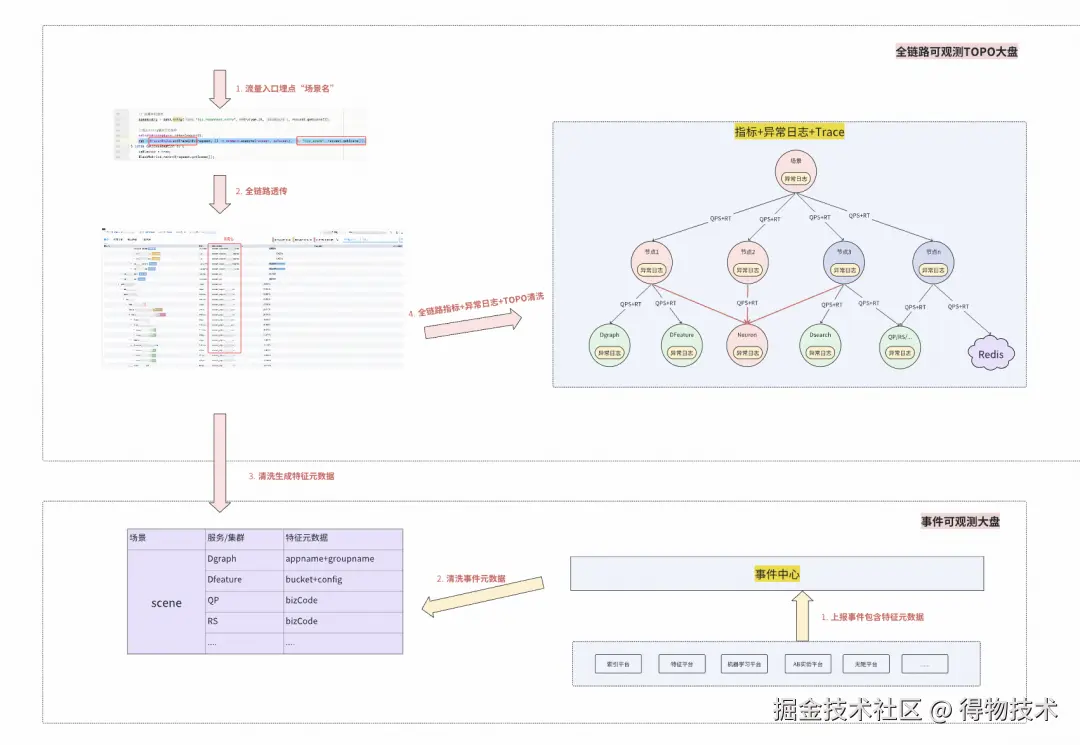
上线效果
六、总结---算法域全景可观测性的 0 到 1
算法域全景可观测性的构建,从零开始摸索,我们经历了多次技术方案的迭代与修正。这让我们意识到,监控建设不能不结合业务场景,否则产生的数据很难在实际排查中发挥价值。
在一期建设中,我们聚焦于实用性,通过整合链路(Trace)、指标(Metric)、日志(Log)以及变更事件,打通了从基础架构到业务应用的纵向关联。这套体系为二线运维提供了清晰的下钻能力,使得故障边界的锁定更加快速准确。
进入二期阶段,我们将重点解决存量离线变更的接入以及ErrLog/业务码的标准化问题。同时,我们将观测维度延伸至业务效果指标,通过构建集SLA监控、事件中心与异常大盘于一体的"算法业务场景NOC-SLA保障体系",实现从"系统运行可见"到"业务运行稳定"的闭环。
往期回顾
1.前端平台大仓应用稳定性治理之路|得物技术
2.RocketMQ高性能揭秘:承载万亿级流量的架构奥秘|得物技术
3.PAG在得物社区S级活动的落地
4.Ant Design 6.0 尝鲜:上手现代化组件开发|得物技术
5.Java 设计模式:原理、框架应用与实战全解析|得物技术
文 /南风
关注得物技术,每周更新技术干货
要是觉得文章对你有帮助的话,欢迎评论转发点赞~
未经得物技术许可严禁转载,否则依法追究法律责任。