大模型-微调相关内容
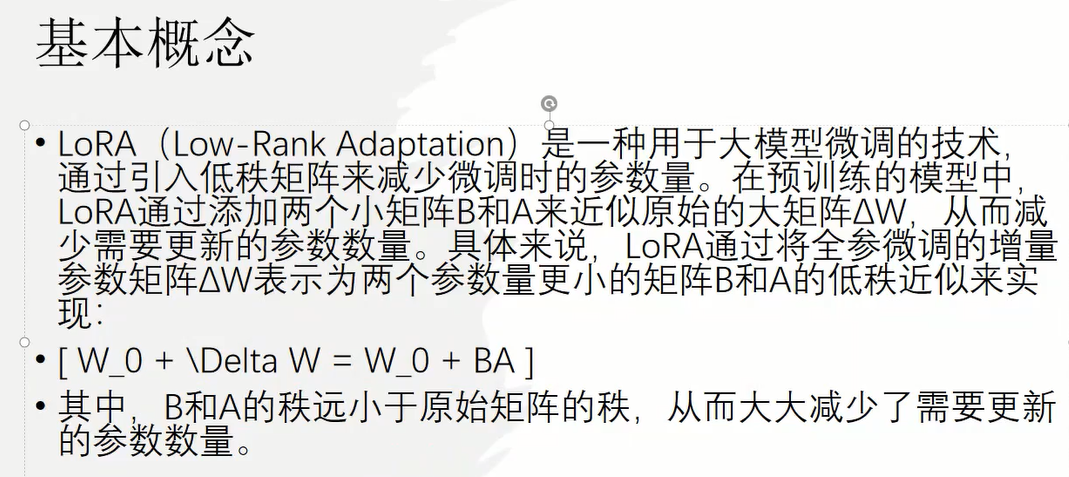
1、LoRA微调基本原理
相关概念:
python
模型预训练:从头开始训练一个全新的模型(全新的模型是指模型的参数完全随机,不能处理任何的问题)
微调训练(迁移学习):基于之前训练好的模型,来继续学习新的任务。微调的目的往往是让模型具备新的或特定的能力。----全量微调、局部微调、增量微调
LoRA微调属于局部微调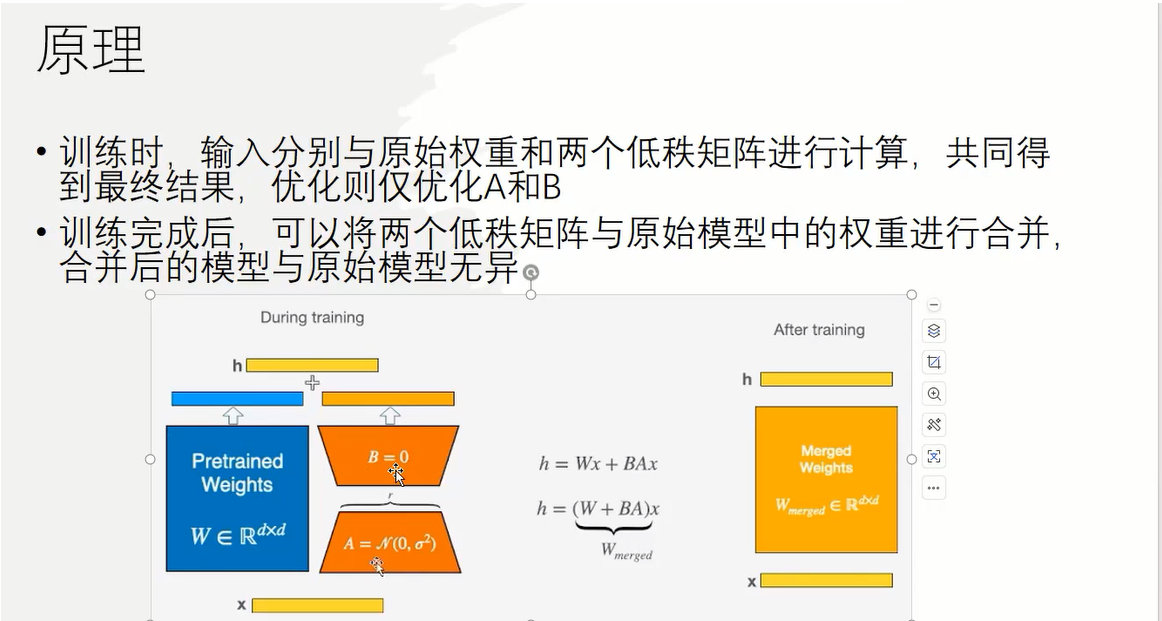
LlamaFactory微调大模型流程记录
LlamaFactory框架安装:
项目github官网下载地址:
python
https://github.com/hiyouga/LlamaFactory/tree/main官方建议依赖版本:
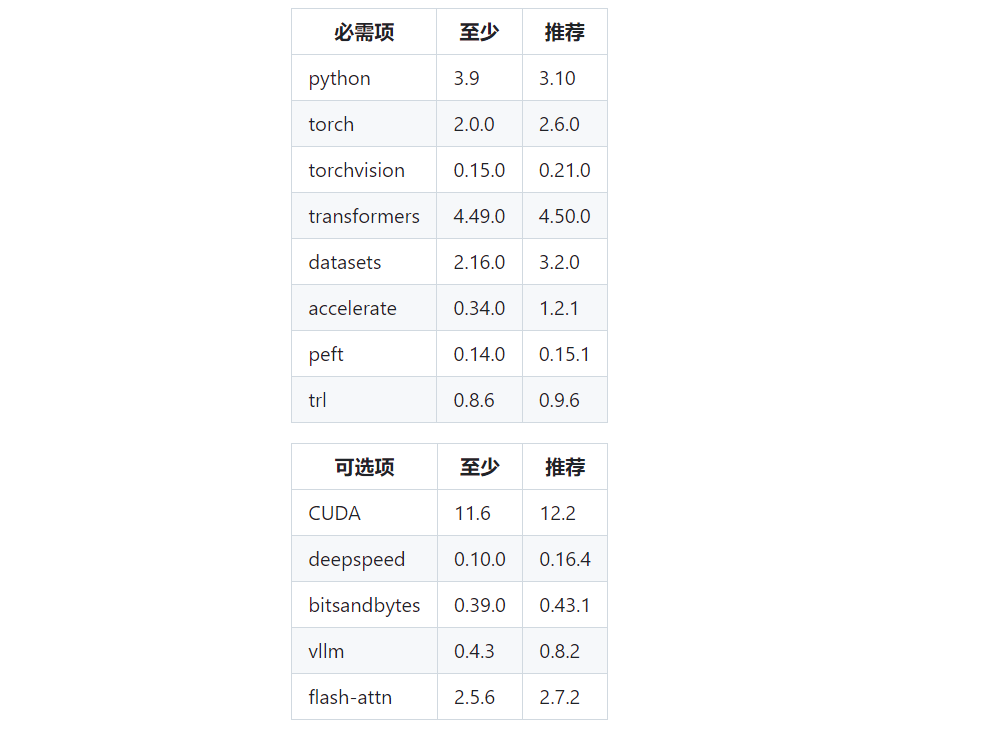
根据上述官方依赖版本,我采用python版本是3.11,torch==2.5.0对应的cuda版本是11.8,具体如下:
python
# 创建python3.11版本的虚拟环境
conda create -n llamafactory python=3.11  -y

# 安装torch版本是2.5.0
pip install torch==2.5.0 torchvision==0.20.0 torchaudio==2.5.0 --index-url https://download.pytorch.org/whl/cu118
接下来是重要的一步:安装flash-attention
该包采用pip安装的话,我在安装过程中出现卡顿的问题,所以,直接从其github官网下载对应版本的**.whl**文件包
python
https://github.com/Dao-AILab/flash-attention根据llama-factory官方推荐,安装的是v2.7.3
python
https://github.com/Dao-AILab/flash-attention/releases/tag/v2.7.3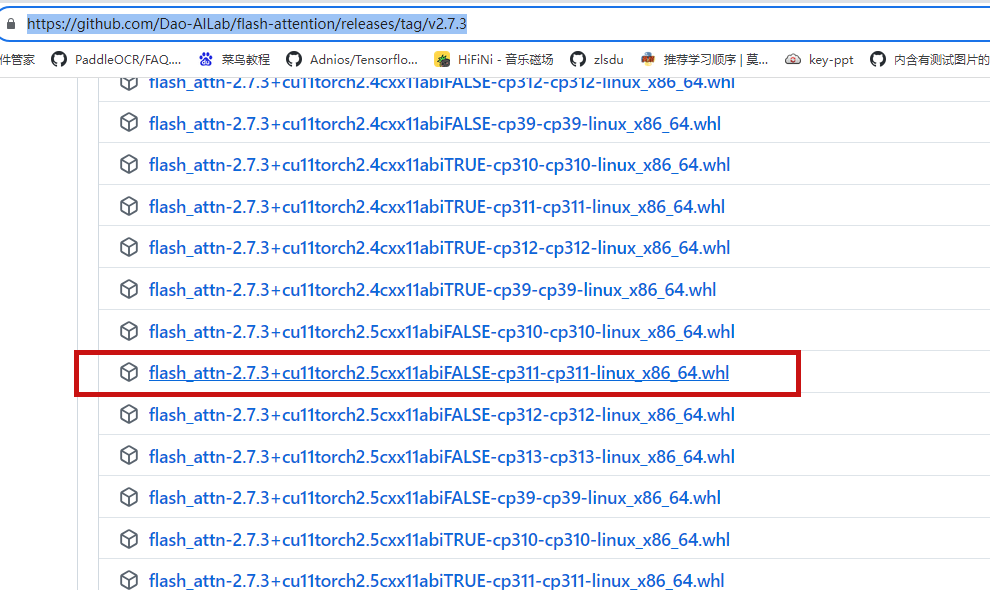
安装:
python
pip install flash_attn-2.7.3+cu11torch2.5cxx11abiFALSE-cp311-cp311-linux_x86_64.whl然后,安装llama-factory的正常依赖:
python
cd LlamaFactory
pip install -e .