使用pdfbox组件,完成pdf文件中内容的提取。具体操作如下:
pom.xml引入坐标:
java
        <dependency>
            <groupId>org.apache.pdfbox</groupId>
            <artifactId>pdfbox</artifactId>
            <version>2.0.29</version>
        </dependency>
新建PdfRegexExtractUtil.java类
java
import java.io.IOException;
import java.math.BigDecimal;
import java.util.regex.Matcher;
import java.util.regex.Pattern;

import org.apache.pdfbox.pdmodel.PDDocument;
import org.apache.pdfbox.text.PDFTextStripper;

import lombok.extern.slf4j.Slf4j;

/**
 * PDF正则表达式提取工具类
 * 用于从PDF文档中通过正则表达式提取特定字段的数值
 */
@Slf4j
public class PdfRegexExtractUtil {

    /**
     * 通过正则表达式提取字段值
     * <p>
     * 提取逻辑:
     * 1. 先提取整个PDF的文本内容
     * 2. 使用正则表达式匹配字段名和对应的数值
     * 3. 数值格式支持:正负数、千位分隔符(逗号或空格)、小数点后2位
     *
     * @param document  PDF文档
     * @param fieldName 字段名称(用于日志)
     * @param fieldLabel 字段标签(PDF中的实际文本,用于正则匹配)
     * @return 提取的数值,如果未找到返回null
     */
    private static BigDecimal extractFieldValue(PDDocument document, String fieldName, String fieldLabel) {
        try {
            // 提取整个PDF的文本内容
            PDFTextStripper stripper = new PDFTextStripper();
            stripper.setSortByPosition(true);
            String fullText = stripper.getText(document);

            if (fullText == null || fullText.isEmpty()) {
                log.warn("字段 {} 的PDF文本内容为空", fieldName);
                return null;
            }

            log.debug("字段 {} 的PDF文本内容长度: {}", fieldName, fullText.length());

            // 构建正则表达式:匹配字段名后面的数值
            // 模式:字段名 + 可能的空白字符 + 分隔符(|) + 可能的空白字符 + 数值
            // 数值格式:[-]?数字[千位分隔符]数字[.小数]
            // 例如:Income | 2,670.61 或 Expenses | -1,414.02
            String escapedLabel = Pattern.quote(fieldLabel);
            // 匹配字段名后可能的分隔符(|、空格、制表符等)和数值
            // 使用更宽松的匹配,允许字段名和数值之间有各种空白字符和分隔符
            String patternStr = escapedLabel + "[\\s|\\t]*([-]?\\d{1,3}(?:[,\\s]?\\d{3})*(?:\\.\\d{1,2})?)";
            Pattern pattern = Pattern.compile(patternStr, Pattern.CASE_INSENSITIVE | Pattern.MULTILINE | Pattern.DOTALL);
            Matcher matcher = pattern.matcher(fullText);

            if (matcher.find()) {
                String valueStr = matcher.group(1).replaceAll("[,\\s]", "");
                try {
                    BigDecimal value = new BigDecimal(valueStr);
                    log.info("成功提取字段 {} 的值: {} (原始匹配: {})", fieldName, value, matcher.group(0));
                    return value;
                } catch (NumberFormatException e) {
                    log.warn("字段 {} 的数值格式不正确: {}", fieldName, valueStr);
                }
            } else {
                log.warn("字段 {} 在PDF中未找到匹配的数值 (字段标签: {})", fieldName, fieldLabel);
                // 输出部分文本内容用于调试
                if (fullText.length() > 500) {
                    log.debug("PDF文本前500字符: {}", fullText.substring(0, 500));
                } else {
                    log.debug("PDF完整文本: {}", fullText);
                }
            }

        } catch (IOException e) {
            log.error("提取字段 {} 的值时发生IO异常: {}", fieldName, e.getMessage(), e);
        } catch (Exception e) {
            log.error("提取字段 {} 的值时发生异常: {}", fieldName, e.getMessage(), e);
        }

        return null;
    }


}
调用:
java
PDDocument document = PDDocument.load(pdfFile.getInputStream());
BigDecimal income = PdfRegexExtractUtil.extractFieldValue(document, "Income", "Income");
pdfFile来自前端上传的PDF文件
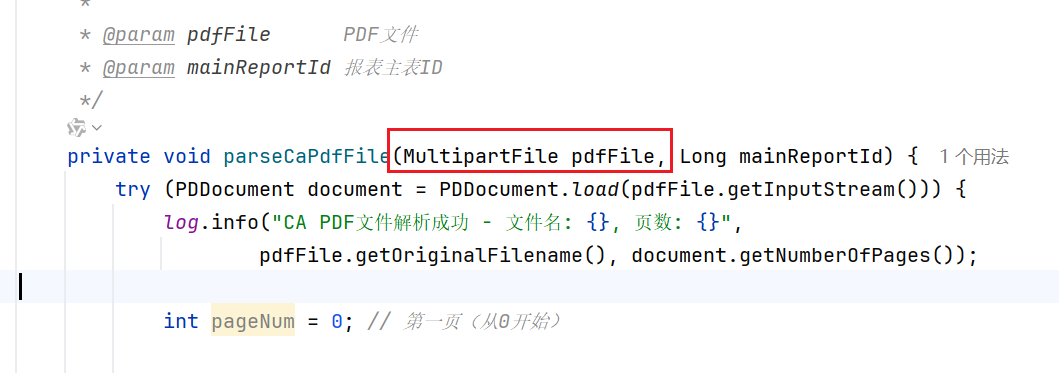
这样就可以获取到PDF文件中,名称为Income对应的值,PDF文件如下:
