原始基于Funasr框架的SenseVoice是中英文转录模型,在官方的文档中,仅支持微调,不支持热词和流式输出,这肯定会在一定程度上影响用户的体验,有大神对其网络结构进行了魔改,使其成为一个支持热词,可微调,可流式的中英文语音转录模型。
github上魔改之后的地址(感谢这位大神的分享):流式SenseVoice
一、 本地文件加载
这里代码中原有加载本地文件的程序,是有问题的。
python
import soundfile as sf

from streaming_sensevoice import StreamingSenseVoice


def main():
    contexts = ["停止"]
    model = StreamingSenseVoice(contexts=contexts)

    samples, sr = sf.read("data/test_16k.wav")
    # 这里不知道为什么要*3,如果这样,一定是会检测三遍
    samples = (samples * 32768).tolist() * 3

    step = int(0.1 * sr)
    for i in range(0, len(samples), step):
        is_last = i + step >= len(samples)
        for res in model.streaming_inference(samples[i : i + step], is_last):
            print(res["timestamps"])
            print(res["text"])


if __name__ == "__main__":
    main()
更改之后的代码:
python
import soundfile as sf						# 这个库用来读取和写入音频文件
from streaming_sensevoice import StreamingSenseVoice	# 外部模块
def main():
    contexts = ["停止"]						# 这里应该就是热词加载的模块
    model = StreamingSenseVoice(contexts=contexts, model='/data/H2413325/code_dir_V2/FunASR-main/examples/industrial_data_pretraining/sense_voice/SenseVoiceSmall',
                               device='cuda:0')
	 # soundfile读取WAV文件,这里的文件一定是16KHZ,读取之后的samples是音频文件的采样数据,是数组格式,sr是音频采样率
    samples, sr = sf.read("data/Meeting1_16k.wav")
    assert sr == 16000
    # 将音频数据的范围从float浮点区间,转换为整数形式,通常是16位整数(int16)astype('int16')是int16类型。
    # tolist()将numpy数组转换为list列表,因为流式识别模型通常接收Python列表格式的数据
    samples = (samples * 32768).astype("int16").tolist()
    # 步长,每次仅传输0.1秒的数据,也就是0.1*sr个音频片段 样本数 = 0.1*16000
    step = int(0.1 * sr)
    # for循环按照步长处理音频片段,i是当前音频块的起始位置,每次循环会处理长度为0.1秒的数据
    for i in range(0, len(samples), step):
        chunk = samples[i : i + step]			# 0~1600    1600~3200  3200~4800  ...
        is_last = i + step >= len(samples)	# 判断是否是结尾,如果是结果,is_last==0
        results = model.streaming_inference(chunk, is_last)   	# 流式传入模型
        # 处理转录结果
        for res in results:
            if res["text"].strip():
                print(f"[{res['timestamps']}] {res['text']}")

if __name__ == "__main__":
    main()
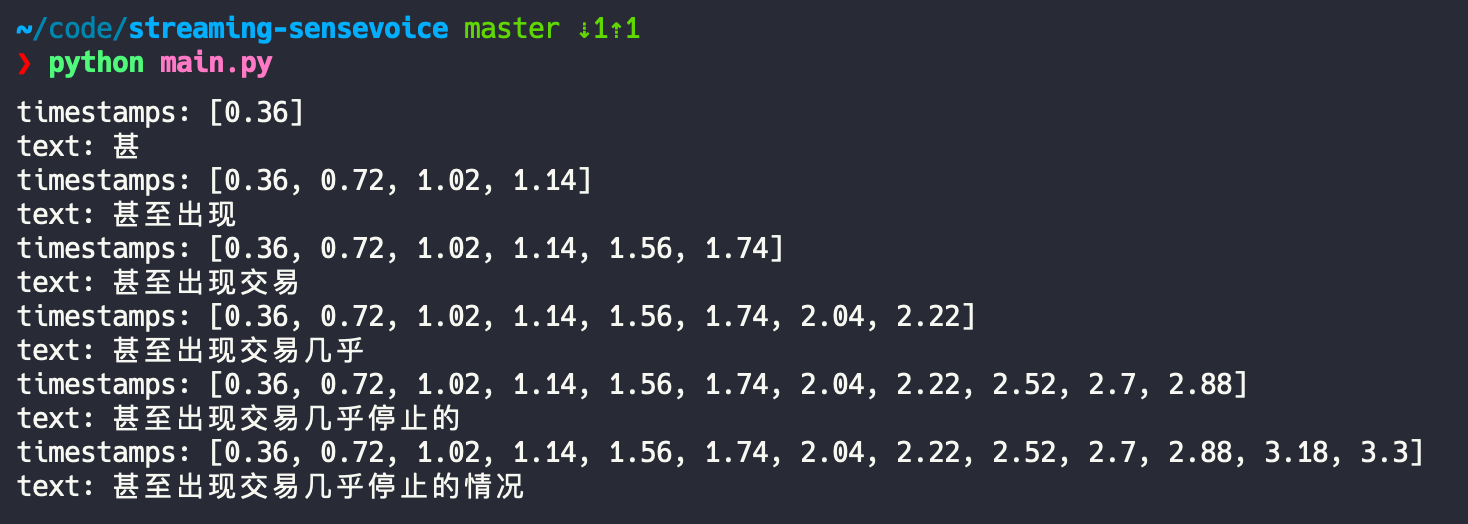
本地文件的识别效果如下图所示: