【FlashAttention】 FA2与FA1算法区别辨析

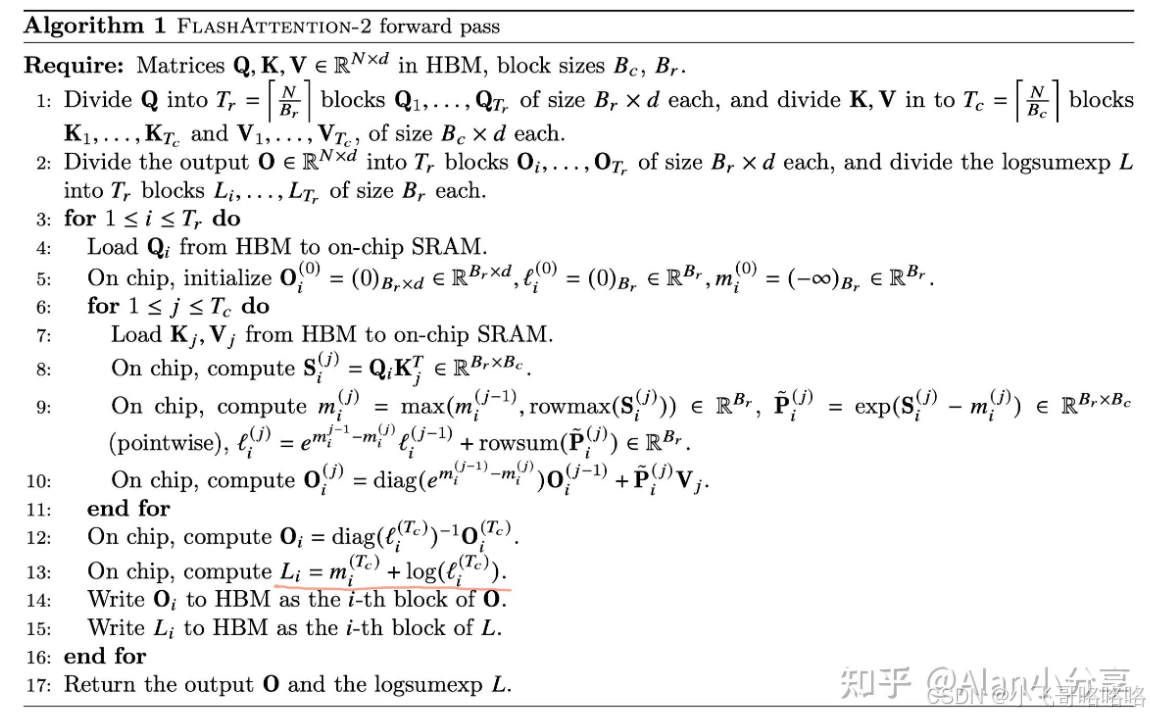
看了几篇关于FlashAttention2的文章,对于其中移除冗余的CUDA操作这个算法优化进行了一个综合梳理。

https://zhuanlan.zhihu.com/p/1993815603383902344

https://zhuanlan.zhihu.com/p/668888063

https://zhuanlan.zhihu.com/p/665170554
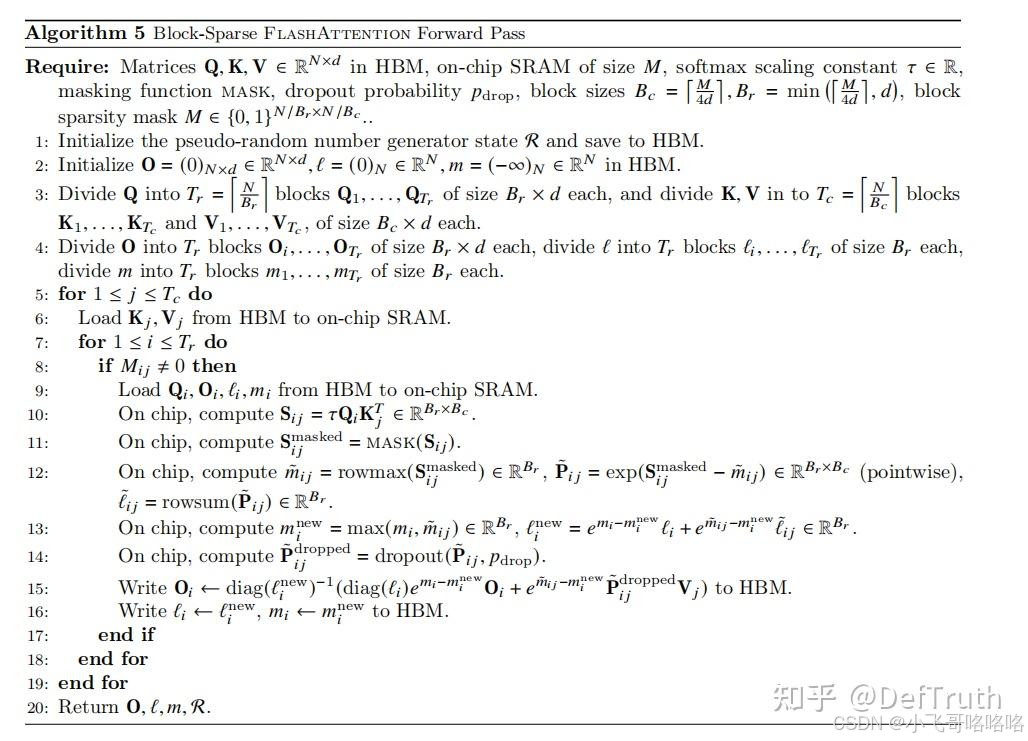
注意,第10行在部分文章中错写成了diag的逆,应该根据这篇文章的伪代码为准(推测是之前存在笔误,改了之后又重新上传了)。

这里FlashAttention2与FlashAttention1看起来有很大差别,推导如下;

  1. 首先比较重要的一点是,在FA2里,关于m, P的计算都没有mijm_{ij}mij, pijp_{ij}pij的概念,而是直接计算mim_imi和minewm_i^{new}minew,pip_ipi和pinewp_i^{new}pinew。因此此处的mijm_i^jmij就是FA1中的mijm_{ij}mij - minewm_i^{new}minew。另外此处的P也就是FA1中的emij−minew∗Pe^{m_{ij} - m_i^{new}} * Pemij−minew∗P。
  2. 另外第二个点,就是在中间的迭代中不计算L,只在最后一个迭代计算。
相关推荐
Blockbuater_drug7 小时前
OpenMM分子动力学模拟02 安装:Linux:conda 一条命令装通 GPU 加速的分子模拟环境
linux·conda·cuda·gpu驱动·pythonpath·openmm安装
椒颜皮皮虾྅2 天前
让文档不止于文字:DeploySharp + PP-Structure,打通版面分析与表格重建
开发语言·学习·c#·.net·cuda
椒颜皮皮虾྅3 天前
模型部署不再卡在环境上:DeploySharp 四大推理引擎与 Windows/Linux 离线交付实战
linux·运维·开发语言·人工智能·windows·计算机视觉·cuda
椒颜皮皮虾྅3 天前
让 C# 读懂整张图:DeploySharp 驱动 PaddleOCR v4/v5/v6,打通 OCR 全流程
开发语言·人工智能·深度学习·学习·c#·ocr·cuda
iiiiii117 天前
大模型批量生成中的左填充 (left padding)与右填充 (right padding):从生成正确性到 GRPO 的混合策略
人工智能·机器学习·语言模型·大模型·llm·attention·注意力
fpcc10 天前
并行编程实战—CUDA中的Tile编程之八优化提示
cuda·1024程序员节·并行编程
本地化文档11 天前
cutile-rs-book-l10n
rust·gpu·nvidia·cuda·sphinx·crowdin
Web3&Basketball12 天前
TorchTPU 迁移实战:3 个 CUDA 卡点
pytorch·性能调优·cuda·tpu·模型迁移·torchtpu
燃烧的枫15 天前
Windows 下 YOLO26 的 TensorRT C++ 部署
人工智能·pytorch·windows·计算机视觉·tensorrt·cuda·yolo26