人工智能学习-AI入试相关题目练习-第七次
- 1-前言
- 3-问题题目训练
- 4-练习(日语版本)解析
-
- [(1)k-means 法(k=3)收敛全过程](#(1)k-means 法(k=3)收敛全过程)
- [(2)一阶逻辑公式 → Skolem 标准形](#(2)一阶逻辑公式 → Skolem 标准形)
-
- 原公式
- [Step 1:去蕴含](#Step 1:去蕴含)
- [Step 2:否定展开](#Step 2:否定展开)
- [Step 3:Skolem 化](#Step 3:Skolem 化)
- [✅ Skolem 标准形(简洁形式)](#✅ Skolem 标准形(简洁形式))
- [(3-1)ナッシュ均衡 vs 支配戦略均衡](#(3-1)ナッシュ均衡 vs 支配戦略均衡)
- [(3-2)Gaussian Mixture Model(GMM)](#(3-2)Gaussian Mixture Model(GMM))
- [(3-3)n-gram 模型](#(3-3)n-gram 模型)
- (3-4)三种学习方式对比
- 5-単語练习(日语版本)
- 5-总结
1-前言
为了应对大学院考试,我们来学习相关人工智能相关知识,并做各种练习。
通过学习,也算是做笔记,让自己更理解些。
3-问题题目训练
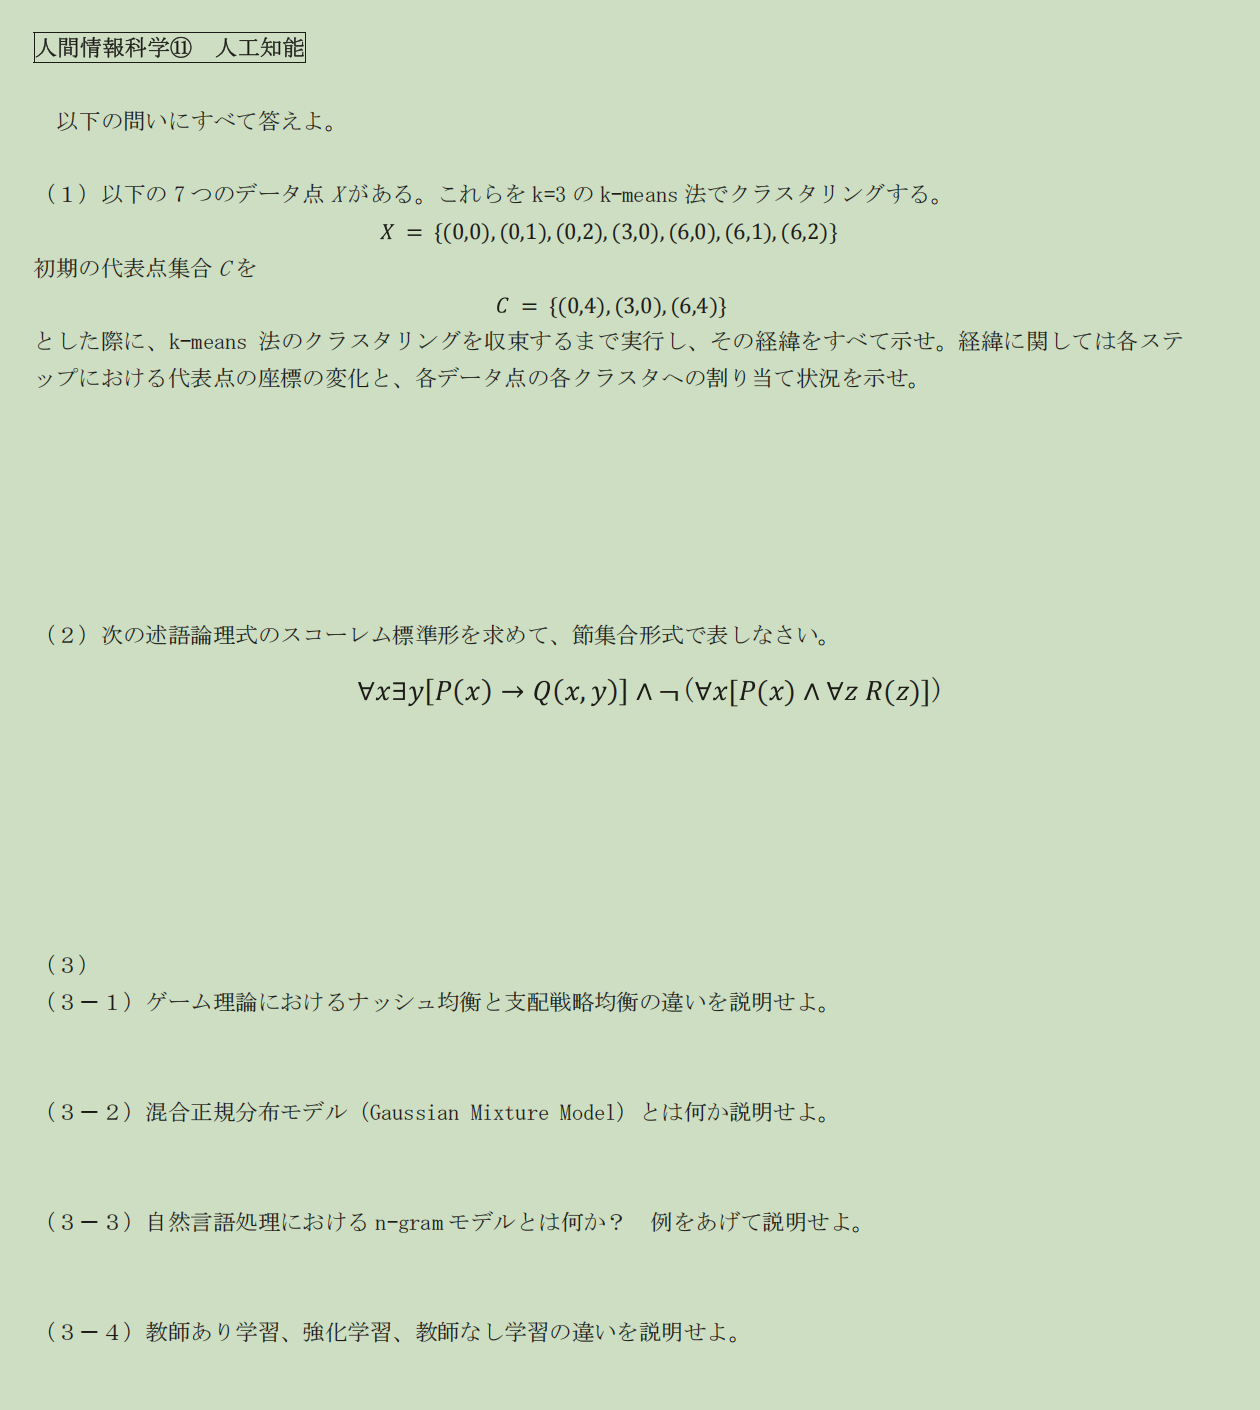
4-练习(日语版本)解析
(1)k-means 法(k=3)收敛全过程
给定数据
X={(0,0),(0,1),(0,2),(3,0),(6,0),(6,1),(6,2)}
初始代表点(中心):
C\^{(0)}={(0,4),(3,0),(6,4)}
距离采用 ユークリッド距離(Euclidean distance)
🔁 Step 1:第一次分配(根据初始中心)
| 点 | 到 (0,4) | 到 (3,0) | 到 (6,4) | 分配 |
|---|---|---|---|---|
| (0,0) | 4 | 3 | √52 | C₂ |
| (0,1) | 3 | √10 | √45 | C₁ |
| (0,2) | 2 | √13 | √40 | C₁ |
| (3,0) | 5 | 0 | 5 | C₂ |
| (6,0) | √52 | 3 | 4 | C₂ |
| (6,1) | √45 | √10 | 3 | C₃ |
| (6,2) | √40 | √13 | 2 | C₃ |
得到簇
- Cluster 1:{(0,1),(0,2)}
- Cluster 2:{(0,0),(3,0),(6,0)}
- Cluster 3:{(6,1),(6,2)}
🔁 Step 2:更新代表点(取平均)
-
C₁:
\\left(\\frac{0+0}{2},\\frac{1+2}{2}\\right)=(0,1.5)
-
C₂:
\\left(\\frac{0+3+6}{3},\\frac{0+0+0}{3}\\right)=(3,0)
-
C₃:
\\left(\\frac{6+6}{2},\\frac{1+2}{2}\\right)=(6,1.5)
🔁 Step 3:重新分配
再次计算后,每个点的归属 不再发生变化
👉 算法收敛
✅ 最终结果
- Cluster 1 :{(0,1),(0,2)},中心 (0,1.5)
- Cluster 2 :{(0,0),(3,0),(6,0)},中心 (3,0)
- Cluster 3 :{(6,1),(6,2)},中心 (6,1.5)
(2)一阶逻辑公式 → Skolem 标准形
原公式
\\forall x \\exists y \[P(x) \\rightarrow Q(x,y)\] \\land \\neg(\\forall x\[P(x) \\land \\forall z R(z)\])
Step 1:去蕴含
P(x)\\rightarrow Q(x,y) \\equiv \\neg P(x)\\lor Q(x,y)
Step 2:否定展开
\\neg(\\forall x\[P(x)\\land \\forall zR(z)\]) \\equiv \\exists x(\\neg P(x)\\lor \\exists z \\neg R(z))
Step 3:Skolem 化
- (y) 依赖于 (x) → Skolem 函数 (f(x))
- (\exists x) → Skolem 常数 (a)
- (\exists z) → Skolem 常数 (b)
✅ Skolem 标准形(简洁形式)
(\\neg P(x)\\lor Q(x,f(x))) \\land (\\neg P(a)\\lor \\neg R(b))
(3-1)ナッシュ均衡 vs 支配戦略均衡
| 项目 | ナッシュ均衡 | 支配戦略均衡 |
|---|---|---|
| 定义 | 给定对方策略,自己无法单方面改善 | 不论对方怎么选都是最优 |
| 稳定性 | 相对稳定 | 更强 |
| 必然存在 | 是 | 否 |
| 关系 | 支配戦略均衡 ⊂ ナッシュ均衡 | --- |
📌 考试要点 :
👉 支配戦略均衡一定是纳什均衡,但反之不成立
(3-2)Gaussian Mixture Model(GMM)
定义 :
GMM 是一种用多个高斯分布的加权和来表示数据分布的概率模型。
p(x)=\\sum_{k=1}\^K \\pi_k \\mathcal{N}(x\|\\mu_k,\\Sigma_k)
- (\pi_k):混合权重
- (\mu_k,\Sigma_k):均值与协方差
- 参数通常用 EM 算法估计
📌 考试关键词 :
「概率模型」「软聚类」「EM算法」
(3-3)n-gram 模型
定义 :
n-gram 模型假设:
一个词只依赖于前 n−1 个词
例(bigram) :
P(w_3\|w_1,w_2) \\approx P(w_3\|w_2)
📌 优缺点
- ✅ 简单、可计算
- ❌ 长距离依赖建模能力弱
(3-4)三种学习方式对比
| 学习方式 | 教师信号 | 示例 |
|---|---|---|
| 教師あり学習 | 有正确标签 | 图像分类 |
| 教師なし学習 | 无标签 | k-means |
| 強化学習 | 奖励信号 | 游戏AI |
📌 一句话记忆版(本番可写):
教師あり学習は正解付きデータ,教師なし学習は構造発見,強化学習は報酬最大化を目的とする。
5-単語练习(日语版本)
k-means 法是一种无监督学习的聚类方法,
通过反复进行"数据分配"和"中心更新",
将数据划分为 k 个簇,使簇内距离最小。
无监督学习(教師なし学習)
聚类(クラスタリング)
反复(反復)
簇内距离最小(分散最小化)
5-总结
知识一点点记录吧,最后应对考试,打下基础