文章目录
- 摘要
- Abstract
- 一、项目疑问解答
-
- [1. 传统信息检索,检索增强生成和无向量RAG](#1. 传统信息检索,检索增强生成和无向量RAG)
-
- [1.1 传统信息检索](#1.1 传统信息检索)
- [1.2 检索增强生成(RAG)](#1.2 检索增强生成(RAG))
- [1.3 无向量RAG](#1.3 无向量RAG)
- [1.4 补充](#1.4 补充)
- [2. 大模型工作的核心](#2. 大模型工作的核心)
-
- [2.1 Prompt的转变过程](#2.1 Prompt的转变过程)
- [2.2 转变后Token维度的决定因素](#2.2 转变后Token维度的决定因素)
- 二、调试过程遇到问题
-
- [1. OpenAI 配额问题](#1. OpenAI 配额问题)
- 总结
摘要
本周主要复现PageIndex项目,根据具体出现的问题对项目进行调整修改。
Abstract
This week, I mainly focused on reproducing the PageIndex project, and made adjustments and modifications to the project according to the specific problems encountered during the process.
一、项目疑问解答
1. 传统信息检索,检索增强生成和无向量RAG
1.1 传统信息检索
传统信息检索:模型对 Prompt 中的内容进行 关键词相似度匹配,其中"相似度"是统计相关性,更类似于匹配关键词的频率,根据出现关键词的频率找到可能相关的文档
1.2 检索增强生成(RAG)
RAG:结合了检索和生成,实现推理型检索。基于自身的海量训练数据和上下文理解能力,将检索到的文档作为上下文输入到大模型中,并进行逻辑推理,最终筛选出相关节点。
RAG分为四种:
①基于向量检索的RAG(主流);
说明:基于向量的RAG将整个查询文本和知识库中的每个文本块分别转换为一个固定维度的向量,然后通过计算查询向量与所有文档向量的相似度,找到最相关的文本块作为上下文,最后用大模型生成答案。②基于关键词检索的RAG(无向量RAG);
③混合检索RAG;
④其他检索方式的RAG
1.3 无向量RAG
无向量RAG:检索阶段使用传统检索方法来获取相关文档(即称为无向量的原因),然后用大模型生成答案,而不仅仅是返回一个文档列表。
无向量RAG主要实现方式:
①基于倒排索引的关键词检索;
②基于知识图谱的关系检索;
③基于规则的检索
1.4 补充
1,对于无向量RAG和传统信息检索的理解:
- 传统检索就是类似于搜索引擎,输入问题会返回一个个相关网址,需要用户自己点击各个文章获取答案。
- 无向量Rag就是相当于获取相关网站后大模型帮用户总结答案。所以无向量RAG为传统检索+大模型
2,对于不同阶段token与向量的映射
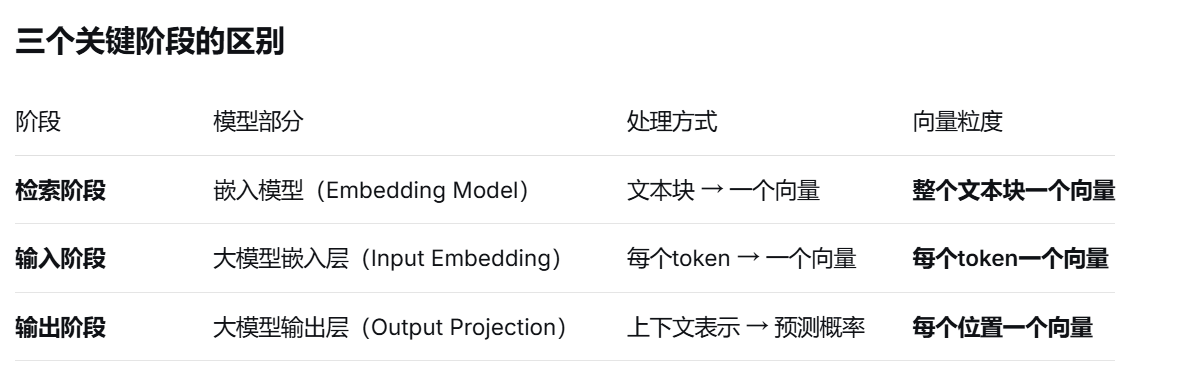
2. 大模型工作的核心
2.1 Prompt的转变过程
1. 文本标准化与清理
去除多余空格、统一编码、可能进行一些语言特定的规范化,确保输入文本的格式统一、干净。
2. 分词
模型使用一个预训练的分词器将文本字符串拆分成更小的单元------Token。
3. 转换为Token ID
分词器内部有一个 "词汇表" ,这是一个从Token到唯一整数ID的映射表。模型将上一步得到的Token序列,根据这个词汇表,转换成一个对应的整数ID序列。

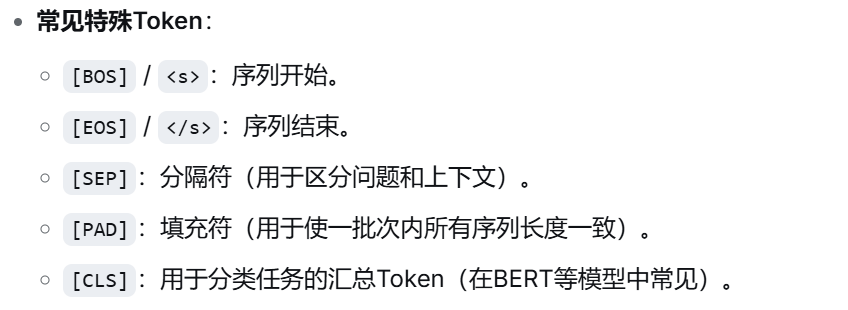
4. 添加特殊Token
根据模型架构和任务,在Token序列的开头、结尾或中间插入具有特定功能的特殊Token。
5. 转换为嵌入向量
操作:模型内部有一个 "嵌入层"。它将每一个整数Token ID,映射为一个高维的、稠密的浮点数向量,称为 "词嵌入"。
关键:这个向量捕获了该Token的语义和语法信息。语义相近的Token,其向量在空间中的距离也更近。
输出:至此,文本Prompt变成了一个二维张量,形状为 序列长度, 嵌入维度。
6. 添加位置编码
Transformer模型本身不具备感知单词顺序的能力。因此,需要为序列中每个位置生成一个特定的"位置编码"向量,并将其加到对应的词嵌入向量上。
方式:可以是固定的(如原始Transformer的正余弦函数),也可以是模型通过学习得到的。
7. 进入Transformer核心
操作:经过上述处理的张量被送入由多层Transformer块堆叠而成的主体结构。
过程:在这里,经过自注意力机制和前馈神经网络的多层计算,每个位置的Token向量都会吸收整个序列中其他Token的上下文信息,其含义被极大地丰富和修正。此时的向量不再是单纯的"词义",而是包含了完整上下文信息的"上下文表示"。
2.2 转变后Token维度的决定因素
"Token的维度"指的是每个Token被表示成的那个向量的长度,也就是 "模型隐藏层的大小" 或 "嵌入维度"。
这个维度完全由模型本身的架构设计决定,在模型训练完成后就固定不变了。
疑问:隐藏层对token输入维度也有要求吗?不是只对输出维度有要求吗?
隐藏层对输入维度有严格要求,而且这个要求是统一的。
二、调试过程遇到问题
1. OpenAI 配额问题
解决方案1:【如何优雅处理OpenAI API配额耗尽错误(429错误)】
解决方案2:由于项目内部使用闭源云端模型,将项目代码修改为PageIndex 本地部署 和 开源模型 的搭配。
注:目前还没跑通(苦涩)
总结
项目中模型替换过程需要对每一处都进行替换,由于原模型在项目中出现位置较多,会遗漏一些地方,模型的修改需要细致。