环境
bash
系统:CentOS-7
CPU : E5-2680V4 14核28线程
内存:DDR4 2133 32G * 2
显卡:Tesla V100-32G【PG503】 (水冷)
驱动: 535
CUDA: 12.2
需要环境
nvcc --version
bash
nvcc: NVIDIA (R) Cuda compiler driver
Copyright (c) 2005-2023 NVIDIA Corporation
Built on Tue_Jun_13_19:16:58_PDT_2023
Cuda compilation tools, release 12.2, V12.2.91
Build cuda_12.2.r12.2/compiler.32965470_0
cmake -version
bash
cmake version 3.24.3

CMake suite maintained and supported by Kitware (kitware.com/cmake).
如果版本不合理需要重新安装
克隆仓库
bash
git clone https://github.com/ggerganov/llama.cpp
cd llama.cpp
清理并创建构建目录
bash
rm -rf build && mkdir build && cd build配置 CMake(关键参数)
bash
cmake .. -DGGML_CUDA=ON -DGGML_CUDA_ARCH=70 -DCMAKE_BUILD_TYPE=Release可以问问AI调整参数
编译(根据 CPU 核心数调整 -j 参数)
bash
make -j$(nproc) GGML_CUDA_FORCE_DMMV_X=1 GGML_CUDA_FORCE_MMQ=1 llama-server运行
bash
./bin/llama-server -m /models/GGUF_LIST/Qwen3-Next-80B/Qwen3-Coder-Next-Q4_K_M-00001-of-00004.gguf --host 0.0.0.0 --port 28000 --gpu-layers 30 --ctx-size 102000 --threads 26访问
bash
http://192.168.31.222:28000/效果
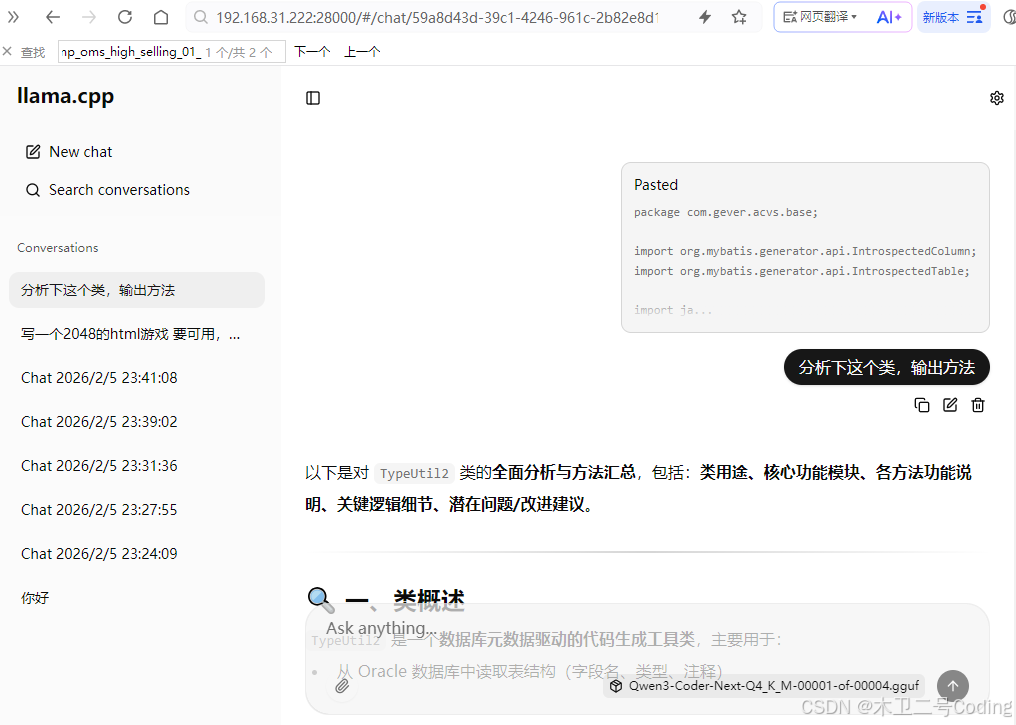
速度
7-8 tokens/s (CPU性能太弱)
GPU 消耗 30G+
GPU利用率 10+%
CPU 2400+ 已经满载在跑了
内存5G+
速度还是很慢的。CPU存在瓶颈