设计原则
SRP(单一职责原则 - Single Responsibility Principle)
-
核心:一个类应该只有一个引起它变化的原因。
-
深度理解 :不是指一个类只能有一个方法,而是指功能的高度聚焦 。比如在 RocketMQ 中,
MappedFile只负责文件映射,而ReputMessageService只负责分发索引。
OCP(开闭原则 - Open/Closed Principle)
-
核心:对扩展开放,对修改关闭。
-
深度理解 :当需求变化时,你应该通过增加新代码来改变行为,而不是修改原有代码。接口和抽象类是实现这一原则的利器。
LSP(里氏替换原则 - Liskov Substitution Principle)
-
核心:子类对象应该能够替换其父类对象,且程序逻辑不变。
-
深度理解:子类可以增强父类的功能,但不能改变父类原有的行为(不要重写父类的非抽象方法)。
ISP(接口隔离原则 - Interface Segregation Principle)
-
核心:客户端不应依赖它不需要的接口。
-
深度理解:与其设计一个"大而全"的接口,不如将其拆分为多个"小而精"的专用接口。避免接口污染。
DIP(依赖倒置原则 - Dependency Inversion Principle)
-
核心:高层模块不应依赖低层模块,二者都应依赖抽象;抽象不应依赖细节,细节应依赖抽象。
-
深度理解 :这就是 IoC(控制反转) 的灵魂。比如你的业务逻辑不应直接 new 一个
RocketMQProducer,而应依赖一个MessageSender接口。
迪米特法则(Law of Demeter / 最少知识原则)
- 一个对象应当对其他对象有尽可能少的了解。不要和陌生人说话,只和你的直接朋友交流。
全部设计模式一览
一、 创建型模式 (Creational Patterns)
核心: 处理对象的创建机制,将系统的"创建"与"使用"解耦。
| 模式 | 核心意图 | 资深工程师点评 |
|---|---|---|
| 单例 (Singleton) | 保证一个类仅有一个实例,并提供全局访问点。 | Spring 的 Bean 默认就是单例。注意双重检查锁(DCL)和枚举实现。 |
| 工厂方法 (Factory Method) | 定义创建对象的接口,让子类决定实例化哪一个类。 | 典型的"解耦"。比如日志记录器,由子类决定存磁盘还是存数据库。 |
| 抽象工厂 (Abstract Factory) | 提供一个创建一系列相关或相互依赖对象的接口。 | 用于"产品族"。比如一套 UI,可以同时生产 Mac 风格的按钮和文本框。 |
| 建造者 (Builder) | 将一个复杂对象的构建与它的表示分离,使得同样的构建过程可以创建不同的表示。 | 解决构造函数参数过多的痛苦。Lombok 的 @Builder 是标配。 |
| 原型 (Prototype) | 通过拷贝现有的实例来创建新的实例。 | 当创建对象成本很高时(如查数据库),直接 clone()。 |
二、 结构型模式 (Structural Patterns)
核心: 处理类或对象的组合,像搭积木一样优化系统结构。
| 模式 | 核心意图 | 资深工程师点评 |
|---|---|---|
| 适配器 (Adapter) | 将一个类的接口转换成客户希望的另外一个接口。 | 解决"接口不兼容"的救火队员。类似手机转接头。 |
| 桥接 (Bridge) | 将抽象部分与它的实现部分分离,使它们都可以独立地变化。 | 解决"多维度扩展"引起类爆炸。比如:不同颜色 + 不同形状。 |
| 组合 (Composite) | 将对象组合成树形结构以表示"部分-整体"的层次结构。 | 处理树形数据。如:文件系统、公司组织架构。 |
| 装饰器 (Decorator) | 动态地给一个对象添加一些额外的职责。 | 比继承更灵活。Java IO 流(BufferedInputStream)是经典案例。 |
| 外观 (Facade) | 为子系统中的一组接口提供一个一致的界面。 | 封装复杂性。就像微服务里的 API 网关,一站式解决。 |
| 享元 (Flyweight) | 运用共享技术有效地支持大量细粒度的对象。 | 性能优化神器。Java 的 String 常量池、整型缓存。 |
| 代理 (Proxy) | 为其他对象提供一种代理以控制对这个对象的访问。 | Spring AOP 的基石。用于日志、权限控制、事务管理。 |
三、 行为型模式 (Behavioral Patterns)
核心: 处理对象之间的通信、职责分配和算法的运行时切换。
| 模式 | 核心意图 | 资深工程师点评 |
|---|---|---|
| 策略 (Strategy) | 定义一系列算法,把它们一个个封装起来,并使它们可相互替换。 | 消除 if-else 的首选。RocketMQ 的负载均衡算法。 |
| 观察者 (Observer) | 定义对象间的一种一对多的依赖关系。 | 事件驱动架构的核心。Spring Event、MQ 消费本质都是它。 |
| 模板方法 (Template Method) | 定义算法骨架,将某些步骤延迟到子类中实现。 | 框架的基石。Spring 的 JdbcTemplate 或 RedisTemplate。 |
| 责任链 (Chain of Responsibility) | 使多个对象都有机会处理请求,直到有对象处理为止。 | 拦截器、过滤器。如:Servlet Filter、Dubbo Filter。 |
| 状态 (State) | 允许一个对象在其内部状态改变时改变它的行为。 | 复杂的订单状态流转(待支付 -> 待发货 -> 待评价)。 |
| 迭代器 (Iterator) | 提供一种方法顺序访问一个聚合对象中各个元素。 | Java Collection 框架的标准。 |
| 中介者 (Mediator) | 用一个中介对象来封装一系列的对象交互。 | 将"网状依赖"变为"星状依赖"。MVC 里的 Controller 就是中介。 |
| 命令 (Command) | 将一个请求封装为一个对象,从而使你可用不同的请求对客户进行参数化。 | 实现"撤回(Undo)"操作、任务队列化。 |
| 备忘录 (Memento) | 在不破坏封装性的前提下,捕获一个对象的内部状态并在外部保存。 | 游戏存档、代码编辑器里的撤销功能。 |
| 解释器 (Interpreter) | 给定一个语言,定义它的文法的一种表示。 | 自定义 DSL 语言。如:Spring EL 表达式解析。 |
| 访问者 (Visitor) | 表示一个作用于某对象结构中的各元素的操作。 | 最复杂的模式。用于数据结构和操作分离,常见于编译器开发。 |
常见的设计模式
单例模式
单例模式(Singleton Pattern)是设计模式中最简单但也最容易被误用的模式之一。在分布式系统(如 RocketMQ)或框架(如 Spring)的底层开发中,单例模式随处可见,用于管理全局状态、配置信息或高开销的资源池。
定义: 确保一个类只有一个实例,并提供一个全局访问点来访问该实例。
核心意图:
-
控制资源的使用:通过线程池、数据库连接池等限制资源消耗。
-
确保逻辑正确性:某些业务逻辑要求全局唯一性(如序号生成器、配置管理)。
-
减少开销:避免频繁创建和销毁重量级对象。
单例模式的六种实现方式
单例模式的实现演进过程,本质上是在 延迟加载(Lazy Loading) 与 线程安全(Thread Safety) 之间做权衡。
① 饿汉式(Eager Initialization)
类加载时就完成了初始化。
-
优点:实现简单,类加载机制保证了绝对的线程安全。
-
缺点:不支持延迟加载,如果对象很大且一直未被使用,会浪费内存。
② 懒汉式(Lazy Initialization - 线程不安全)
在第一次调用 getInstance() 时才创建实例。
- 评价 :在多线程环境下会出现多个实例,严禁在生产中使用。
③ 懒汉式(线程安全 - 方法加锁)
通过 synchronized 关键字修饰获取实例的方法。
- 缺点:性能极差。每次访问都需要获取锁,而实际上只有第一次创建时才需要同步。
④ 双重检查锁(Double-Checked Locking, DCL)
兼顾了性能与线程安全。
java
public class Singleton {
    // 必须使用 volatile 关键字,防止指令重排序
    private static volatile Singleton instance;

    private Singleton() {}

    public static Singleton getInstance() {
        if (instance == null) { // 第一次检查:避免不必要的同步
            synchronized (Singleton.class) {
                if (instance == null) { // 第二次检查:确保只创建一次
                    instance = new Singleton();
                }
            }
        }
        return instance;
    }
}
volatile的作用是防止new Singleton()时发生指令重排。如果不加,可能出现"对象还未初始化完成就被其他线程读取"的情况。
第一次检查(Check 1) :为了提高效率,避免不必要的同步 。在单例模式中,synchronized 锁的开销是比较大的。实际上,我们只需要在第一次创建对象时 进行同步。一旦对象创建完成,后续的所有调用都只需要直接返回 instance 即可。
如果少了会怎么样?
-
后果 :程序依然是线程安全的,但性能会极度退化。
-
现象 :每一次调用
getInstance()都会进入锁竞争。在高并发场景下(如 RocketMQ 消息处理逻辑中),大量线程会在这里阻塞排队,导致 CPU 的上下文切换开销飙升,系统吞吐量大幅下降。
第二次检查(Check 2):为了防止多次实例化,确保单例的唯一性。
-
假设线程 A 和线程 B 同时执行。
-
它们都发现
instance == null,于是都通过了 Check 1。 -
线程 A 抢先获得了锁 ,进入
synchronized块,创建了对象并赋值给instance,然后释放锁。 -
此时线程 B 获得锁,进入
synchronized块。 -
关键点 :如果没有 Check 2 ,线程 B 会由于已经通过了 Check 1,而直接再次执行
new Singleton()。
如果少了会怎么样?
-
后果 :单例模式失效,内存中会出现多个实例。
-
现象 :破坏了全局唯一性的业务逻辑。如果这个单例是管理数据库连接池或 RocketMQ 的客户端管理类(
MQClientManager),重复创建会导致连接泄露或状态管理混乱。
为什么必须加 volatile?
即使有了两次检查,如果变量不加 volatile 关键字,这段代码在多核 CPU 下依然是不安全的。
原因:指令重排序(Instruction Reordering) 执行 instance = new Singleton(); 这一行,在 JVM 层面其实分成了三步:
-
分配内存空间。
-
调用构造函数,初始化对象。
-
将
instance引用指向分配的内存地址。
由于编译器或 CPU 的优化,第 2 步和第 3 步可能发生重排序。
-
如果执行顺序变成了 1 --> 3 --> 2:
-
当线程 A 执行完第 3 步(赋值)但还没执行第 2 步(初始化)时,线程 B 恰好执行到 Check 1。
-
线程 B 发现
instance != null(因为它已经指向了内存地址),于是直接返回了。 -
结果 :线程 B 拿到了一个尚未初始化完成 的"半成品"对象,后续调用其方法时会抛出
NullPointerException或产生不可预知的错误。
⑤ 静态内部类(Bill Pugh Singleton)
利用 Java 类加载机制来实现延迟加载和线程安全。
-
原理 :内部类只有在
getInstance()被调用时才会被加载。 -
优点:代码简洁,不涉及锁,性能高。
⑥ 枚举单例(Enum Singleton)
《Effective Java》作者 Joshua Bloch 推荐的方式。
- 优点 :天生线程安全,且能绝对防止反射和序列化破坏单例.
Spring中的单例
设计模式里的单例是类加载器(ClassLoader)级别 的强约束,而 Spring 的单例是容器(IoC Container)级别的逻辑约束。
| 维度 | GoF 设计模式单例 | Spring Bean 单例 (Default Scope) |
|---|---|---|
| 定义范围 | 在同一个 ClassLoader 下,该类仅有一个实例。 | 在同一个 Spring IoC 容器 中,该 Bean 定义仅有一个共享实例。 |
| 控制权 | 由 类本身 控制(通过私有构造函数和静态方法)。 | 由 Spring 容器 控制(通过 BeanDefinition 和容器管理)。 |
| 唯一性 | 绝对唯一(除非使用反射或多个类加载器)。 | 相对唯一。同一个类在不同容器中可以有多个实例。 |
A. 容器限制 vs 类加载器限制
-
GoF 单例 :只要类被加载,它的实例在整个类加载器范围内就是唯一的。
-
Spring 单例 :Spring 保证的是在同一个
ApplicationContext中,根据某个 Bean ID 获取到的对象是同一个。如果你在同一个 JVM 里启动了两个 Spring 容器,那么同一个类的 Bean 在这两个容器中会各有一个实例。
B. 实例化机制
-
GoF 单例:通常通过私有构造函数防止外部创建,由类内部自己负责实例化(如 DCL 或静态内部类)。
-
Spring 单例 :Bean 的构造函数通常是公开的 。Spring 容器利用反射机制创建对象,并将其存入一个内部的
Map<String, Object>(一级缓存)中。
C. 一个类是否可以有多个"单例"?
-
GoF 单例:不可能(除非打破封装)。
-
Spring 单例 :可以 。你可以在 Spring 配置文件中为一个类定义多个不同的 Bean ID(例如
userService1和userService2)。虽然它们是同一个类,但 Spring 会为每个配置创建一个单例实例。
为什么Spring不直接使用设计模式的单例呢?
-
非侵入性:Spring 不需要你修改业务代码(不需要私有构造函数或静态方法),它能把任何普通的 POJO 变成单例管理。
-
灵活性:解耦了"实例的个数"和"类本身"。你可以根据配置决定它是单例(Singleton)还是原型(Prototype),而不需要改动代码。
-
易于测试:GoF 单例很难进行单元测试(Mock 困难),而 Spring 管理的单例 Bean 可以轻松地通过构造函数或 Setter 注入 Mock 对象。
分布式环境中保证单例
传统的 Java 单例模式(GoF 单例)绝对无法保证全局唯一。 只能保证单进程内唯一 ,无法实现跨机器唯一。
单例模式的唯一性仅存在于同一个类加载器(ClassLoader)和同一个 JVM 实例中。在分布式系统中,应用运行在多个节点(多个 JVM)上,每个节点都会拥有自己独立的一个"单例"实例。
-
隔离的内存空间:每个 JVM 进程都有自己独立的堆内存。Node A 的单例对象存储在 A 的堆中,Node B 无法感知其存在。
-
状态不同步:如果你在 Node A 修改了单例的某个成员变量,Node B 里的实例完全不会受影响。
1. 行为单例:分布式锁 (Distributed Lock)
如果你的需求是"在整个集群中,同一时刻只有一个节点能执行某个动作",这是最常用的方案。
-
实现机制:在执行逻辑前,先向公共组件申请锁。
-
常用工具:
-
Redis :利用
SETNX指令或 Redlock 算法。 -
Zookeeper:利用临时顺序节点(Ephemeral Sequential Nodes)实现公平锁。
-
-
应用场景:定时任务触发、全局序号生成、资源初始化。
2. 实例单例:选主机制 (Leader Election)
如果你的需求是"集群中只有一个特定的节点负责某项管理任务",通常采用选主方案。
-
实现机制:所有节点在启动时向协调中心注册。通过某种共识算法(如 Raft、Paxos)或简单的"抢占注册"选出一个 Leader 节点。
-
工作流程:
-
只有 Leader 节点会实例化并运行该单例组件。
-
非 Leader 节点处于 Standby(热备)状态。
-
一旦 Leader 节点宕机,协调中心会感知并触发重新选主。
-
-
应用场景:Kafka 的 Controller、RocketMQ 5.x 的主从自动切换。
3. 逻辑单例:消息队列分区绑定 (Partitioning)
对于处理特定数据的逻辑,可以利用 MQ 的特性在逻辑上实现单例处理。
-
实现机制 :利用 RocketMQ 的 MessageQueue。
-
核心逻辑:
-
一个 Topic 被拆分为多个 MessageQueue。
-
在集群消费模式下,RocketMQ 保证一个 MessageQueue 同一时间只能被同一个 ConsumerGroup 里的一个消费者实例消费。
-
通过顺序消息选择器,将特定 ID 的消息路由到固定的 Queue 中。
-
-
效果:虽然有多个 Consumer 实例,但对于某一份特定数据,始终只有唯一的一个实例在处理它。
4. 状态单例:状态外迁 (Centralized State)
如果你的单例是为了维护一份"全局唯一的状态数据",则应该放弃"对象单例",转而使用"数据中心化"。
-
实现机制:将单例对象中的成员变量移除,转而存储在分布式缓存(Redis)或数据库(DB)中。
-
读写流程:
-
每次需要状态时,从远程存储拉取。
-
修改状态时,利用数据库的乐观锁 或 Redis 的原子指令。
-
-
优势:彻底解决了内存同步问题,且天然支持节点扩容。
使用场景:线程池(Thread Pool)
我们不建议使用 Executors 工具类,因为它隐藏了底层细节。推荐直接使用 ThreadPoolExecutor 进行手动定制。
java
import java.util.concurrent.*;

public class GlobalThreadPool {

    // 1. 线程池核心参数定义
    private static final int CORE_POOL_SIZE = 8;
    private static final int MAX_POOL_SIZE = 16;
    private static final long KEEP_ALIVE_TIME = 60L; // 秒
    private static final int QUEUE_CAPACITY = 1000;

    private ThreadPoolExecutor executor;

    // 2. 私有构造函数:配置线程池
    private GlobalThreadPool() {
        executor = new ThreadPoolExecutor(
                CORE_POOL_SIZE,
                MAX_POOL_SIZE,
                KEEP_ALIVE_TIME,
                TimeUnit.SECONDS,
                new LinkedBlockingQueue<>(QUEUE_CAPACITY),
                new ThreadFactory() {
                    @Override
                    public Thread newThread(Runnable r) {
                        Thread t = new Thread(r);
                        t.setName("global-worker-" + t.getId());
                        return t;
                    }
                },
                new ThreadPoolExecutor.CallerRunsPolicy() // 拒绝策略:由调用者运行
        );
    }

    // 3. 静态内部类:实现单例逻辑
    private static class Holder {
        private static final GlobalThreadPool INSTANCE = new GlobalThreadPool();
    }

    // 4. 全局访问点
    public static GlobalThreadPool getInstance() {
        return Holder.INSTANCE;
    }

    // 5. 提交任务的方法
    public void execute(Runnable task) {
        executor.execute(task);
    }

    // 6. 提交有返回值的任务
    public <T> Future<T> submit(Callable<T> task) {
        return executor.submit(task);
    }
}
在线程池这个场景下,静态内部类比双重检查锁(DCL)更有优势:
-
绝对线程安全 :利用 JVM 加载类的原子性保证,无需手动加锁(
synchronized)。 -
懒加载(Lazy Loading) :
Holder类只有在第一次调用getInstance()时才会被加载。如果应用启动后一直没用到线程池,就不会占用内存。 -
高性能:访问时不需要经过同步锁,性能开销极低。
优雅关闭
单例线程池的生命周期与 JVM 相同,但在系统停机(如热部署或重启)时,如果处理不当,队列中未完成的任务会丢失。
方案:注册 JVM 钩子(Shutdown Hook)
在构造函数中加入以下逻辑,确保停机前尝试处理完剩余任务:
java
Runtime.getRuntime().addShutdownHook(new Thread(() -> {
    System.out.println("正在关闭全局线程池...");
    executor.shutdown(); // 不再接受新任务
    try {
        if (!executor.awaitTermination(30, TimeUnit.SECONDS)) {
            executor.shutdownNow(); // 超过30秒强行关闭
        }
    } catch (InterruptedException e) {
        executor.shutdownNow();
    }
}));
策略模式
策略模式定义了一系列算法,并将每一个算法封装起来,使它们可以相互替换。策略模式让算法的变化独立于使用算法的客户。
核心意图:
-
消除冗长的
if-else或switch语句。 -
解耦:将算法的选择逻辑与具体的执行逻辑分离。
-
符合开闭原则(OCP):增加新逻辑时,不需要修改原有代码,只需增加一个新的策略类。
策略模式通常由三个角色组成:
-
Strategy(策略接口):定义了所有支持算法的公共接口。
-
ConcreteStrategy(具体策略类):实现了策略接口中的具体算法。
-
Context(上下文):持有一个策略对象的引用,负责调用具体的算法。
传统 Java 实现
假设我们有一个支付系统,支持微信、支付宝。
java
// 1. 策略接口
public interface PaymentStrategy {
    void pay(int amount);
}

// 2. 具体策略:微信支付
public class WeChatPay implements PaymentStrategy {
    public void pay(int amount) { System.out.println("使用微信支付:" + amount); }
}

// 3. 具体策略:支付宝
public class AliPay implements PaymentStrategy {
    public void pay(int amount) { System.out.println("使用支付宝支付:" + amount); }
}

// 4. 上下文
public class PaymentContext {
    private PaymentStrategy strategy;
    public PaymentContext(PaymentStrategy strategy) { this.strategy = strategy; }
    public void executePay(int amount) { strategy.pay(amount); }
}
B. Spring 环境下的实现(推荐)
在真实的 Spring 项目中,我们通常结合 工厂模式 + Map 注入,实现彻底的动态分发。
java
@Service
public class PaymentService {
    // Spring 会自动将所有 PaymentStrategy 的实现类注入到这个 Map 中
    // Key 为 Bean 的名称,Value 为实现类
    @Autowired
    private Map<String, PaymentStrategy> strategyMap;

    public void processPayment(String type, int amount) {
        PaymentStrategy strategy = strategyMap.get(type);
        if (strategy == null) throw new RuntimeException("不支持的支付方式");
        strategy.pay(amount);
    }
}
优点:
-
完美避开魔数与多重判断:代码变得清爽、整洁。
-
扩展性极强 :新增策略只需要实现接口并加一个
@Component注解,原有逻辑完全不动。 -
便于单元测试:每个策略都是独立的类,可以单独测试其逻辑。
缺点:
-
类膨胀:策略一多,类也会成倍增长。
-
调用方需要了解策略:使用者必须知道有哪些策略可用,才能进行选择(通常配合工厂模式解决)。
使用场景:布隆过滤器
在布隆过滤器的语境下,策略模式主要解决**哈希函数的"多样性"和"可替换性"**问题。
-
Strategy(策略接口) :
HashStrategy,定义哈希计算的标准。 -
ConcreteStrategy(具体策略) :如
MurmurHashStrategy、GuavaHashStrategy、FNVHashStrategy等。 -
Context(上下文/主类) :
BloomFilterContext,负责管理位数组并调用策略。
第一步:定义哈希策略接口
由于布隆过滤器通常需要多个哈希函数来降低冲突,我们可以让策略返回一个哈希值的数组,或者根据索引生成不同的哈希值。
java
public interface HashStrategy {
    /**
     * 根据输入数据生成多个哈希索引
     * @param data 原始数据
     * @param k 哈希函数的个数
     * @param m 位数组的长度
     * @return 位数组中的索引位置
     */
    int[] computeIndices(String data, int k, int m);
}
第二步:实现具体策略
对于追求高性能的场景,MurmurHash3 是业界的标准选择(如 Guava 和 Redis 都在用)。
java
// MurmurHash3 实现策略
public class Murmur3HashStrategy implements HashStrategy {
    @Override
    public int[] computeIndices(String data, int k, int m) {
        int[] indices = new int[k];
        // 技巧:利用 MurmurHash 生成两个 64 位哈希值,模拟出 K 个哈希函数
        long hash1 = MurmurHash3.hash64(data.getBytes());
        long hash2 = hash1 >>> 32;

        for (int i = 0; i < k; i++) {
            long combinedHash = hash1 + (i * hash2);
            // 确保结果为正数并取模
            indices[i] = (int) ((combinedHash & Long.MAX_VALUE) % m);
        }
        return indices;
    }
}
第三步:构建布隆过滤器上下文
这里通过组合的方式引入策略。
java
public class BloomFilter<T> {
    private final BitSet bitSet; // 或者使用 Redis BitMap
    private final int bitSize;
    private final int numHashFunctions;
    private final HashStrategy hashStrategy;

    public BloomFilter(int expectedInsertions, double fpp, HashStrategy strategy) {
        this.bitSize = optimalNumOfBits(expectedInsertions, fpp);
        this.numHashFunctions = optimalNumOfHashFunctions(expectedInsertions, bitSize);
        this.bitSet = new BitSet(bitSize);
        this.hashStrategy = strategy;
    }

    public void put(String data) {
        int[] indices = hashStrategy.computeIndices(data, numHashFunctions, bitSize);
        for (int index : indices) {
            bitSet.set(index);
        }
    }

    public boolean mightContain(String data) {
        int[] indices = hashStrategy.computeIndices(data, numHashFunctions, bitSize);
        for (int index : indices) {
            if (!bitSet.get(index)) return false;
        }
        return true;
    }
}
为什么在这个场景用策略模式?(方案优势)
-
哈希碰撞的动态权衡 :在测试阶段,可以轻松通过切换
Murmur3、CityHash或SHA-256来观察不同哈希算法对误判率(FPP)的影响,而不需要改动过滤器主体逻辑。 -
平滑迁移 :如果后期发现现有的哈希策略在特定数据分布下表现不佳,只需新增一个策略类即可,符合开闭原则。
业务场景:物流运输方式选择
在物流领域中,不同的物流运输方式有着不同的费用和时效性。为了方便客户选择最合适的物流方式进行运输,我们需要实现一个物流系统,可以根据客户需求选择最优的物流方式进行运输。(海陆空三种形式)。
在没有使用策略模式之前,我们可能会用到很多if-else语句判断来实现三种物流运输方式的选择:
java
public class LogisticsSystem {
    public static final int TRANSPORT_MODE_AIR = 1;
    public static final int TRANSPORT_MODE_LAND = 2;
    public static final int TRANSPORT_MODE_SEA = 3;

    public double calculateFee(int transportMode, double weight) {
        double fee = 0.0;

        if (transportMode == TRANSPORT_MODE_AIR) {
            fee = weight * 5.0;
        } else if (transportMode == TRANSPORT_MODE_LAND) {
            fee = weight * 2.0;
        } else if (transportMode == TRANSPORT_MODE_SEA) {
            fee = weight * 1.0;
        }

        return fee;
    }
}
主要问题在于,使用if-else分支语句来判断不同的运输方式,这样的代码实现方式几个缺点:
-
代码可读性差:随着运输方式的增多,代码的分支结构会变得越来越复杂,不利于代码的可读性和可维护性。
-
扩展性差:当需要增加新的运输方式时,需要修改原有的代码,并且可能会影响到原有代码的逻辑,不利于系统的扩展性和维护性。
-
代码重复:在if-else分支语句中,存在大量的代码重复,不利于代码的复用和维护。
使用设计模式优化后代码
策略模式+工厂模式
首先,定义一个抽象的运输策略接口TransportStrategy,包含一个calculateFee方法:
java
public interface TransportStrategy {
    double calculateFee(double weight);
}然后,定义三个具体的策略类:AirTransportStrategy、LandTransportStrategy和SeaTransportStrategy,分别实现TransportStrategy接口:
java
public class AirTransportStrategy implements TransportStrategy {
    @Override
    public double calculateFee(double weight) {
        return weight * 5.0;
    }
}

public class LandTransportStrategy implements TransportStrategy {
    @Override
    public double calculateFee(double weight) {
        return weight * 2.0;
    }
}

public class SeaTransportStrategy implements TransportStrategy {
    @Override
    public double calculateFee(double weight) {
        return weight * 1.0;
    }
}接下来,定义一个运输策略工厂 TransportStrategyFactory,用于根据不同的运输方式创建相应的策略对象:
java
public class TransportStrategyFactory {
    public static TransportStrategy createTransportStrategy(int transportMode) {
        switch (transportMode) {
            case LogisticsSystem.TRANSPORT_MODE_AIR:
                return new AirTransportStrategy();
            case LogisticsSystem.TRANSPORT_MODE_LAND:
                return new LandTransportStrategy();
            case LogisticsSystem.TRANSPORT_MODE_SEA:
                return new SeaTransportStrategy();
            default:
                throw new IllegalArgumentException("Invalid transport mode");
        }
    }
}
最后,调用端逻辑:
java
public class LogisticsSystem {
    public static final int TRANSPORT_MODE_AIR = 1;
    public static final int TRANSPORT_MODE_LAND = 2;
    public static final int TRANSPORT_MODE_SEA = 3;

    public double calculateFee(int transportMode, double weight) {
        TransportStrategy strategy = TransportStrategyFactory.createTransportStrategy(transportMode);
        return strategy.calculateFee(weight);
    }
}
这样,我们就成功地使用策略设计模式和工厂模式优化了原有的代码。使用这种方式,我们可以很方便地添加、修改、删除不同的运输策略,而不需要修改原有的代码。
模板模式
在一个方法中定义一个算法的骨架,而将一些步骤延迟到子类中。模板方法使得子类可以在不改变算法结构的情况下,重新定义算法中的某些步骤。
核心意图:
-
封装不变部分,扩展可变部分 :把通用的逻辑抽离出来,把不确定的逻辑留给子类。
-
提取公共代码:减少重复代码,提高代码复用性。
-
行为控制:由父类固定执行流程,子类只需按部就班填充细节。
核心原则:好莱坞原则 (Hollywood Principle) "Don't call us, we'll call you."(别打电话给我们,有需要我们会打给你)。在模板模式中,是父类调用子类的实现,而不是子类调用父类。
模板方法模式主要包含两个角色:
-
抽象类 (Abstract Class):
-
模板方法 (Template Method) :定义算法骨架,通常声明为
final,防止子类修改流程。 -
基本方法 (Primitive Methods):由子类实现。
-
钩子方法 (Hook Methods):父类提供默认实现或空实现,子类决定是否重写以改变算法路径。
-
-
具体类 (Concrete Class):实现父类定义的抽象方法。
模板方法 vs 策略模式
这两者最容易混淆,但侧重点完全不同:
| 维度 | 模板方法模式 (Template) | 策略模式 (Strategy) |
|---|---|---|
| 实现逻辑 | 基于 继承(类级别)。 | 基于 组合(对象级别)。 |
| 控制力 | 父类控制流程,子类填充空隙。 | 客户端选择具体策略,没有固定流程。 |
| 粒度 | 针对算法中的 特定步骤。 | 针对 整个算法 的替换。 |
| 关系强度 | 强耦合(父子类)。 | 弱耦合(上下文与接口)。 |
使用场景:多格式数据导出报表
在实际工作中,最能体现模板模式 价值的场景通常是那些"主干流程高度一致,但个别步骤差异化 "的业务,比如:支付对账、数据导入/导出、审批流控制。
假设公司需要支持将数据库中的交易数据导出为 CSV 和 Excel 两种格式。在没有使用模板模式时,开发者往往会为了快速上线,直接写两个独立的处理器。
java
// CSV导出类
public class CsvExporter {
    public void export() {
        System.out.println("1. 建立数据库连接,查询交易数据...");
        System.out.println("2. [差异] 将数据格式化为 CSV 逗号分隔符形式...");
        System.out.println("3. 开启文件输出流,写入磁盘...");
        System.out.println("4. 记录导出耗时与操作日志...");
    }
}

// Excel导出类
public class ExcelExporter {
    public void export() {
        System.out.println("1. 建立数据库连接,查询交易数据...");
        System.out.println("2. [差异] 调用 Apache POI 库创建 Excel 单元格并设置样式...");
        System.out.println("3. 开启文件输出流,写入磁盘...");
        System.out.println("4. 记录导出耗时与操作日志...");
    }
}
痛点分析
-
代码冗余:步骤 1、3、4 完全一样。如果以后要修改查询逻辑或日志格式,你得在两个类里同步修改,极易漏掉。
-
难以维护:随着导出的格式增多(如增加 PDF、JSON),你会发现系统里充满了这种逻辑高度相似的"孪生类"。
-
缺乏约束:新来的同事可能会漏掉"记录日志"这一步,导致合规性问题。
我们提取出一个抽象父类,规定好导出的"标准动作"。
java
// 1. 抽象骨架类
public abstract class AbstractDataExporter {

    // 模板方法:定义为 final,禁止子类修改算法骨架
    public final void exportReport() {
        queryData();       // 不变步
        formatData();      // 变化步(抽象)
        outputToFile();    // 不变步
        if (shouldCompress()) { // 钩子方法
            compressFile();
        }
        logResult();       // 不变步
    }

    private void queryData() {
        System.out.println("通用:执行 SQL 查询,获取原始数据集。");
    }

    protected abstract void formatData(); // 留给子类实现具体的格式化逻辑

    private void outputToFile() {
        System.out.println("通用:将格式化后的内容写入本地临时文件。");
    }

    protected boolean shouldCompress() { return false; } // 默认不压缩

    private void compressFile() { System.out.println("通用:正在对文件进行 ZIP 压缩..."); }

    private void logResult() {
        System.out.println("通用:记录导出成功日志。");
    }
}
具体的实现类
java
// CSV 实现
public class CsvExporter extends AbstractDataExporter {
    @Override
    protected void formatData() {
        System.out.println("实现:将数据转换为 CSV 文本流。");
    }
}

// Excel 实现
public class ExcelExporter extends AbstractDataExporter {
    @Override
    protected void formatData() {
        System.out.println("实现:使用 POI 构建 Excel 文档并美化单元格。");
    }

    @Override
    protected boolean shouldCompress() { return true; } // 重写钩子:Excel 文件大,需要压缩
}
建造者模式
将一个复杂对象的构建与它的表示分离,使得同样的构建过程可以创建不同的表示。
核心意图:
-
解决"构造函数地狱":当对象参数过多,且很多是可选参数时,避免重载过多的构造函数。
-
分步构建:允许你按照特定的顺序、一步步地设置对象的属性。
-
解耦:将复杂对象的创建过程封装起来,调用者不需要知道内部的装配细节。
-
保证不可变性:通常建造者模式生成的对象是不可变的(没有 Setter),这在并发编程中非常重要。
实现方式:静态内部类
在 Java 生态中,最流行的是通过静态内部类实现的链式调用(Fluent API)。
java
public class Computer {
    // 所有属性均为 final,保证不可变性
    private final String cpu;
    private final String ram;
    private final String gpu; // 可选
    private final String storage;

    // 私有构造函数,只允许 Builder 调用
    private Computer(Builder builder) {
        this.cpu = builder.cpu;
        this.ram = builder.ram;
        this.gpu = builder.gpu;
        this.storage = builder.storage;
    }

    // 静态内部类 Builder
    public static class Builder {
        private String cpu;
        private String ram;
        private String gpu;
        private String storage;

        public Builder cpu(String cpu) {
            this.cpu = cpu;
            return this; // 返回当前对象,实现链式调用
        }

        public Builder ram(String ram) {
            this.ram = ram;
            return this;
        }

        public Builder gpu(String gpu) {
            this.gpu = gpu;
            return this;
        }

        public Builder storage(String storage) {
            this.storage = storage;
            return this;
        }

        // 最终构建方法
        public Computer build() {
            // 可以在这里进行参数校验,比如 cpu 是否为空
            return new Computer(this);
        }
    }
}
客户端调用:
java
Computer myPc = new Computer.Builder()
                    .cpu("Intel i9")
                    .ram("32GB")
                    .storage("2TB SSD") // gpu 是可选的,不传即可
                    .build();
在实际工作中,我们很少手写上述繁琐的代码,而是直接使用 Lombok 注解:
java
@Builder
@Getter
public class User {
    private final String name;
    private final int age;
    private final String email;
}

// 使用:User.builder().name("Gemini").age(1).build();
使用场景:个人信息查询
实习在某社交平台。
-
初期阶段(MVP期) :用户系统只需要处理注册登录。表结构很简单,一个
t_user表搞定,接口getUserInfo返回 5-10 个字段。 -
成长阶段(业务爆发):
-
财富系统接入:多了钻石、金币、余额。
-
荣誉系统接入:多了等级、荣誉值、勋章。
-
社交系统接入:多了礼物记录、称号、粉丝数。
-
-
现状 :原本的
User实体从 10 个字段膨胀到了 80 个甚至更多。
痛点一:查询性能的"木桶效应"
接口内部是串行查询的:
-
查 MySQL 获取基本信息(50ms)。
-
查 Redis 获取实时钻石数量(10ms)。
-
调用荣誉系统 RPC 接口获取称号(100ms)。
-
调用礼物系统获取礼物清单(150ms)。 结果:用户只想看个用户名,接口却因为加载"礼物列表"慢,导致整个页面转圈 300ms+。
痛点二:数据库与缓存的压力
-
大表难题 :
t_user表字段太多,修改任何一个业务都要动这张表,DBA 压力大。 -
缓存穿透与粒度问题:一个大 JSON 存 Redis,只要用户换个"称号",整个用户信息的缓存都要失效。
痛点三:代码维护灾难(上帝类)
UserDTO 成了"上帝类",任何业务线都在往里塞东西。改 A 业务的字段,不小心就把 B 业务的逻辑弄挂了。
核心架构设计:按需聚合器
该方案的核心逻辑是:将枚举值映射为对应的异步查询任务,利用并行执行缩短 RT(响应时间)。
第一步:定义字段枚举
每个枚举值对应一个业务领域。
java
public enum UserProfileField {
    BASE,    // 基本信息(必查)
    ASSET,   // 资产(钻石、金币)
    HONOR,   // 荣誉(称号、等级)
    GIFT;    // 礼物(收到的数量)
}
第二步:聚合逻辑实现(核心)
利用 CompletableFuture 和 Builder 模式,将散落在各个微服务的数据拼装起来。
java
@Service
public class UserInfoAggregator {

    @Autowired
    private BaseService baseService;
    @Autowired
    private AssetService assetService;
    @Autowired
    private HonorService honorService;

    public UserFullDTO getUserInfo(Long userId, List<UserProfileField> fields) {
        // 1. 启动必查任务:BaseProfile
        CompletableFuture<BaseProfile> baseFuture = CompletableFuture.supplyAsync(
                () -> baseService.queryBase(userId));

        // 2. 根据枚举动态启动可选任务
        CompletableFuture<AssetProfile> assetFuture = null;
        if (fields.contains(UserProfileField.ASSET)) {
            assetFuture = CompletableFuture.supplyAsync(() -> assetService.queryAsset(userId));
        }

        CompletableFuture<HonorProfile> honorFuture = null;
        if (fields.contains(UserProfileField.HONOR)) {
            honorFuture = CompletableFuture.supplyAsync(() -> honorService.queryHonor(userId));
        }

        // 3. 等待所有任务完成(注意:这里可以设置统一超时时间)
        CompletableFuture.allOf(
                baseFuture,
                assetFuture != null ? assetFuture : CompletableFuture.completedFuture(null),
                honorFuture != null ? honorFuture : CompletableFuture.completedFuture(null)
        ).join();

        // 4. 使用 Builder 模式优雅组装结果
        return UserFullDTO.builder()
                .base(baseFuture.join())
                .asset(assetFuture != null ? assetFuture.join() : null)
                .honor(honorFuture != null ? honorFuture.join() : null)
                .build();
    }
}
① 异常降级(Fail-safe)
场景 :如果 HonorProfile(荣誉服务)挂了,查询接口应该报错吗? 优化:不应该。荣誉信息是非核心业务。
- 实现 :在
CompletableFuture中使用.exceptionally(ex -> null)。即使荣誉服务异常,接口依然能返回基础信息和资产,只是荣誉字段为空。
② 自定义线程池隔离
场景 :如果所有的查询都共用默认的 ForkJoinPool,一旦某个下游服务变慢,会把整个系统的线程池占满。 优化 :为你这个聚合业务定义一个独立的单例线程池。
- 实现 :
supplyAsync(task, myCustomExecutor)。这样即便用户信息查询流量暴增,也不会影响到核心的登录或支付逻辑。
③ 性能监控的"木桶效应"
场景 :如何知道哪个微服务拖慢了整个聚合接口? 优化:在每个异步任务前后打点埋点。
- 实现 :记录每个子任务的耗时,通过监控发现 RT(响应时间)的瓶颈。你会发现整个接口的 RT 总是等于
Max(各子服务耗时),这就是典型的并行聚合特征。
状态模式
允许一个对象在其内部状态改变时改变它的行为。对象看起来好像修改了它的类。
核心意图:
-
行为随状态而变:同一个动作(如"点击支付"),在"待支付"状态下和"已关闭"状态下,其执行逻辑完全不同。
-
状态逻辑解耦:将特定状态相关的逻辑分布到独立的类中,消除巨大的分支判断语句。
-
状态转换自动化:在处理完业务逻辑后,对象可以自动切换到下一个状态。
状态模式通常包含三个核心角色:
-
Context(环境上下文):维护一个当前状态的实例。客户端通过环境类来操作。
-
State(抽象状态接口):定义一个接口,封装与环境类的一个特定状态相关的行为。
-
ConcreteState(具体状态类):实现抽象状态接口,定义在对应状态下的具体行为及状态流转逻辑。
业务场景:币商押金退回
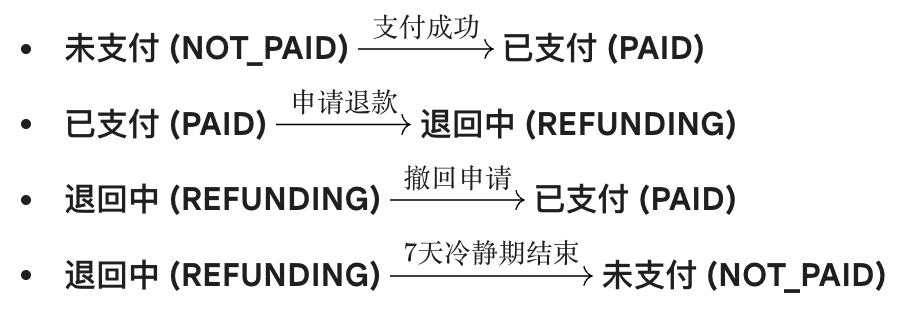
核心实体与状态枚举 (State Pattern)
我们使用枚举来实现状态机,将逻辑内聚。
java
/**
 * 押金订单实体
 */
@Data
public class DepositOrder {
    private Long userId;
    private DepositStatus status;
    private Integer version; // 乐观锁版本号
    private LocalDateTime updateTime;
}

/**
 * 状态机枚举
 */
public enum DepositStatus {

    // 1. 未支付
    NOT_PAID {
        @Override
        public void paySuccess(DepositOrder order) {
            order.setStatus(PAID);
        }
    },

    // 2. 已支付(拥有币商权限)
    PAID {
        @Override
        public void applyRefund(DepositOrder order) {
            order.setStatus(REFUNDING);
        }
    },

    // 3. 退回中(权限冻结,7天冷静期)
    REFUNDING {
        @Override
        public void cancelRefund(DepositOrder order) {
            order.setStatus(PAID);
        }

        @Override
        public void timeoutConfirm(DepositOrder order) {
            order.setStatus(NOT_PAID);
        }
    };

    // 基础方法,默认抛出"非法操作"异常
    public void paySuccess(DepositOrder order) { throw new BizException("当前状态无法处理支付成功"); }
    public void applyRefund(DepositOrder order) { throw new BizException("当前状态无法申请退款"); }
    public void cancelRefund(DepositOrder order) { throw new BizException("当前状态无法取消退款"); }
    public void timeoutConfirm(DepositOrder order) { throw new BizException("当前状态无法处理超时退款"); }
}
2. Redis 频次锁工具类 (Anti-Shake)
使用简单的 Redis 指令实现 10s 防抖。
java
@Component
public class RedisLockProvider {
    @Autowired
    private StringRedisTemplate redisTemplate;

    private static final String LOCK_PREFIX = "lock:deposit:";

    public boolean tryLock(Long userId, String action, int seconds) {
        String key = LOCK_PREFIX + action + ":" + userId;
        // SET key value EX seconds NX
        Boolean success = redisTemplate.opsForValue()
                .setIfAbsent(key, "1", Duration.ofSeconds(seconds));
        return Boolean.TRUE.equals(success);
    }

    public void unlock(Long userId, String action) {
        redisTemplate.delete(LOCK_PREFIX + action + ":" + userId);
    }
}
核心业务服务 (Service Layer)
这里整合了频次锁、事务管理、状态机、以及延迟任务。
java
@Service
@Slf4j
public class DepositServiceImpl implements DepositService {

    @Autowired
    private DepositMapper depositMapper;
    @Autowired
    private RedisLockProvider lockProvider;
    @Autowired
    private RocketMQTemplate rocketMQTemplate; // 假设使用 RocketMQ

    /**
     * 申请退回押金
     */
    @Transactional(rollbackFor = Exception.class)
    public void applyRefund(Long userId) {
        // 1. 频次锁防抖 (10s)
        if (!lockProvider.tryLock(userId, "APPLY", 10)) {
            throw new BizException("操作频繁,请10秒后再试");
        }

        try {
            // 2. 加载数据(带版本号)
            DepositOrder order = depositMapper.selectByUserId(userId);
            if (order == null) throw new BizException("订单不存在");

            // 3. 执行状态转换逻辑 (PAID -> REFUNDING)
            order.getStatus().applyRefund(order);

            // 4. 乐观锁写入数据库
            int rows = depositMapper.updateWithVersion(order);
            if (rows == 0) throw new ConcurrentModificationException("数据已被修改,请重试");

            // 5. 权限处理:调用外部服务冻结币商转账能力
            // permissionService.freeze(userId);

            // 6. 发送7天延迟消息,处理自动退款
            // RocketMQ 延迟级别:1s 5s 10s 30s 1m 2m 3m 4m 5m 6m 7m 8m 9m 10m 20m 30m 1h 2h
            // 注意:真实业务中7天通常使用定时任务或专门的延迟队列插件
            sendDelayMessage(userId, 7 * 24 * 60 * 60);

        } catch (Exception e) {
            lockProvider.unlock(userId, "APPLY"); // 失败则提前解锁
            throw e;
        }
    }

    /**
     * 取消退回申请(反悔)
     */
    @Transactional(rollbackFor = Exception.class)
    public void cancelRefund(Long userId) {
        // 同样增加 10s 防抖
        if (!lockProvider.tryLock(userId, "CANCEL", 10)) {
            throw new BizException("操作频繁,请稍后再试");
        }

        DepositOrder order = depositMapper.selectByUserId(userId);

        // 执行状态转换 (REFUNDING -> PAID)
        order.getStatus().cancelRefund(order);

        depositMapper.updateWithVersion(order);

        // 恢复权限逻辑...
    }
}
4. 延迟任务处理 (Consumer)
处理 7 天后的"自动终态"逻辑。
java
@Component
@RocketMQMessageListener(topic = "DEPOSIT_TIMEOUT", consumerGroup = "deposit_group")
public class DepositTimeoutConsumer implements RocketMQListener<Long> {

    @Autowired
    private DepositMapper depositMapper;

    @Override
    public void onMessage(Long userId) {
        // 1. 重新查询当前最新状态
        DepositOrder order = depositMapper.selectByUserId(userId);

        // 2. 只有当前还是"退回中"才处理
        if (order != null && order.getStatus() == DepositStatus.REFUNDING) {
            log.info("用户 {} 7天冷静期已到,开始执行最终退款逻辑", userId);

            // 3. 状态转换 (REFUNDING -> NOT_PAID)
            order.getStatus().timeoutConfirm(order);

            // 4. 持久化并触发真实退款(原路退回)
            depositMapper.updateWithVersion(order);
            // refundProcessor.execute(order);
        } else {
            log.info("用户 {} 已手动取消退款或状态已变,跳过延迟处理", userId);
        }
    }
}
设计模式的体现
JDK
一、 创建型模式 (Creational Patterns)
1. 单例模式 (Singleton)
-
体现:
java.lang.Runtime#getRuntime()、java.awt.Desktop#getDesktop()。 -
深度理解: 比如
Runtime类,每个 Java 应用只有一个运行环境,所以它采用了饿汉式单例,确保全局唯一。
2. 建造者模式 (Builder)
-
体现:
java.lang.StringBuilder#append()、java.lang.StringBuffer、java.nio.ByteBuffer。 -
深度理解: 通过链式调用分步构建复杂字符串。虽然它没有严格的
build()方法返回新对象,但其"分步装配"的理念是完全一致的。
3. 工厂方法模式 (Factory Method)
-
体现:
java.util.Calendar#getInstance()、java.text.NumberFormat#getInstance()。 -
深度理解: 屏蔽了具体子类的实例化细节。比如
Calendar.getInstance()会根据你的时区和语言环境返回具体的子类实现(如GregorianCalendar)。
4. 原型 (Prototype)
- 体现:java.lang.Object#clone()
- 深度理解 :它是 Java 语言原生支持的模式。通过
Cloneable接口和clone()方法,直接在内存中进行二进制流拷贝,规避了复杂的构造过程。
5. 抽象工厂 (Abstract Factory)
- 体现:javax.xml.parsers.DocumentBuilderFactory
- 深度理解 :这种工厂不仅能产生一个对象,还能产生一族。比如生成的
DocumentBuilder本身又是一个能处理多种 XML 结构的工厂环境。
二、 结构型模式 (Structural Patterns)
1. 装饰器模式 (Decorator)
-
体现: 整个
java.io包。 -
典型:
new BufferedInputStream(new FileInputStream(file))。 -
深度理解: 装饰器允许你在不改变原有类结构的情况下,动态地给对象增加功能(如增加缓冲区)。
2. 适配器模式 (Adapter)
-
体现:
java.util.Arrays#asList()、java.io.InputStreamReader(InputStream)。 -
深度理解:
InputStreamReader是将"字节流"适配为"字符流"的桥梁。它让原本不兼容的接口可以协同工作。
3. 享元模式 (Flyweight)
-
体现:
java.lang.Integer#valueOf(int)、java.lang.String常量池。 -
深度理解:
Integer会缓存 -128 到 127 之间的数值对象。当你调用valueOf时,如果在缓存范围内,直接返回旧对象,减少内存开销。
4. 桥接模式 (Bridge)
-
体现: JDBC (Java Database Connectivity)。
-
深度理解: 这是桥接模式最经典的工业级应用。
DriverManager与Driver接口之间就是桥接。-
抽象部分 :JDBC API(供开发者使用的
Connection,Statement)。 -
实现部分:各种数据库驱动(MySQL Driver, Oracle Driver)。
-
意义:这两者可以独立演进,你换个数据库驱动,代码逻辑完全不用动。
-
5. 组合模式 (Composite)
-
体现:
java.awt.Container和java.awt.Component。 -
深度理解: 容器(Container)本身就是一个组件(Component),但它又能包含其他组件。这形成了一个树形结构,让用户可以一致地对待单个对象和组合对象。
6. 外观模式 (Facade)
-
体现:
java.util.logging包。 -
深度理解: 尽管日志系统内部非常复杂(包含 Handler, Filter, Formatter),但它为用户提供了一个极其简单的
Logger类,一站式解决所有记录问题。
三、 行为型模式 (Behavioral Patterns)
这类模式关注"对象间的通信"和"职责分配"。
1. 策略模式 (Strategy)
-
体现:
java.util.Comparator#compare()。 -
深度理解: 在
Collections.sort(list, comparator)中,Comparator就是一个策略。你可以根据需要传入不同的比较算法,而不需要修改排序方法本身。
2. 模板方法模式 (Template Method)
-
体现:
java.util.AbstractList、java.util.AbstractMap、java.util.concurrent.locks.AbstractQueuedSynchronizer(AQS)。 -
深度理解: AQS 定义了同步状态的获取和释放流程(骨架),而具体的加锁逻辑由子类(如
ReentrantLock)实现。
3. 迭代器模式 (Iterator)
-
体现:
java.util.Iterator。 -
深度理解: 这是 JDK 中存在感最强的模式之一。它提供了一种统一的方法来遍历各种集合(List, Set),而无需暴露集合的内部结构。
4. 责任链模式 (Chain of Responsibility)
-
体现:
java.util.logging.Logger#log()、ClassLoader的双亲委派模型。 -
深度理解:
ClassLoader在加载类时,先交给父类处理,父类处理不了再自己处理,这就是典型的责任链传递。
5. 命令模式 (Command)
-
体现:
java.lang.Runnable。 -
深度理解: 一个
Runnable实例就是一个"命令"。它把请求封装成对象,你可以将其丢进线程池执行、放入队列、或者记录日志,实现了"发送者(Thread)"与"接收者(具体的业务逻辑)"的完全解耦。
6. 中介者模式 (Mediator)
-
体现:
java.util.Timer。 -
深度理解:
Timer类就像一个调度中心,它协调TimerTask(执行者)和后台线程。各个任务之间互不感知,所有协作都通过Timer这个中介完成。
7. 解释器模式 (Interpreter)
-
体现:
java.util.regex.Pattern。 -
深度理解: 正则表达式就是一种"小语言"。
Pattern类将正则表达式字符串解析成一套语法树,并执行匹配逻辑。
8. 访问者模式 (Visitor)
-
体现:
java.nio.file.FileVisitor。 -
深度理解: 当你遍历文件夹时,
FileVisitor定义了访问文件和文件夹的行为(visitFile,preVisitDirectory),而文件树的遍历逻辑(Files.walkFileTree)保持不变。
9. 备忘录模式 (Memento)
-
体现:
java.io.Serializable。 -
深度理解: 通过序列化机制,你可以捕获对象的内部状态并将其保存到磁盘,之后通过反序列化"恢复"到之前的状态,这本质上就是备忘录模式的工程化体现。
Spring
一、 创建型模式 (Creational Patterns)
Spring 作为一个"大管家",最擅长的就是如何优雅地创建和管理对象。
1. 单例模式 (Singleton)
-
体现: Spring Bean 的默认 Scope(作用域)。
-
深度解析: Spring 的单例与传统的
getInstance()不同,它是通过 单例池 (Singleton Objects Cache) 管理的。Spring 容器确保对于每个 Bean ID,在同一个 IoC 容器中只存在一个共享的实例。 -
优点: 减少了频繁创建对象的开销,减轻了 GC 压力。
2. 工厂模式 (Factory Method / Abstract Factory)
-
体现:
BeanFactory和ApplicationContext。 -
深度解析: * 工厂方法:
FactoryBean接口。如果你想自定义某个复杂对象的创建过程,可以实现这个接口。- 抽象工厂:
BeanFactory是最顶层的抽象工厂,它定义了如何获取 Bean 的标准,而具体的实现类负责生产不同种类的对象。
- 抽象工厂:
3. 原型模式 (Prototype)
-
体现:
@Scope("prototype")。 -
深度解析: 当你需要每次从容器获取 Bean 时都返回一个新的实例时,Spring 就会使用原型模式。它通过内存拷贝(克隆)或重新执行初始化逻辑来生成新对象。
二、 结构型模式 (Structural Patterns)
这是 Spring 实现 AOP(面向切面编程) 和 MVC 的基石。
1. 代理模式 (Proxy) ------ Spring 的灵魂
-
体现: Spring AOP。
-
深度解析: Spring 提供了两种动态代理实现:
-
JDK 动态代理: 针对有接口的类。
-
CGLIB 字节码增强: 针对没有接口的类(通过继承实现)。
-
-
应用场景: 声明式事务
@Transactional、日志切面、权限校验。
2. 适配器模式 (Adapter)
-
体现: Spring MVC 中的
HandlerAdapter。 -
深度解析:
DispatcherServlet需要调用各种不同类型的控制器(Controller、HttpRequestHandler、Servlet)。为了统一调用接口,Spring 为每种控制器都准备了一个适配器。 -
优点: 极大地增强了 Spring MVC 的扩展性。
3. 装饰器模式 (Decorator)
-
体现:
TransactionAwareCacheDecorator。 -
深度解析: 在集成缓存(Cache)时,Spring 使用装饰器来确保缓存的操作与事务同步。只有当事务提交后,装饰器才会去更新缓存。
三、 行为型模式 (Behavioral Patterns)
这些模式赋予了 Spring 强大的灵活性和可扩展性。
1. 模板方法模式 (Template Method)
-
体现:
JdbcTemplate、RestTemplate、TransactionTemplate。 -
深度解析: 这是 Spring 中最常用的模式。父类封装了繁琐的固定流程 (如:获取连接、异常处理、释放连接),而将变化的部分(如:SQL 执行、结果集映射)通过回调或抽象方法留给开发者。
2. 策略模式 (Strategy)
-
体现:
Resource接口、InstantiationStrategy。 -
深度解析: *
Resource接口有多种实现:UrlResource、ClassPathResource、FileSystemResource。Spring 根据资源的协议头(如classpath:或http:)自动选择对应的加载策略。- Bean 的实例化策略:是反射创建还是 CGLIB 创建,也是一种策略切换。
3. 观察者模式 (Observer)
-
体现: Spring 事件机制 (
ApplicationEvent,ApplicationListener)。 -
深度解析: 典型的发布-订阅模型。当容器启动完成或刷新时,会发布一个
ContextRefreshedEvent,所有监听该事件的 Bean 都会被触发。
4. 责任链模式 (Chain of Responsibility)
-
体现:
HandlerInterceptor(拦截器)和Filter(过滤器)。 -
深度解析: 请求在进入 Controller 之前,会经过一连串的拦截器链。每个拦截器都可以决定是拦截请求还是传递给下一个拦截器。