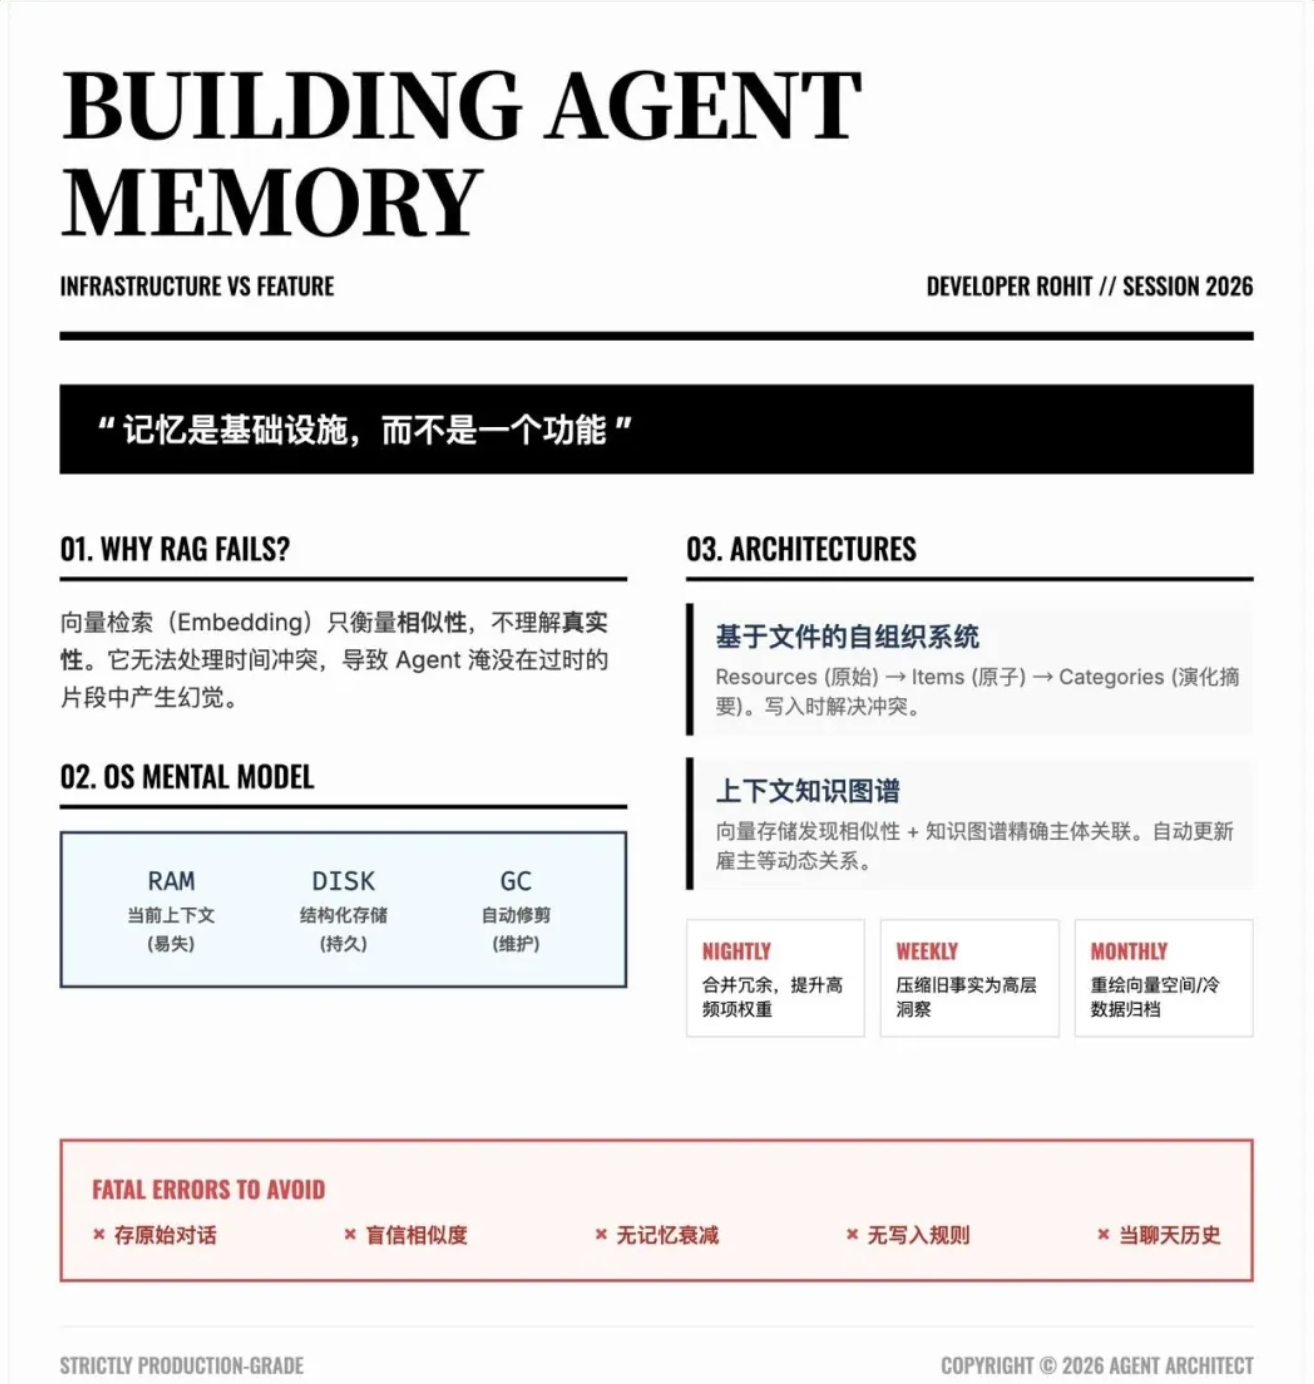
这是前些天在x上面讨论的问题。开发者 Rohit 面试失败后,开始深入研究 Agent 记忆系统,最终构建出生产级方案。核心洞察:记忆是基础设施,不是功能。
标准方案为何失效
方案一:对话历史塞入上下文
10 轮对话后,上下文窗口填满,系统开始截断旧消息。结果?Agent 忘记了用户是素食者。
问题根源:对话历史不是记忆,只是聊天日志。
方案二:向量数据库检索
两周后,数据库积累了 500 条记录。用户问"我的工作情况",向量检索返回 12 段矛盾片段。Agent 幻觉出错误的综合答案。
问题根源:Embedding 衡量的是相似性,不是真实性。向量数据库不理解时间、上下文或更新。
短期记忆:Checkpointing
每个 Agent 作为状态机运行。检查点是特定时刻整个状态的快照,提供:
- 确定性重放:从任意检查点恢复执行
- 崩溃恢复:Agent 异常终止后可重启
- 回溯调试:追溯决策过程
长期记忆架构
架构 A:基于文件的自组织系统
三层结构:
- Resources:原始数据,不可变,带时间戳
- Items:原子事实(如"用户偏好 Python")
- Categories:演化摘要(如 work_preferences.md)
写入时主动处理:新信息不只是归档,而是编织进现有摘要。用户转向 Rust?系统重写档案替换旧偏好,自动解决矛盾。
读取时分层检索:先拉摘要,问 LLM"够了吗",不够再下钻到具体事实。
架构 B:上下文图谱
混合结构:
- 向量存储用于发现相似文本
- 知识图谱用于精确的主体-谓词-客体关系
冲突解决:用户从 Google 跳槽到 OpenAI?系统识别矛盾,归档旧连接为历史,更新当前雇主。
混合检索:向量搜索 + 图谱遍历并行运行,结果合并。
记忆必须衰减
"永不遗忘"不是"记住每个 Token",而是"记住重要的"。
维护策略:
- 每夜:合并冗余,提升高频访问项优先级
- 每周:压缩旧事实为高层洞察,修剪 90 天未访问的记忆
- 每月:重建 Embedding,调整图谱边权重,归档冷数据
推理时检索
从上下文窗口约束反向工作:
- 用合成查询广泛搜索
- 搜索结果是候选,不是答案
- 相关性评分 × 时间衰减 = 最终排序
- 近期记忆往往击败六个月前的完美匹配
结果:只注入 5-10 条真正有用的记忆。
五个致命错误
- 存原始对话 --- 提取事实,而非转录
- 盲目用 Embedding --- "我爱工作"和"我恨工作"嵌入相似
- 没有衰减 --- Agent 淹没在过去
- 没有写入规则 --- 想写就写,写的是垃圾
- 记忆当聊天历史 --- 聊天历史短暂,记忆是结构化表示
核心心智模型
把 Agent 当操作系统,不是聊天机器人:
- RAM:当前对话的快速易失上下文
- 硬盘:持久化、索引化的知识存储
- 垃圾回收:定期维护,否则系统崩溃
总结
记忆系统的关键在于:不是存储,而是组织和衰减。对话历史是日志,向量检索只是工具,真正的记忆需要结构化、冲突解决和定期维护。
核心原则:记忆是基础设施。像操作系统管理内存一样管理记忆,Agent 才能长期可靠地工作。