视觉-语言多模态大模型
我们正式发布 Seed -VL,这是一款专注于提升多模态理解与推理能力的视觉-语言基础模型。Seed -VL 不仅在视觉和视频理解任务中具有出色表现,还在智能体相关任务及复杂推理挑战中展现优异能力。模型在 60 项公开评测基准中的 38 项取得 SOTA 表现。
模型架构
Seed1.5-VL 包含一个 5.32 亿参数的视觉编码器,以及一个激活参数规模达 200 亿的混合专家(MoE)大语言模型。
模型由以下三个核心组件组成:1)SeedViT:用于对图像和视频进行编码;2)MLP 适配器:将视觉特征投射为多模态 token ;3)大语言模型:用于处理多模态输入并执行推理。
Seed1.5-VL 支持多种分辨率的图像输入,并通过原生分辨率变换(native-resolution transform)确保最大限度保留图像细节。在视频处理方面,我们提出了一种动态帧分辨率采样策略(dynamic frame-resolution sampling strategy),能够根据需要动态调整采样帧率和分辨率。此外,为了增强模型的时间信息感知能力,在每帧图像之前引入了时间戳标记(timestamp token)。
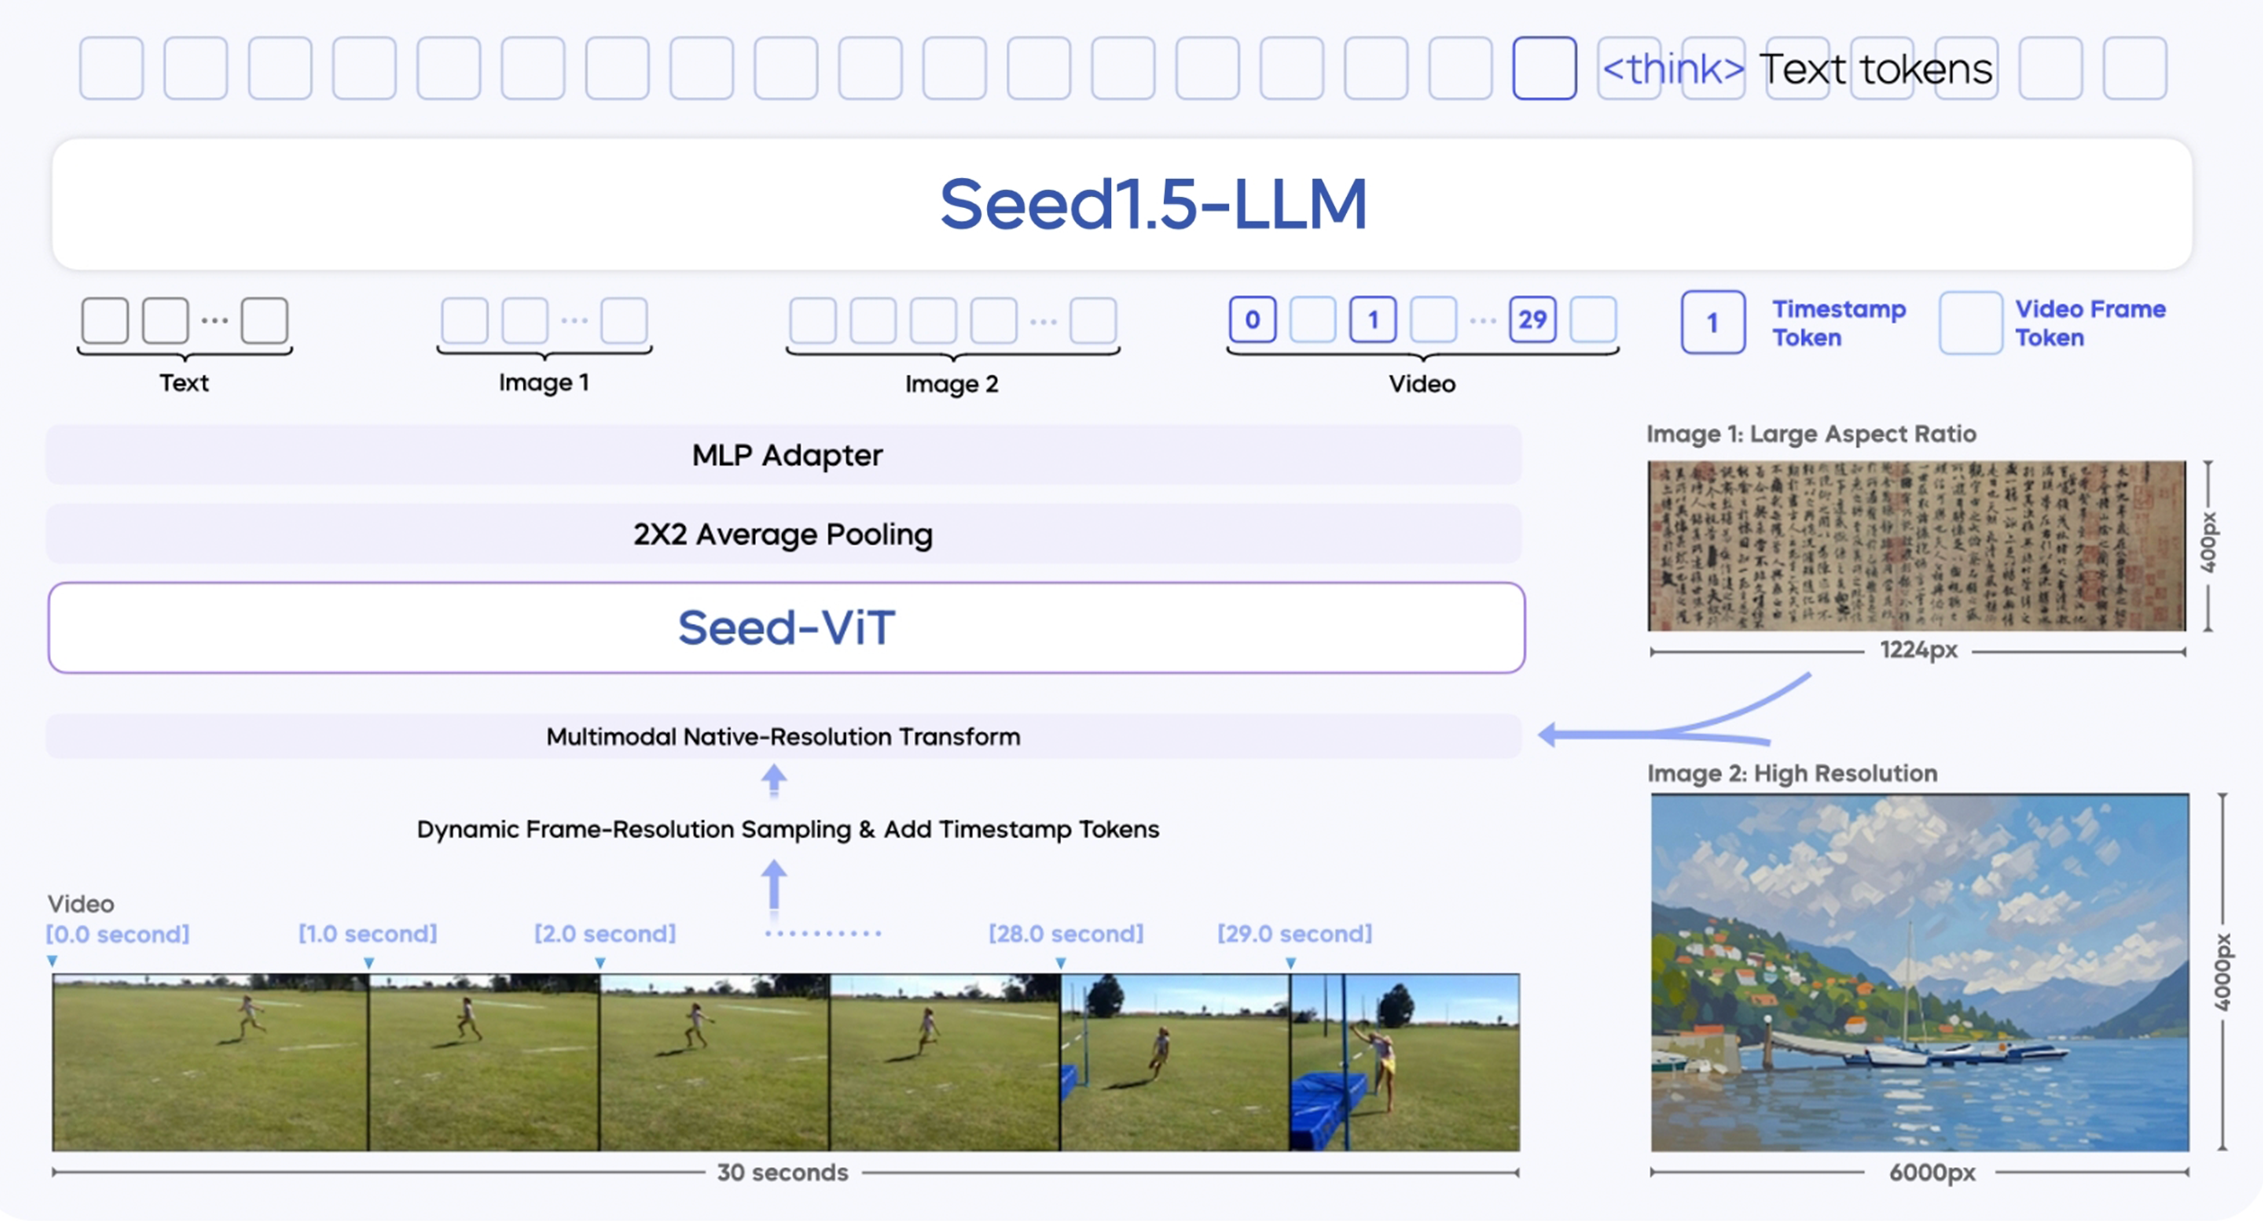
Seed1.5-VL 模型结构图
预训练数据与 Scaling Law
Seed1.5-VL 的预训练语料库包含 3 万亿个多样化且高质量的源标记(source tokens)。这些数据根据模型目标能力的需求进行了分类。
在预训练阶段,我们观察到大多数子类别的数据训练损失与训练标记数量之间遵循幂律关系。此外,某一子类别的训练损失与该类别对应的下游任务评估指标之间呈现对数线性关系(例如:评估指标 ∼ log(训练损失))的趋势,尤其在局部区域内尤为显著。
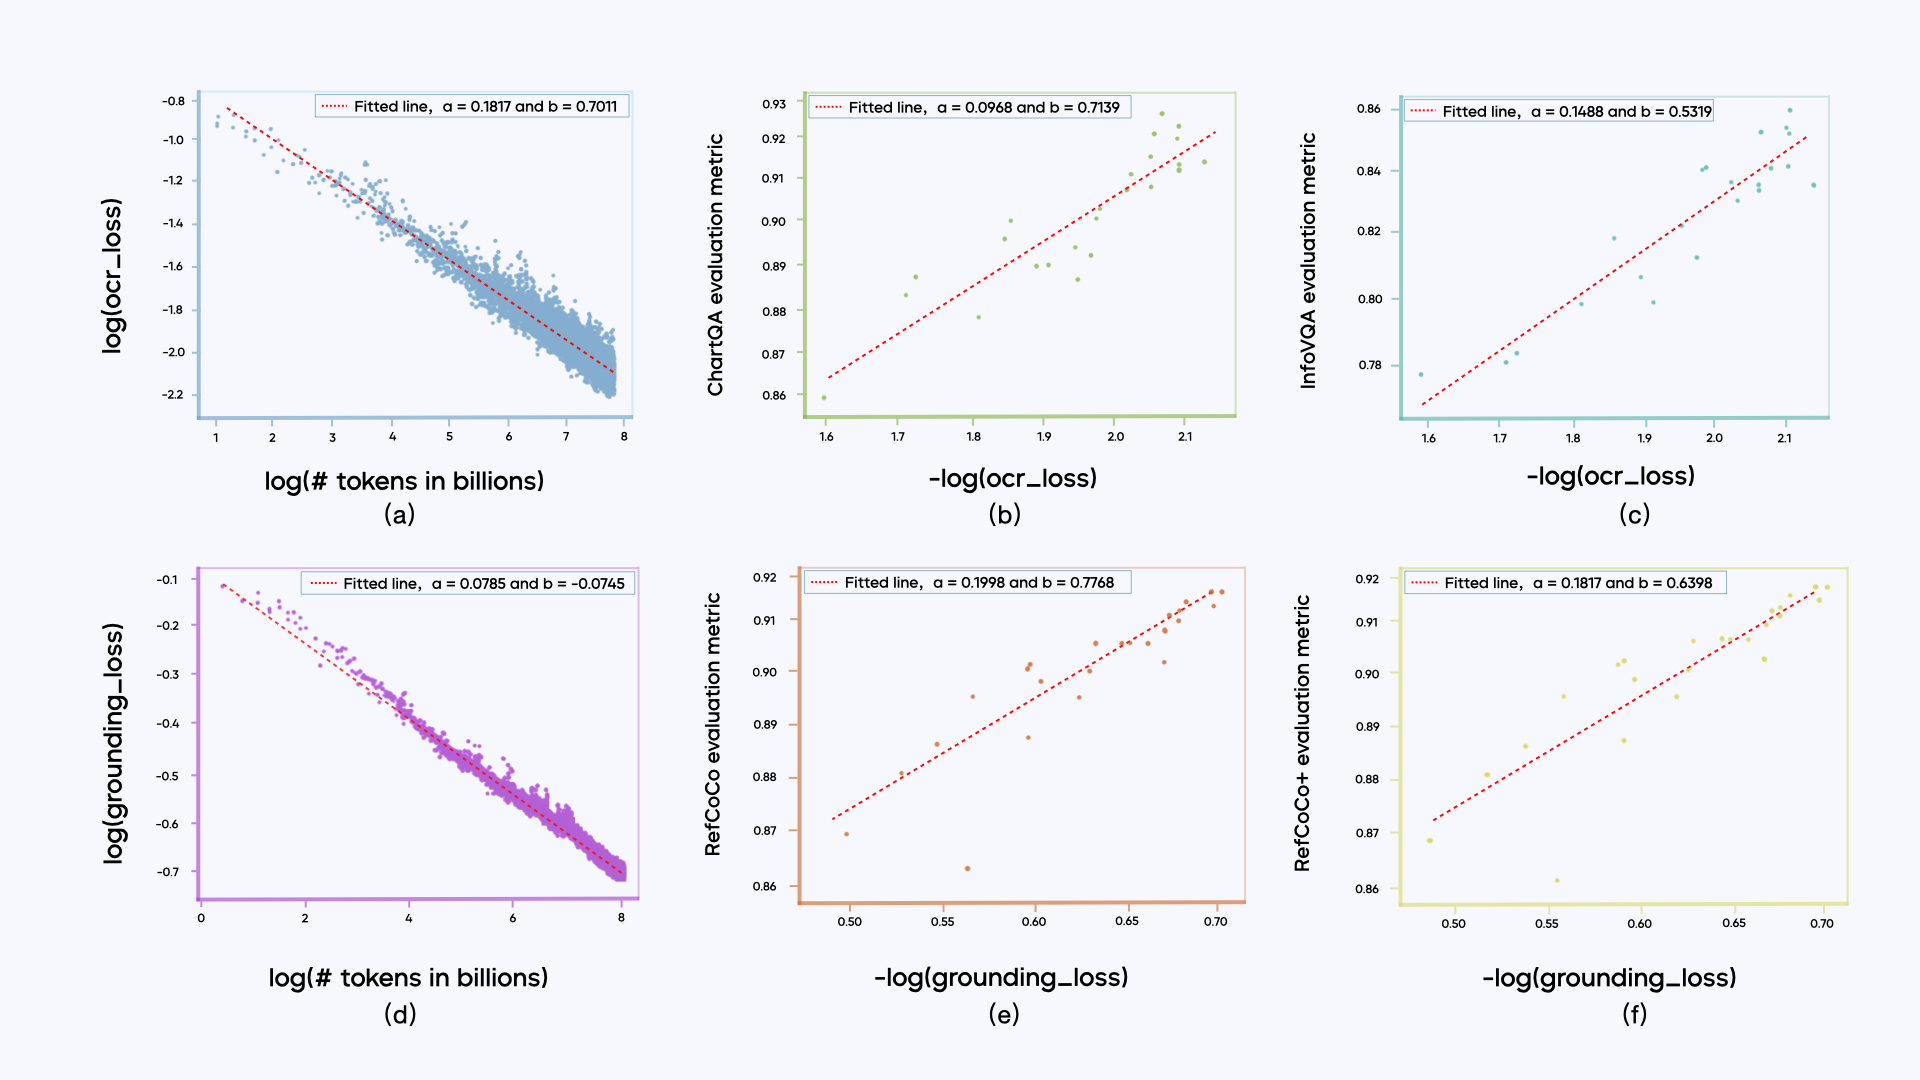
(a) OCR 相关数据集的训练损失随训练标记数量的变化曲线; (b) ChartQA 的 Top-1 准确率随训练损失的变化曲线; (c) InfographicVQA 的 Top-1 准确率随训练损失的变化曲线; (d) 定位(grounding)相关数据集的训练损失随训练标记数量的变化曲线; (e) RefCOCO 的准确率随训练损失的变化曲线; (f) RefCOCO+ 的准确率随训练损失的变化曲线。 需要注意的是,图中所展示的评估指标为模型在预训练后直接获得的性能表现,因此与最终结果(即通过强化学习进一步优化后获得的性能)并不直接可比。
后训练
Seed1.5-VL 的后训练过程采用了结合拒绝采样(rejection sampling)和在线强化学习(online reinforcement learning)的迭代更新方法。我们构建了一条完整的数据 pipeline,用于收集和筛选复杂提示,以增强后训练阶段的数据质量。
强化学习实现的一个关键特点是,监督信号通过奖励模型(reward models)和规则验证器(rule verifiers)仅作用于模型生成的最终输出结果。我们特意避免对模型的详细链式思维推理(chain-of-thought reasoning)过程进行监督。这一区别在插图的右侧部分得到了重点说明。
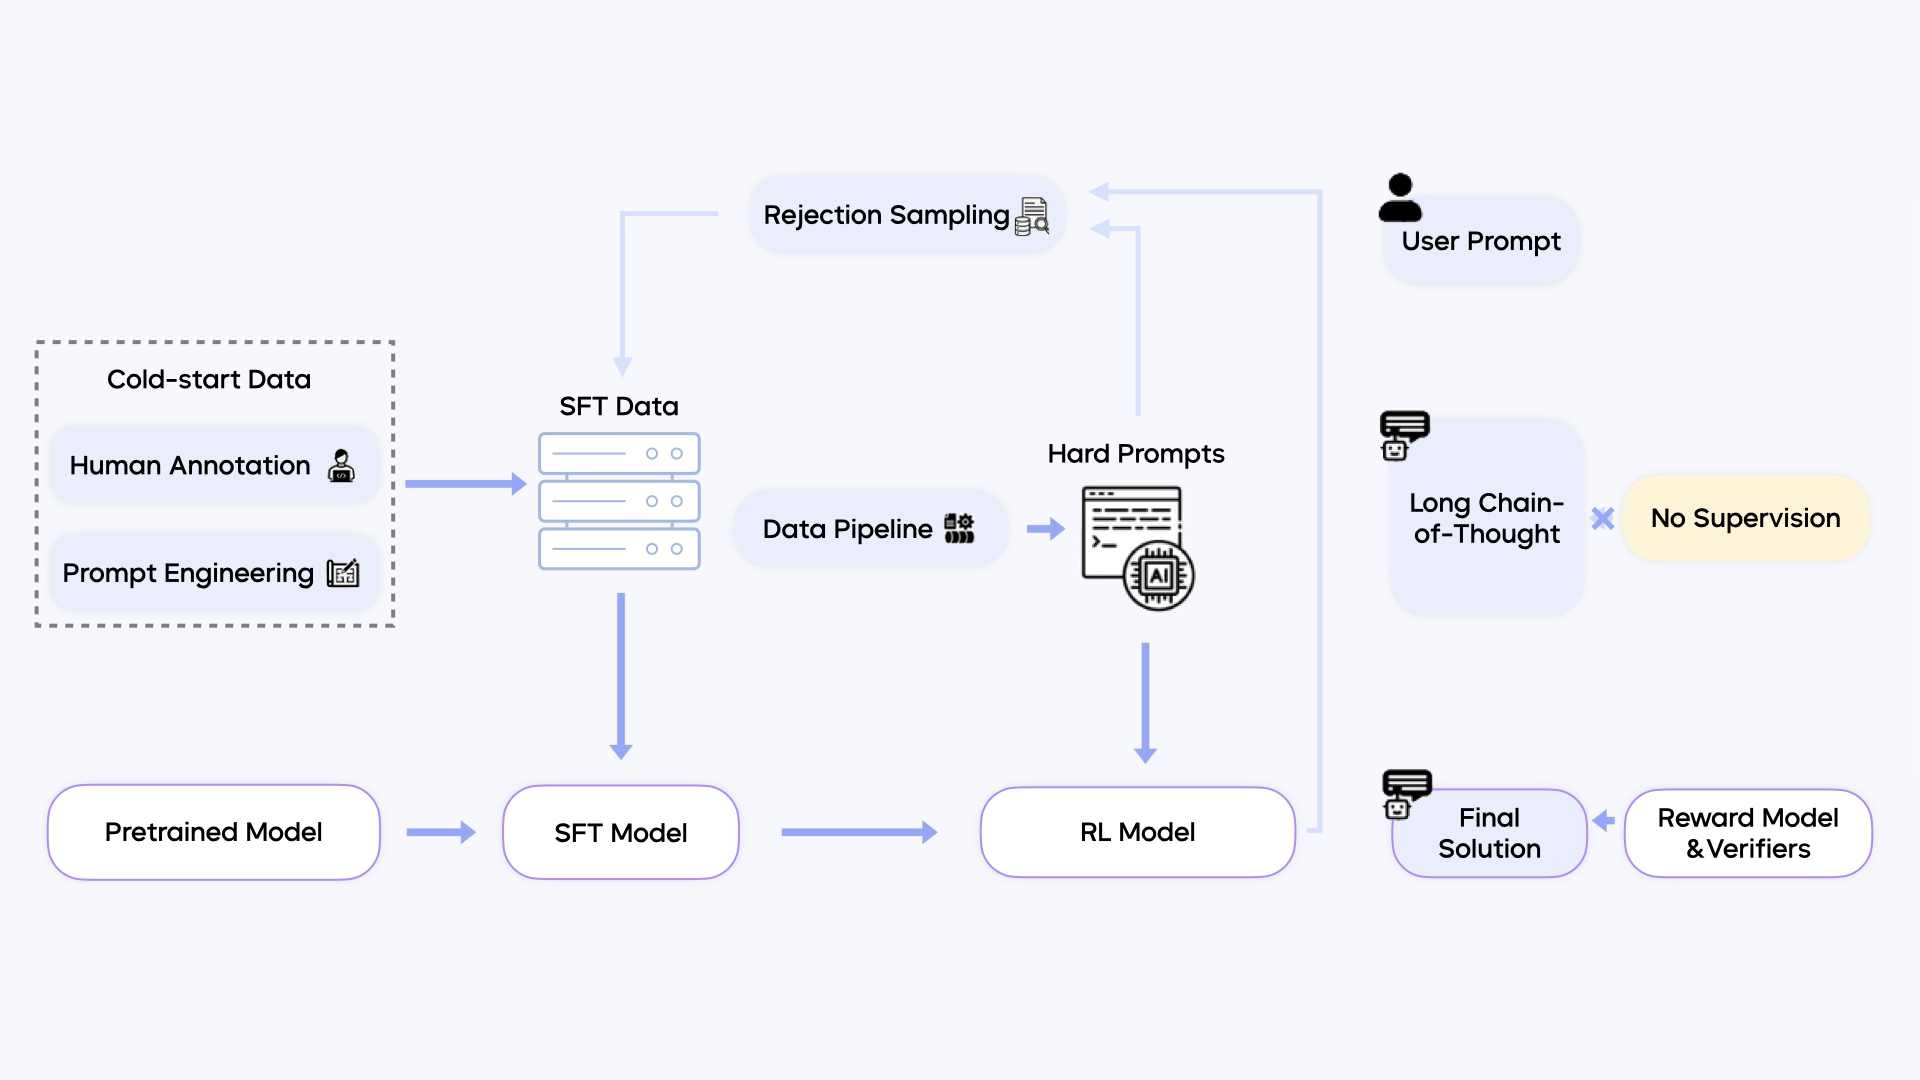
Seed1.5-VL 后训练流程
示例展示
基础感知能力