1. 核心目的
核心目的: 稳定、简单地优化大模型策略;
核心思想: 通过 绝对奖励 计算每个 Token 的好坏,如果 绝对奖励 分数是正的,说明这个 token 好 → 要提高概率,否则降低概率。
核心过程: 通过 "概率比值 + 绝对奖励 + 裁剪" 的方式实现模型的保守更新,既让模型往优势值指引的方向优化,又限制更新幅度防止训练崩溃。
2. 公式讲解

- πθ(atst)\pi_{\theta}(a_t s_t)πθ(atst) :新模型(参数为 θ\thetaθ)在状态 sts_tst 下生成 token ata_tat 的概率(即 πnew(t)\pi_{\text{new}}(t)πnew(t))。
- πθold(at∣st)\pi_{\theta_{\text{old}}}(a_t \mid s_t)πθold(at∣st):旧模型(更新前的快照)在状态 sts_tst 下生成 token ata_tat 的概率(即 πold(t)\pi_{\text{old}}(t)πold(t))。
- rt(θ)r_t(\theta)rt(θ): 概率比值:衡量新模型对这个 token 的生成概率"改了多少"(rt(θ)=πθ(at∣st)πθold(at∣st)r_t(\theta) = \frac{\pi_{\theta}(a_t \mid s_t)}{\pi_{\theta_{\text{old}}}(a_t \mid s_t)}rt(θ)=πθold(at∣st)πθ(at∣st)) 。
- AtA_tAt:绝对优势值,衡量这个 token 好不好(正值表示好,负值表示差),由 RM 和 Critic 网络决定。
- clip(x,1−ϵ,1+ϵ)\text{clip}(x, 1-\epsilon, 1+\epsilon)clip(x,1−ϵ,1+ϵ) :裁剪函数:将 xxx 限制在区间 0.8,1.20.8, 1.20.8,1.2 内(当 ϵ=0.2\epsilon = 0.2ϵ=0.2 时
- −min(...,... )-\min(\dots, \dots)−min(...,...) :取两个目标中的较小值再加负号:最终目标是 最大化对好 token 的奖励 ,同时 最小化对差 token 的惩罚(用于 PPO 的损失函数构造)
关键细节 1:为什么是 min 而不是 max?
一句话就是:选 "更保守的更新方式",防止模型训歪,同时保证模型能够有效地更新参数。
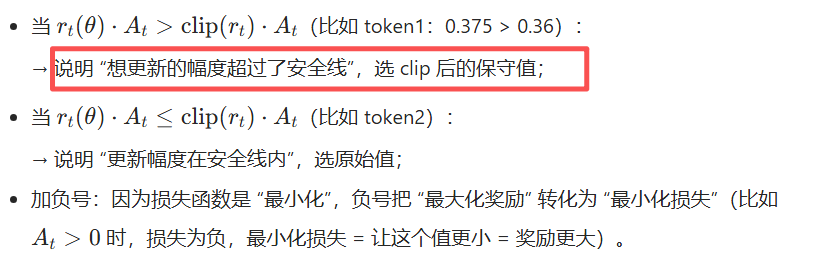
注: 但效果跟GRPO 相比差了很多,因为 GRPO 在 "防止模型训歪" 这方面采用了 KL 散度。(保守并不保守)
关键细节 2:"概率比值" 和 "绝对优势" 的作用是什么?
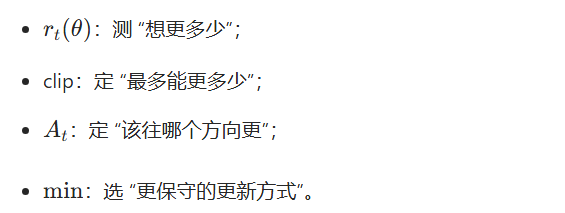
这就是 PPO 从公式到落地的完整逻辑 ------ 核心就一个:"既要学,又要稳,不让模型瞎更新"。(但其实并不稳)
3. PPO 的问题
-
绝对优势对奖励尺度极度敏感:
PPO 的 At=r−VtA_t = r - V_tAt=r−Vt 里,rrr 是 RM 给的 "绝对分数"(比如 0.8、80、800),分数的数值范围直接决定优势值大小。
○ RM 打分范围从 0~1 变成 0~100 → 优势值直接放大 100 倍 → 训练瞬间震荡 / 崩溃;
○ 哪怕 RM 只是微调(比如打分偏严 / 偏松),PPO 都要重新调超参(ε、学习率)。
-
绝对优势依赖 Critic 的 "精准预估":
Critic 是 PPO 的 "命门"------如果 Critic 预估的 VtV_tVt 不准(比如和 RM 打分偏差大),优势值 AtA_tAt 就会失真,模型学错方向。
但训练 Critic 本身就很麻烦:需要和 Actor 同步迭代,还容易出现 "Critic 过拟合""价值偏移",增加了训练复杂度。
-
逐 token 绝对优势放大噪声:
PPO 逐 token 算 AtA_tAt,但 RM 只有整句分数,导致每个 token 的 AtA_tAt 都带着大量噪声(比如一个错 token 会让整句 AtA_tAt 全错),训练效率低。